


Текст написан грамотно, структура на месте, а фактов, которые AI-поиск мог бы извлечь, в нём мало. Причина часто в том, что проверяемых сведений в материале меньше, чем кажется автору: между ними слишком много слов, которые ничего не сообщают. При вычитке это не видно, пока не посчитать, что в каждом абзаце можно проверить.
В лабораторных задачах с большими языковыми моделями (LLM) точность извлечения падала при отвлекающих фрагментах и при факте в середине длинного входа; воду отдельно эти работы не проверяли. Обратная крайность тоже опасна: в одном из экспериментов слишком плотный по лексике контекст ухудшал поиск. Для читателя мера важна не меньше: перегруженный абзац трудно читать подряд.
Дальше разберём определение, как AI-поиск Google подбирает источники, что убирать из текста, как править абзац и как посчитать результат.

- Что такое информационная плотность текста
- Как AI-поиск Google подбирает источники
- Что исследования говорят о лишнем тексте
- Что убирать из текста, а что оставить
- Как повысить плотность сущностей в абзаце
- Как измерить плотность информации в тексте
- Баланс высокой плотности и читабельности
- FAQ по информационной плотности
- Коротко о главном
Что такое информационная плотность текста
В этой статье информационной плотностью (information density) называем количество проверяемых утверждений, названий, чисел и условий на единицу объёма текста.
В плотном абзаце почти каждое предложение сообщает проверяемый факт: какой объект, при каком условии, в каком количестве и на какую дату. В водянистом тот же факт растворён в оценках и повторах. Это дает редактору понимание принципа, по которому абзац можно проверить и поправить.
Плотность информации не равна плотности ключевых слов: доля ключей не говорит, сколько в тексте фактов. Не равна она и краткости, потому что короткий текст может быть пустым, а длинный плотным, если в нём мало повторов. Объём и частота ключей показывают размер текста, а не количество фактов в нём.
В лингвистике информационной плотностью (information density) называют среднее количество информации на единицу речи, например на слог: в исследовании 17 языков (Science Advances, 2019) она составила от 5 до 8 бит на слог. Ещё одно близкое понятие — лексическая плотность: это доля содержательных слов (существительных, глаголов, прилагательных, наречий) в тексте, а служебные слова держат между ними связность. В препринте июня 2026 года на arXiv лексической плотностью называют другое — скорость, с которой контекст вводит различающуюся информацию, и измеряют её показателем MATTR, скользящим средним отношением разных слов ко всем словам. Это разнообразие лексики, а не доля содержательных слов и не доля фактов.
Как AI-поиск Google подбирает источники
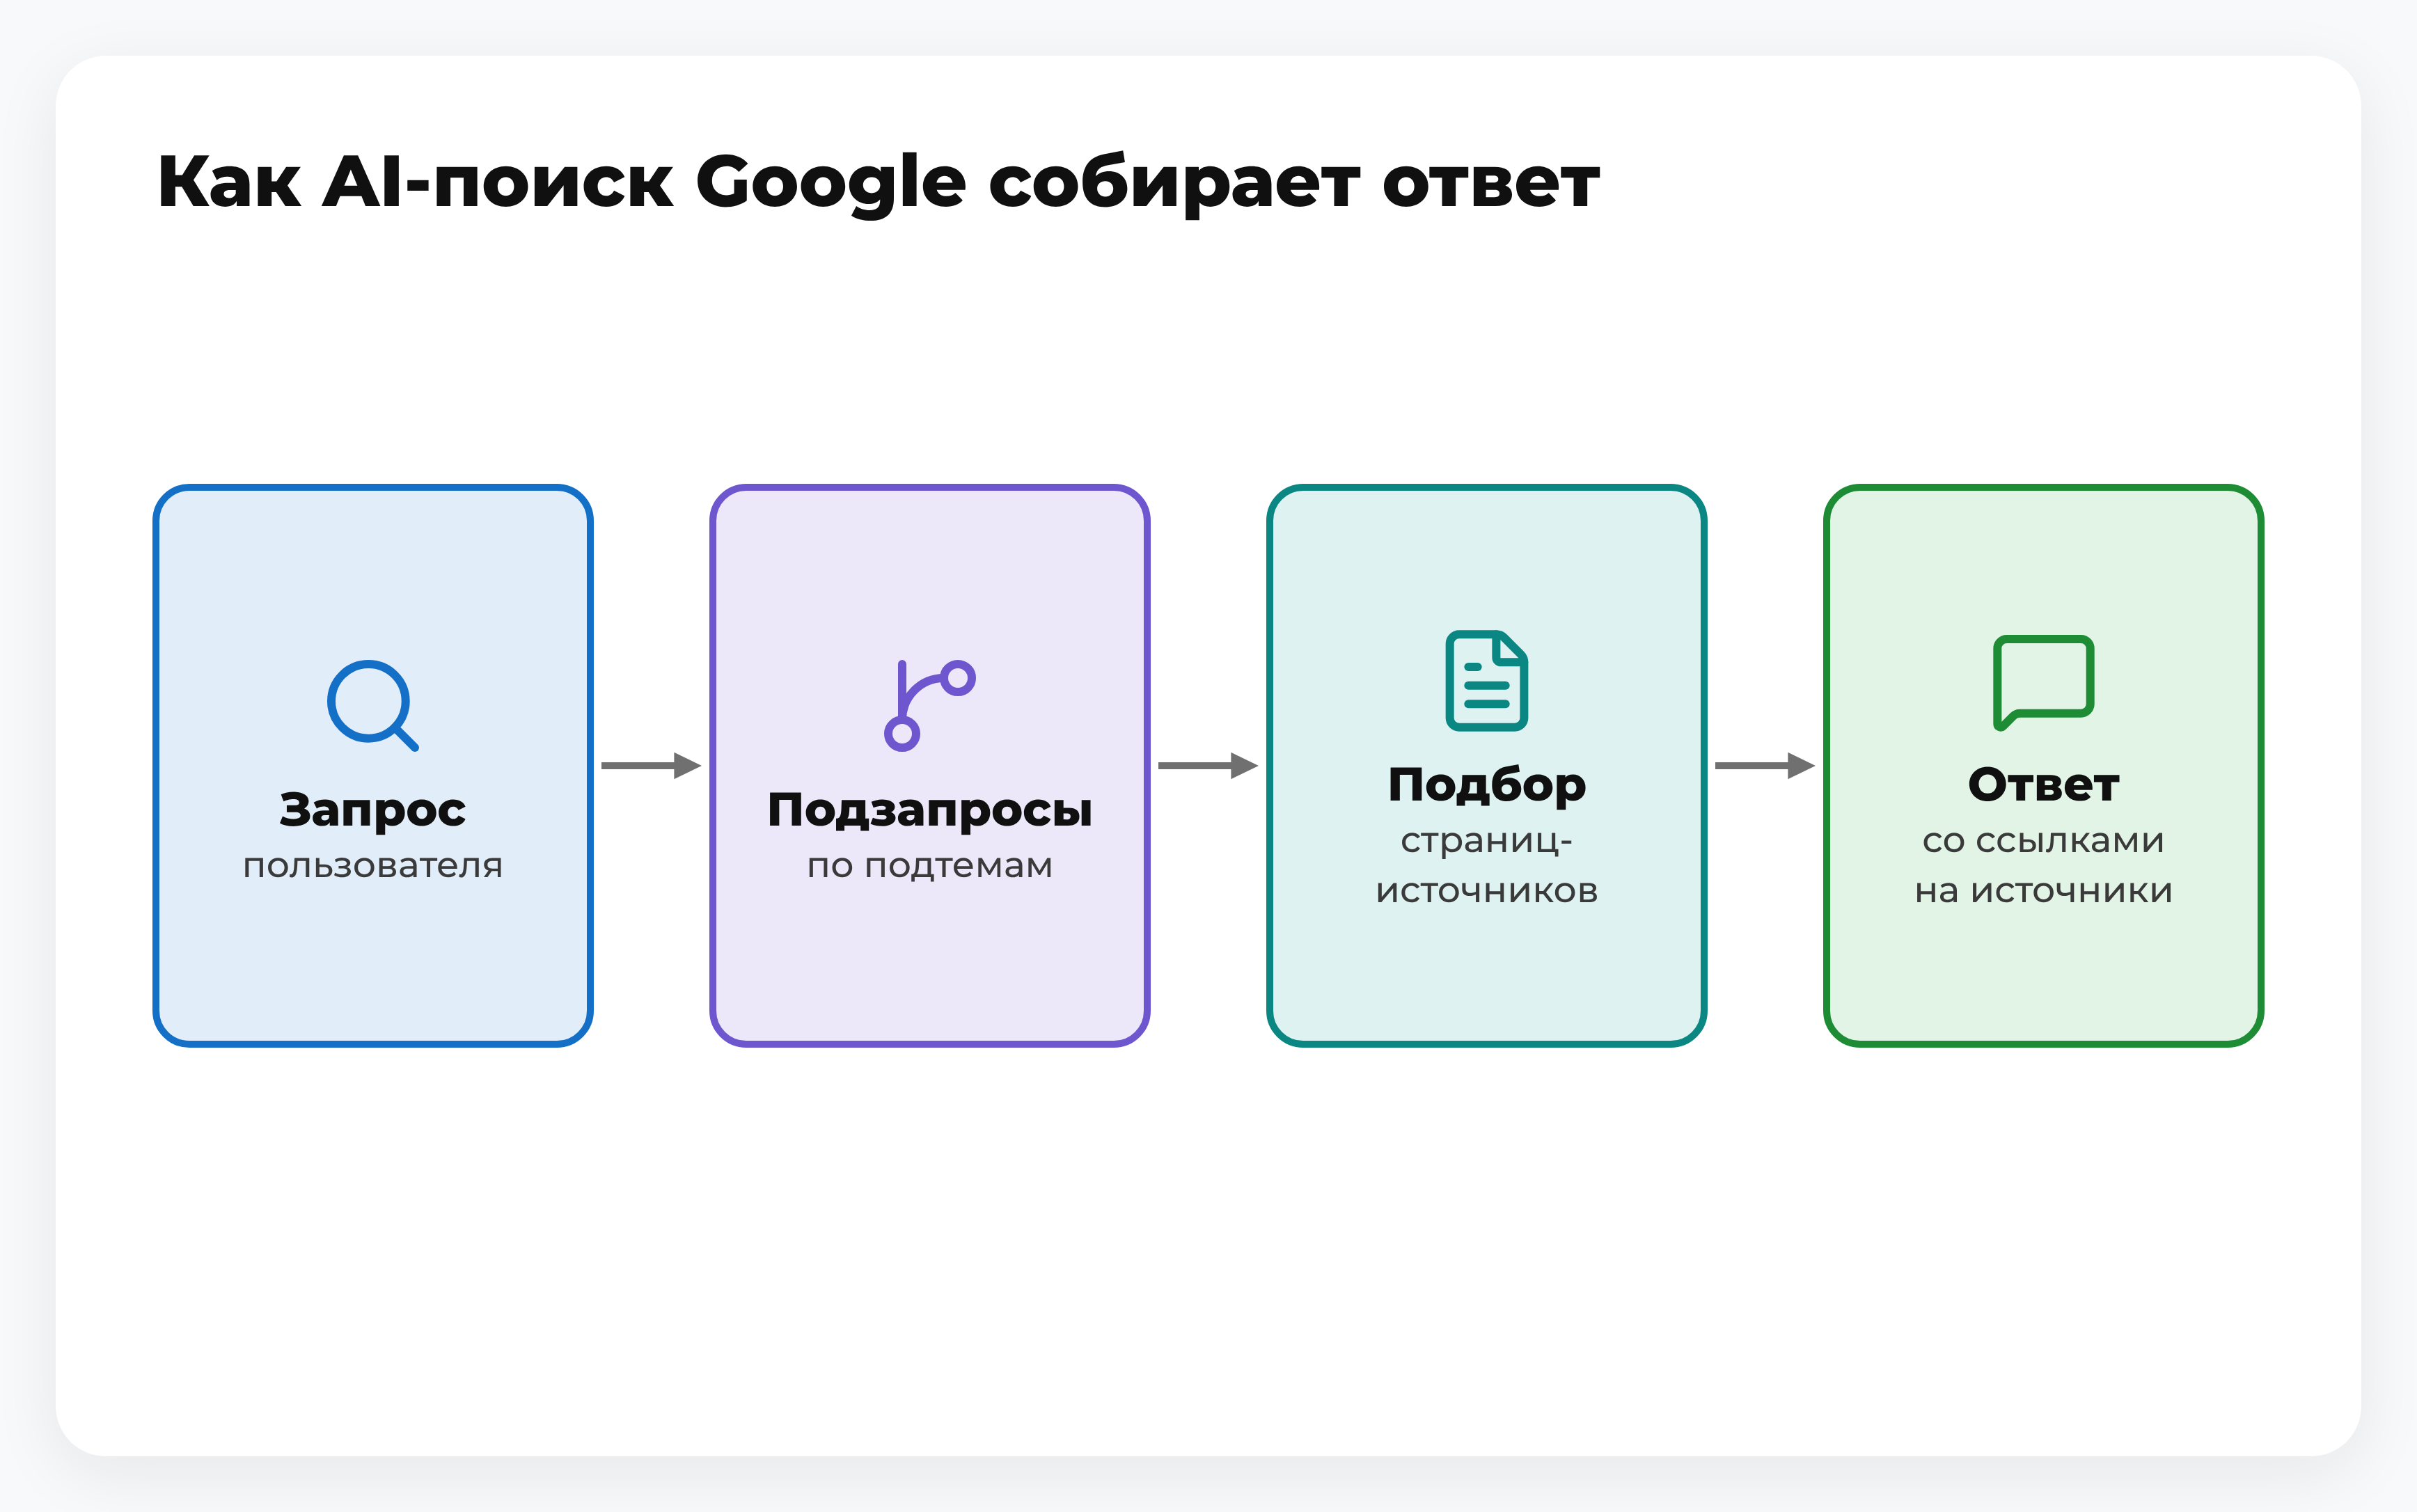
Google описывает, что AI Overviews и AI Mode могут использовать приём query fan-out: отправлять несколько связанных поисковых запросов по подтемам и источникам данных, чтобы собрать ответ. Пока ответ формируется, модели подбирают дополнительные страницы-источники и показывают ссылки на них, а как из страницы выбирается текст, на этой странице документации не описано. Как кластеризовать такие подзапросы, мы разбирали в материале про query fan-out и кластеризацию запросов для LLM.
В классическом поиске Google есть система passage ranking: она определяет отдельные разделы страницы, чтобы лучше понять, насколько страница релевантна запросу. Описание не содержит штрафа за длину страницы. Практический вывод для автора: у абзаца должна быть своя тема и названный объект, чтобы раздел оценивался сам по себе.
Для показа в AI Overviews и AI Mode, по документации Google, дополнительных технических требований нет: страница должна быть проиндексирована и иметь право показываться со сниппетом. Особая оптимизация не нужна, остаются основы SEO, в том числе важный контент в текстовом виде. О других AI-системах эта документация Google не говорит.


Что исследования говорят о лишнем тексте
Вода — это фразы, в которых нет ни факта, ни условия, ни названия. Для читателя они замедляют чтение, а для системы извлечения становятся лишним материалом вокруг нужного сведения.
В работе «Lost in the Middle» (2023) исследователи проверяли языковые модели на вопросах по нескольким документам и на поиске по ключу. Точность чаще всего была выше, когда нужный факт стоял в начале или в конце входных данных, и заметно падала, если он оказывался в середине длинного контекста. Это положение факта во входе модели, а не вода на сайте. О расположении текста на странице есть отдельный эксперимент о расположении ключевых слов в тексте и ранжировании.
В отчёте Chroma, компании-разработчика векторных баз данных (июль 2025), протестировали 18 языковых моделей. В лабораторных задачах качество неравномерно падало с ростом длины входа, а отвлекающие фрагменты заметнее мешали на длинных входах. Чем ниже сходство вопроса и нужного факта, тем быстрее росла деградация. Отчёт компании не рецензировался.
В бенчмарке GEO-bench (10 000 запросов, статья 2023 года) исследователи меняли тексты и смотрели, как часто источник попадает в ответ порождающей поисковой системы авторов. Добавление статистики, цитат из источников и ссылок повышало видимость до 40 % к базовому уровню. Наращивание ключевых слов почти не помогло, а на сервисе Perplexity.ai дало результат на 10 % хуже базового.
Эти работы проверяли влияние отвлекающих фрагментов и положения факта на извлечение, а воду отдельно не изучали. Конкретика в бенчмарке GEO-bench повышала видимость. Правки текста входят в общую работу над видимостью, и мы ведём её в рамках продвижения сайта в нейросетях.
Что убирать из текста, а что оставить
Вычёркивайте то, что не добавляет ни факта, ни условия: штампы, оценки без обоснования, повторы другими словами и абзацы-анонсы. Общую фразу заменяйте глаголом или числом. Вместо «сервис помогает улучшить результаты» назовите, какие показатели меняются и за счёт чего.
Удаление стоп-слов повышает плотность только на бумаге: слов становится меньше, а фактов не прибавляется, и часть связей между ними теряется. В обработке текста стоп-слова — это слова из стоп-списка, которые отфильтровывают как малозначимые для задачи, а универсального списка не существует. Служебные слова (предлоги, союзы, частицы) и местоимения связывают факты и условия, поэтому вычёркивать их механически опасно. Не путайте термин со стоп-словами в рекламе, где так называют слова-исключения.
Всегда оставляйте название объекта, условие, период, дату и исключение. Фраза «доставка бесплатная» выглядит плотно, но без условия, города и минимальной суммы заказа проверить в ней нечего.
Перед тем как вычеркнуть слово, спросите, что потеряет читатель без него. Если ничего, слово лишнее.
| Элемент текста | Что делать | Почему |
|---|---|---|
| Повтор мысли другими словами | Убрать | Нового факта нет |
| Оценка без обоснования | Заменить фактом или числом | Утверждение становится проверяемым |
| Абзац-анонс | Убрать | Сведений о предмете нет |
| Служебные слова | Оставить | Связывают факты и условия |
| Название, условие, период, дата, исключение | Оставить | Без них факт нельзя проверить |
Водой не считаются определение, подводка к термину и оговорка, которая меняет решение читателя.
Как повысить плотность сущностей в абзаце
Сущность — это именованный объект, о котором идёт речь: компания, сервис, документ, дата. Чем точнее названа сущность, тем меньше слов вроде «это» и «данный подход» стоит на её месте и тем понятнее, к чему относится факт. Каждое такое слово заставляет читателя возвращаться назад и выяснять, что имелось в виду.
Абзац правим в пять действий. Порядок предлагаем свой, а на исследование GEO опирается третий шаг: там видимость повышали статистика, цитаты и ссылки на источники.
- Назовите объект вместо «это» и «данный подход».
- Замените оценку фактом: числом, периодом, условием.
- Добавьте статистику, цитату или ссылку на источник там, где утверждение это допускает.
- Уберите повтор мысли другими словами.
- Вынесите ответ в начало абзаца и поставьте условие рядом с фактом.
Пример абзаца до и после правки
Условный пример: абзац о тарифе вымышленного сервиса, его название, цена и состав придуманы для примера.
| До правки | После правки |
|---|---|
| Наш тариф — отличное решение для бизнеса любого масштаба. Он включает всё необходимое для эффективной работы и стоит недорого. Подробности можно уточнить у менеджеров. | Тариф «Профи» сервиса «Отчёт-Бюро» рассчитан на 5 пользователей и включает выгрузку отчётов в PDF. Он стоит 4900 рублей в месяц при оплате за год. Поддержка отвечает по почте в будни. |
Вычеркнуты оценки «отличное», «всё необходимое», «недорого» и отсылка к менеджерам. Добавлены название тарифа и сервиса, число пользователей, формат выгрузки, цена с условием оплаты и канал поддержки. После правки абзац отвечает сам, и контекст соседних абзацев ему не нужен.
Факты, которые можно проверить
Для самооценки Google предлагает вопросы: даёт ли материал оригинальную информацию, исследование или анализ, описывает ли тему полно, избегает ли простого пересказа чужих источников и приносит ли существенную добавленную ценность. Это ориентиры качества, а не формула ранжирования. На практике ответ «да» требует проверяемых сведений в содержании: числа, названия, источника или собственного наблюдения.
Пример из практики Kokoc.com связан с фармацевтическим сайтом-визиткой с препаратами для дерматологии. Контент сайта проверяли юристы и врачи. Каждый месяц на сайт загружали авторские тексты не менее 40 000 знаков, для их написания привлекали экспертов-дерматологов, а страницы содержали только проверенную информацию. Видимость сайта в «Яндексе» выросла с 6,3 % до 67 % с марта по октябрь 2021 года. Результат дал весь комплекс работ, от аудита до структуры и контента, и вклад плотности текста отдельно не выделяется.
Этапы и результаты описаны в кейсе продвижения фармацевтического сайта. Сверку правок со списком названий и условий удобно встроить в вычитку, об этапах которой рассказывает материал о корректуре текста.


Как измерить плотность информации в тексте
Для счёта хватит двух показателей. Первый считает проверяемые утверждения на 100 слов абзаца: утверждение засчитывается, если в нём есть объект и условие, число или период. Второй считает уникальные названия на 100 слов: бренды, сервисы, термины, параметры.
Сравнивать можно только версии одного и того же текста, пороговых значений мы не задаём. Посчитаем по условному абзацу из предыдущего раздела.
| Показатель | До правки | После правки |
|---|---|---|
| Слов в абзаце | 23 | 30 |
| Проверяемых утверждений | 0 | 4 |
| Утверждений на 100 слов | 0 | 13,3 |
| Уникальных названий | 0 | 3 |
| Названий на 100 слов | 0 | 10,0 |
Главная строка здесь — утверждения на 100 слов. Объём абзаца вырос на 7 слов, а проверяемых утверждений стало четыре вместо нуля. В новой версии считаются тариф «Профи» на 5 пользователей, выгрузка в PDF, цена с условием оплаты и поддержка по почте в будни, а названия — «Профи», «Отчёт-Бюро» и PDF.
MATTR из препринта тоже можно посчитать, но он измеряет разнообразие слов. В сноске препринта стандартная проза вроде романа «Гордость и предубеждение» даёт около 0,72, а конфигурационные файлы ИИ-агентов могут доходить до 0,82. Точное повторное название объекта снижает MATTR, хотя читателю помогает, поэтому для оценки правки он не годится.
Дополните счёт четырьмя вопросами к абзацу. О чём он? К какому объекту относится каждое утверждение? При каких условиях оно верно? Можно ли проверить его по источнику?

Баланс высокой плотности и читабельности
Перегрузить текст тоже можно. В препринте 2026 года проверяли открытые модели от 9 до 685 млрд параметров на задачах поиска нужной строки в контексте объёмом около 12 тысяч токенов. На контекстах с высокой лексической плотностью (MATTR 0,75–1,0) точность падала ниже 60 %, на разреженных была почти идеальной, а снижение плотности обычно её восстанавливало. Задачи искусственные, и речь в них о разнообразии слов, а не о числе фактов в абзаце.
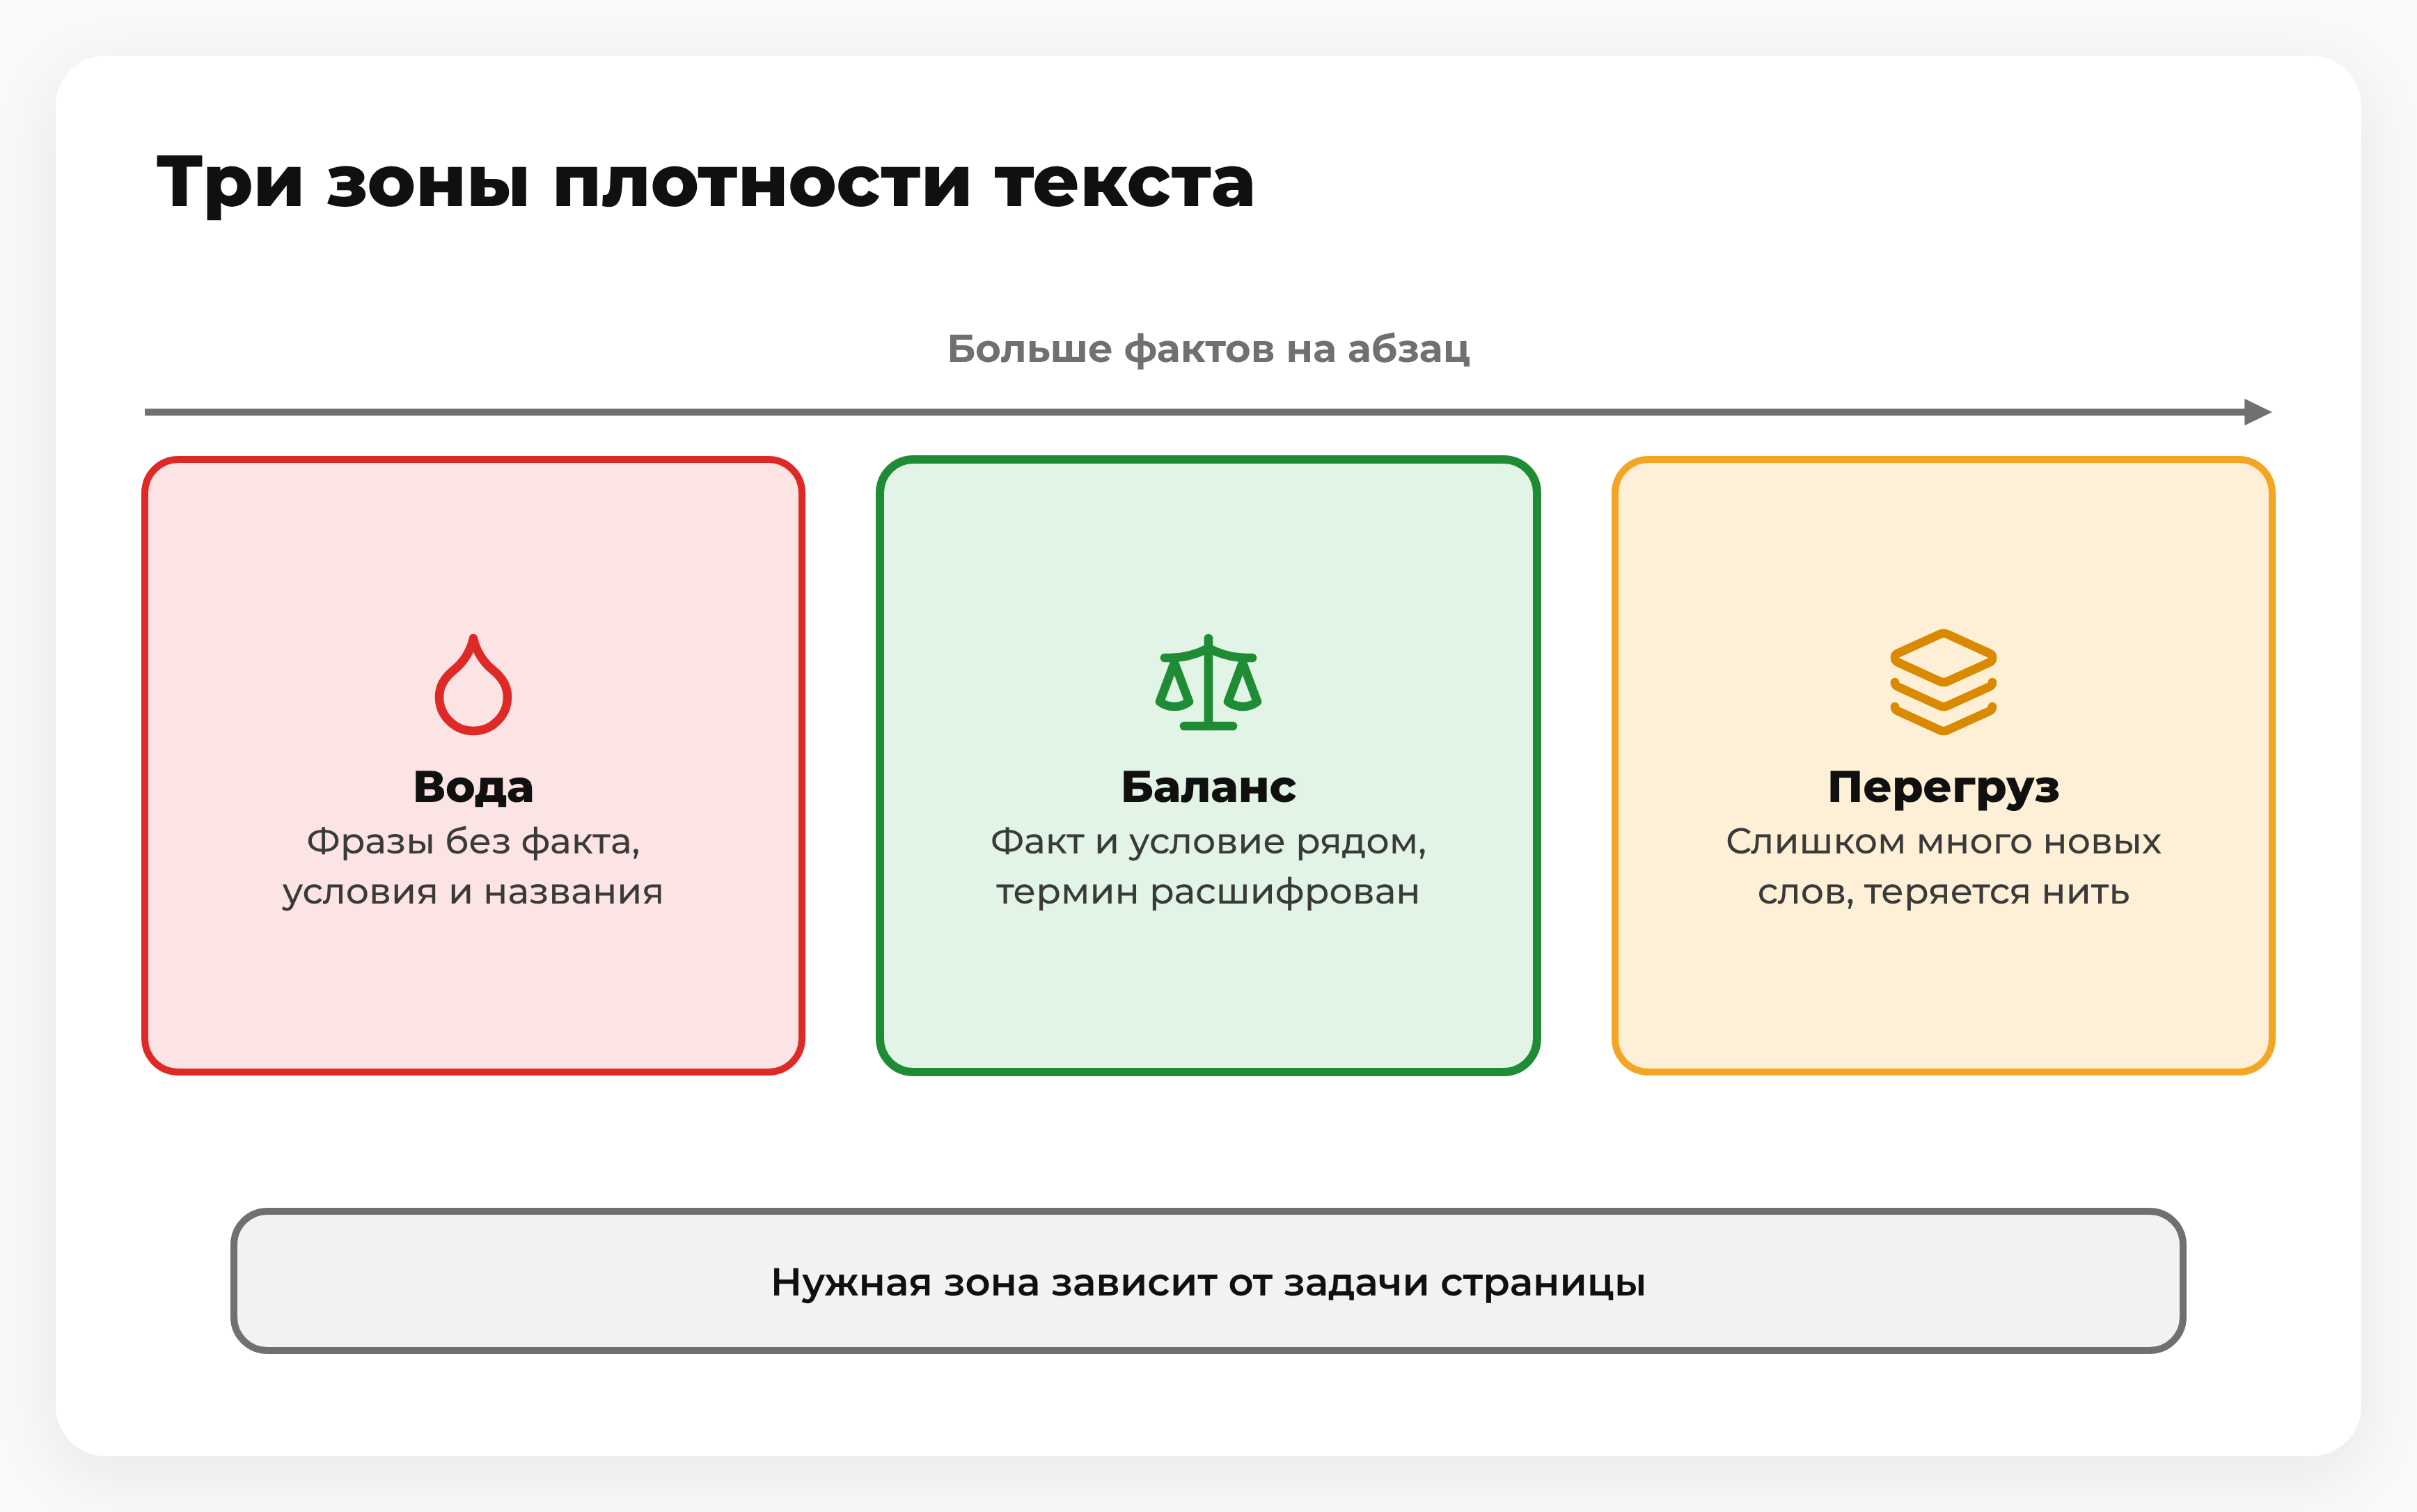
Читабельность сохраняют приёмы, которые не отнимают фактов. Факт и его условие стоят в одном предложении, термин расшифрован при первом упоминании, перечень из четырёх и более однотипных элементов оформлен списком, а сравнение по одинаковым признакам таблицей. Короткие предложения помогают, если не отрывают условие от факта. Допустимая плотность зависит от задачи страницы: справочный материал или карточка параметров выдерживает больше фактов на абзац, чем статья, которую читают подряд.

Старые статьи с водой правят точечно: отмечают абзацы без факта и условия и меняют их, сохраняя названия, даты и исключения. Общий порядок такой работы описан в материале о том, как обновить старый контент.
Читайте текст дважды: подряд, как читатель, и по одному абзацу, как отдельный фрагмент. Если абзац понятен только рядом с соседними, добавьте в него название объекта.
FAQ по информационной плотности
Нужна ли информационная плотность для поиска «Яндекса»?
Прямо о плотности текста «Яндекс» в посте об обновлении алгоритма качества контента (март 2024 года) не пишет. По этому посту, алгоритм входит в метрику «Проксима», больший вес получают экспертность и доверие пользователей, а спам-материалы с бессмысленными фрагментами он лучше определяет как некачественные. Компания советует проверять информацию, чтобы в материалах не было фактических ошибок, и конкретные названия, числа и источники с этим согласуются.
Можно ли доверить сжатие текста языковой модели?
Можно, но как черновик. Модель убирает повторы и вводные обороты, однако может потерять условие, дату или исключение. Попросите её перечислить удалённые фрагменты и проверьте этот перечень вручную до публикации.
Как быть с карточками и справочными страницами?
В справочных блоках ценность в точности значений. У каждого числа нужна единица измерения, у параметра название, у значения условие: к какому варианту товара оно относится. Подписи к столбцам таблицы называют объект, а не повторяют заголовок страницы.
Коротко о главном
- Информационная плотность в редактуре — это количество проверяемых утверждений, названий, чисел и условий на единицу текста, и нужная её мера зависит от задачи страницы.
- В лабораторных задачах точность извлечения падала из-за отвлекающих фрагментов и факта в середине длинного входа, а в бенчмарке GEO-bench статистика, цитаты и ссылки повышали видимость; воду отдельно эти работы не изучали.
- Особая оптимизация под AI-функции Google не требуется, действуют основы SEO.
- Убирайте повторы, штампы и анонсы, а названия, условия, даты и служебные слова оставляйте.
- Считайте утверждения и названия на 100 слов и сравнивайте только версии одного текста.
- Перегруз тоже вреден, поэтому плотность выбирают по задаче страницы.

.png)
.png)



Комментарии
Комментариев пока нет. Будьте первым!
Оставить комментарий