


- Что такое Information Gain в SEO простыми словами
- Почему фактор ранжирования Information Gain стал критически важным
- Как Google технически вычисляет Information Gain Score
- Как использовать Information Gain в SEO: пошаговый алгоритм для авторов
- Пример на практике: статья с нулевым приростом против экспертного материала
- Типичные ошибки, убивающие добавочную ценность контента
- FAQ: частые вопросы о Приросте Информации
- Коротко о главном
Что такое Information Gain в SEO простыми словами
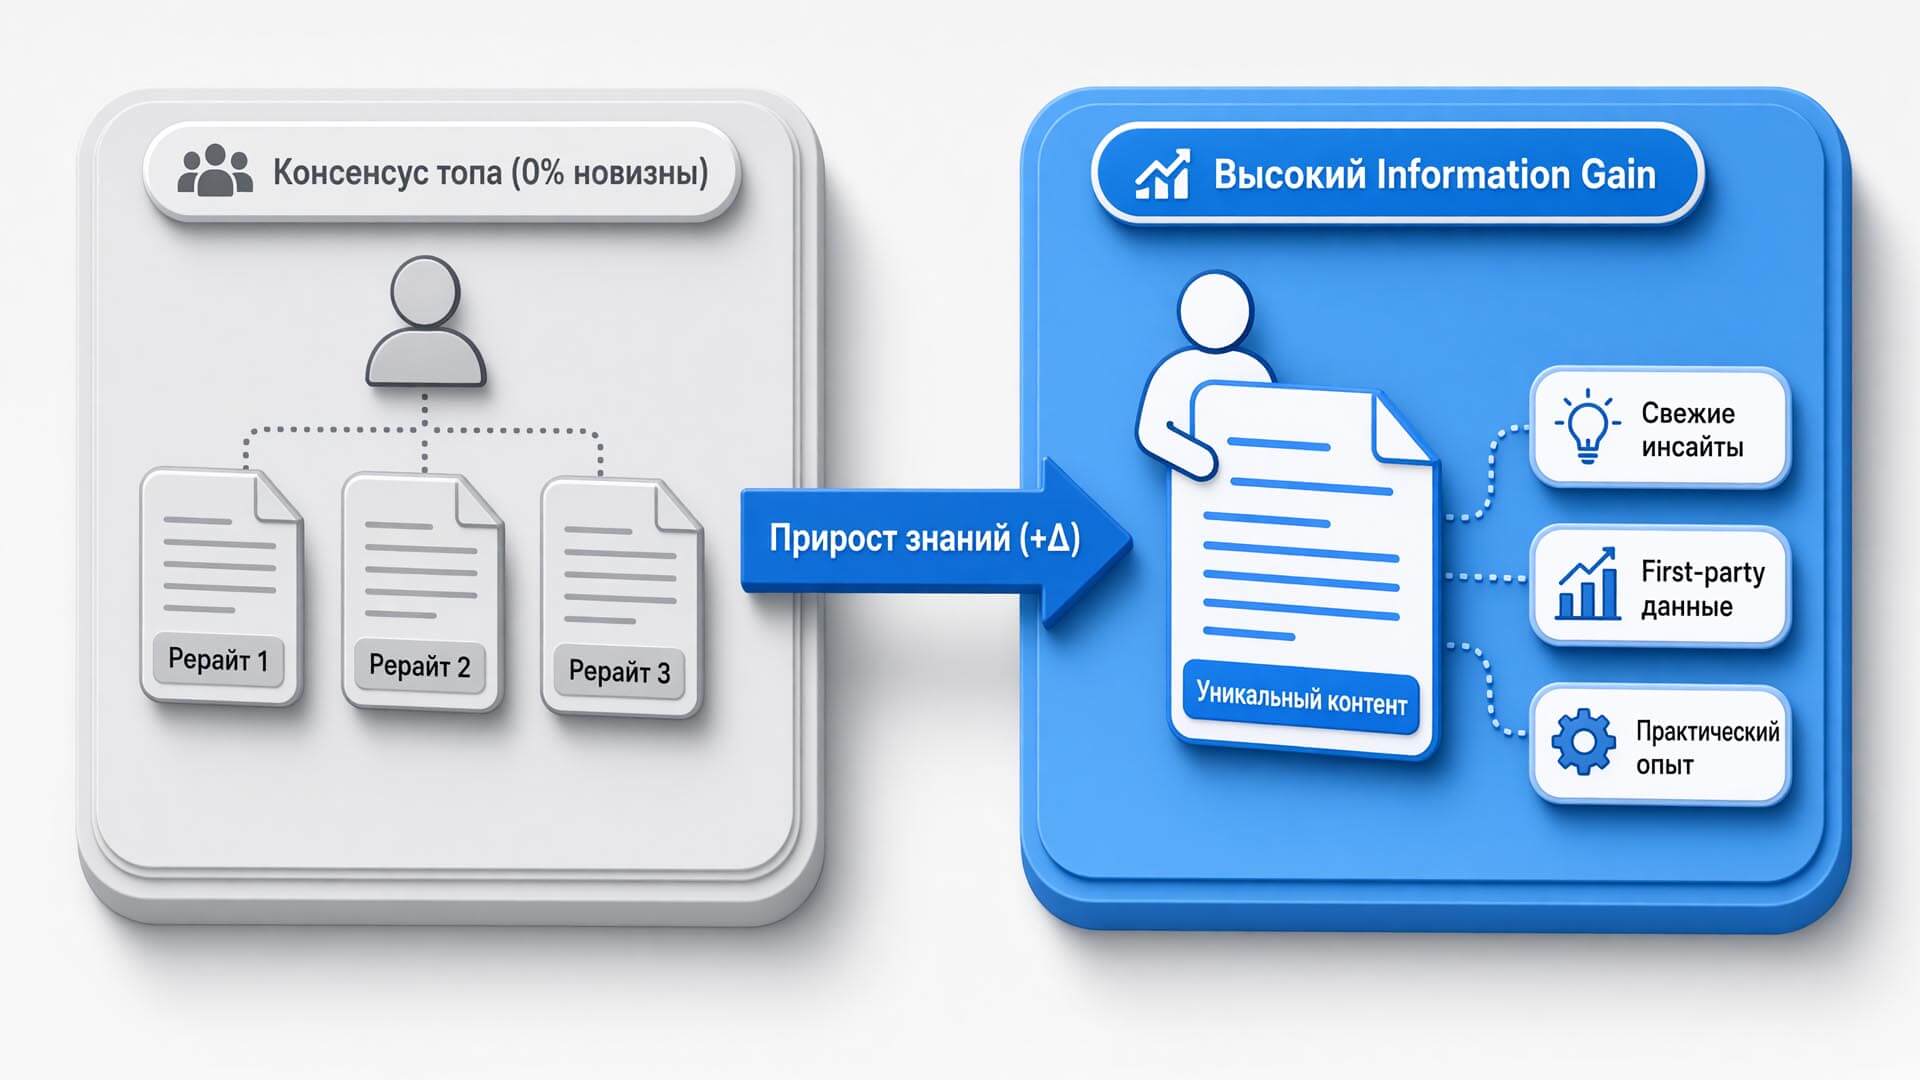
Термин information gain в SEO — это математическая оценка того, сколько новой, полезной и неочевидной информации получает пользователь из конкретной страницы по сравнению с источниками, которые он уже просмотрел в выдаче. Концепция базируется на официальном патенте Google (US11354342B2) под названием «Contextual estimating of information gain». Авторы документа — инженеры Виктор Карбуне и Педро Гоннет. Первая подача состоялась в октябре 2018 года, а последующие переоформления вплоть до июня 2025 года подтверждают фундаментальную значимость метрики для современных алгоритмов.
Важно понимать разницу между формой и содержанием. Страница выдает 100 % оригинальности по сервисам антиплагиата, но при этом не добавляет ни одного свежего факта, авторского угла зрения или аналитического вывода. Подобный контент поисковые системы классифицируют как информационный шум, пессимизируя его в выдаче.

Почему фактор ранжирования Information Gain стал критически важным
Сдвиг парадигмы произошел из-за глубинных изменений в архитектуре поиска. Генеративный поиск полностью меняет точку входа пользователя. Системы AI Overviews и Яндекс Нейро формируют ответ из набора авторитетных источников. Если страница повторяет факты из топ-10, алгоритму незачем включать ее в синтезированный ответ.
Алгоритмы дедупликации теперь работают на уровне смысла. Поисковики используют механизмы для выявления семантических дублей — страниц, покрывающих идентичные факты в разных лексических формулировках. Одновременно поведенческие сигналы усиливают отрыв лидеров. Контент с оригинальными данными удерживает пользователя дольше. Система NavBoost фиксирует паттерны кликов, и итоговый рейтинг страницы напрямую зависит от реального взаимодействия.
Сегодня добавленная ценность контента в SEO выступает ключевым сигналом качества. Google оценивает contentEffort — объем человеческого труда, вложенного в материал. Оригинальные исследования, мультимедиа и подтвержденная экспертность напрямую коррелируют с высоким показателем прироста информации.
Конец метода «Небоскреба» и смерть шаблонного рерайта
Метод «Небоскреба» (Skyscraper Technique) долгие годы строился на простой механике: специалист собирал топ-10 конкурентов и делал материал длиннее и полнее. Подход давал результаты, пока алгоритм оценивал объем текста и плотность ключевых слов.
Сейчас алгоритм GIST (Greedy Independent Set Thresholding) и системы ContentChecksum96 штрафуют страницы не за низкое качество текста, а за избыточное семантическое совпадение с лидерами ниши. Google исключает источники из выборки, если они попадают в «радиус конфликта» (Conflict Radius) более авторитетного документа. Сборка статьи из существующих топов без интеграции новых данных лишена смысла. Алгоритм схлопывает семантические дубли: вектор страницы сливается с проранжированными источниками, обнуляя прирост информации.
Стратегия «сделать лучше, чем у конкурента» потеряла эффективность. Рабочей осталась стратегия «сделать информационно иначе» — добавить узлы знания, отсутствующие у конкурентов в поисковой выдаче.
Влияние AI Overviews на оценку контента
Генеративная система Google AI Overviews работает через механизм Query Fan-Out. Один запрос пользователя разворачивается в десятки синтетических подзапросов, после чего нейросеть собирает фрагменты из множества источников и синтезирует единый ответ. Базовое требование к источникам — Intelligent Grounding. Система ищет верифицируемые факты, которые легко извлечь и атрибутировать конкретному сайту. ИИ не доверяет одному источнику и требует триангуляции фактов.
Google использует строгую иерархию доверия в Knowledge Graph: от государственных реестров до проверенных асессорами сайтов и обычных веб-фактов. Сайты без оригинальных данных остаются на нижнем уровне. Контент с четкими извлекаемыми сущностями и структурированными данными получает приоритет. Страницы, пересказывающие общеизвестную базу, отфильтровываются как информационный шум. Детальный разбор механики формирования ответов доступен в нашем материале о попадании в AI-сниппеты Google и Яндекс Нейро.
| Параметр | Традиционное SEO (до 2023) | SEO в эпоху AI |
|---|---|---|
| Основа контента | Рерайт топ-10, увеличение объема | Оригинальные данные, Information Gain |
| Объем | Чем больше — тем лучше (2000–5000+ слов) | Информационная плотность; первые 150–200 слов критичны |
| Уникальность | Техническая (по антиплагиату) | Смысловая — новые факты, сущности, выводы |
| Целевая аудитория алгоритма | Поисковый бот Google | LLM-модели и AI Overviews |
| Ключевые метрики | Плотность ключевых слов, позиция в SERP | contentEffort, E-E-A-T, извлекаемые сущности |
| Структура данных | Линейная, ориентирована на ключевики | Семантические триплеты, детализированная микроразметка |
| Сигнал доверия | Количество ссылок | Entity Co-occurrence, цифровой след бренда, авторство |
Как Google технически вычисляет Information Gain Score
Патент описывает систему оценки, измеряющую объем дополнительной информации в документе относительно того, что пользователь уже изучил. Речь идет не об абсолютной уникальности контента, а об относительной новизне по отношению к ранее посещенным результатам в рамках конкретной сессии поиска.
Механизм активируется при переранжировании результатов, когда пользователь возвращается на страницу выдачи (эффект pogo-sticking). Поисковик предлагает следующими те источники, которые расширяют контекст, а не дублируют просмотренные тезисы.
Векторные представления и семантические кластеры
Нейросети переводят текстовый массив в многомерные числовые векторы — embeddings. Семантически близкие документы располагаются рядом в математическом пространстве. Система вычисляет косинусную схожесть между векторами запросов и страниц. Для понимания концепций применяются языковые модели типа BERT и MUM, распознающие смыслы вне зависимости от лексических различий.
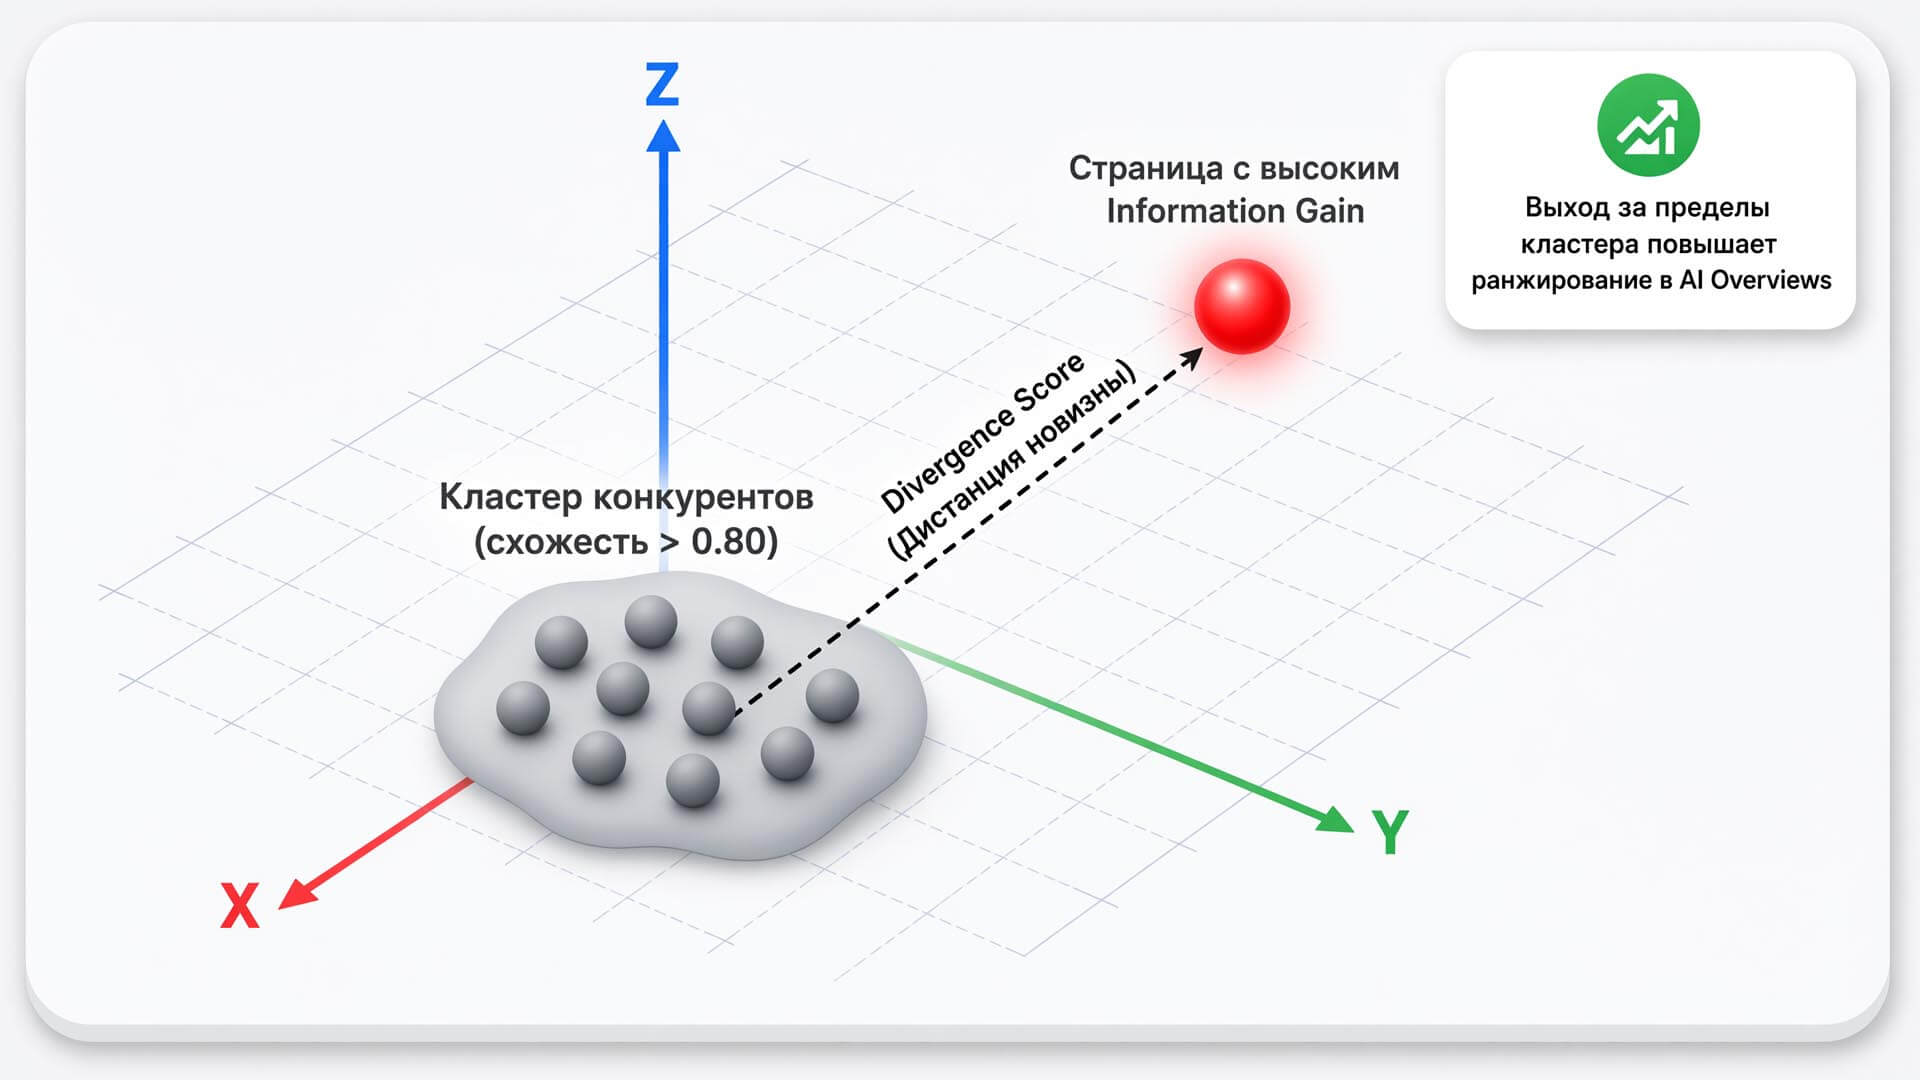
Семантические кластеры формируются путем группировки документов с высокой векторной схожестью (порог 0,80 и выше). Если новая статья попадает в кластер проранжированного лидера и не расширяет тематическое покрытие (topical depth), алгоритм присваивает ей низкий divergence score. Чем дальше страница от центра кластера конкурентов, тем выше ее потенциальный показатель information gain в SEO.
Information Gain против технической уникальности
Разница между понятиями фундаментальна. Техническая уникальность измеряет совпадение на уровне слов и синтаксических конструкций. Инструменты проверки сравнивают формулировки с базой текстов. Результат легко доводится до 100% уникальности при банальном пересказе чужих мыслей другими словами.
Смысловая уникальность работает на уровне фактологии. Алгоритм сканирует текст на наличие новых сущностей, цифр или выводов сверх известного консенсуса. Статья с простыми формулировками, содержащая свежую статистику из CRM, получает высокий балл прироста информации, игнорируя низкий процент по классическому антиплагиату.
Техническая уникальность — базовое гигиеническое требование. В эпоху генеративного поиска системы приоритизируют смысловую новизну как главный маркер реальной пользы материала.
Как использовать Information Gain в SEO: пошаговый алгоритм для авторов
Разберем практическое руководство по созданию материалов с высокой добавочной ценностью. Задача каждого этапа — внедрить элементы, отсутствующие у конкурентов.
Шаг 1. Интеграция first-party data
Собственные данные компании (first-party data) включают результаты клиентских опросов, аналитику из CRM-систем, итоги A/B-тестов и внутренние финансовые метрики. Искусственный интеллект физически не способен сгенерировать эти цифры из открытых источников.
На практике процесс выглядит просто: маркетологи проводят опрос 200 покупателей и добавляют результаты в статью с сегментацией по возрасту. Аналитики выгружают данные об отказах на этапе корзины и оформляют их как экспертный вывод. Один график, построенный на реальных продажах, дает больше веса, чем пять абзацев пересказа чужих отраслевых отчетов.
Шаг 2. Привлечение профильных экспертов (SME)
Специалисты с практическим опытом (Subject Matter Experts) дают фактуру, скрытую от копирайтеров: профессиональный сленг, неочевидные ограничения технологий, детали реальных внедрений. Это насыщает семантику текста LSI-сущностями.
Перед интервью проведите онтологический анализ (Entity Mining): поручите LLM разобрать тему на фундаментальные сущности. Сгруппируйте их по доменам. Во время беседы фиксируйте специфические термины и сокращения. Это сформирует аутентичный словарь, служащий маркером подлинной экспертизы для поисковых ботов.
Шаг 3. Полярные мнения и нестандартные углы обзора
Одинаковые утверждения во всех статьях топа формируют консенсусный контент. Алгоритм давно усвоил эту базу. Цель автора — найти аргументированную точку несогласия или добавить перспективу, упущенную конкурентами.
Нет смысла спорить с очевидным. Достаточно прописать жесткие ограничения продукта, разобрать исключения из правил или показать изменение эффективности метода в зависимости от бюджета клиента. Подобный подход генерирует новые смысловые узлы, повышая divergence score документа.
Шаг 4. Детализация узких микро-интентов
Широкие тематики перегреты контентом, узкие сегменты остаются свободными. Смещение фокуса с запроса «Как выбрать CRM» на «Как выбрать CRM для B2B SaaS с циклом сделки от 6 месяцев» переводит страницу из перегруженного кластера в свободную нишу.
Используйте метод QBST-Gap Analysis. Анализируйте топ-5 выдачи, блоки People Also Ask и связанные поиски. Выписывайте подтемы, раскрытые поверхностно. Для поиска длиннохвостых запросов применяйте регулярное выражение `([^\s]+\s+){3,}` в Google Search Console. Конверсии по фразам из четырех и более слов в 2–3 раза превышают показатели коротких ключей.
Шаг 5. Создание уникального UX: интерактив и калькуляторы
Функциональные элементы, решающие задачу посетителя прямо на странице, формируют отдельный класс ценности. Калькуляторы окупаемости, интерактивные фильтры подбора, квизы — это контент, который алгоритм физически не находит на сайтах конкурентов. Интерактив увеличивает время сессии, снижает показатель отказов и генерирует позитивные поведенческие факторы. Система NavBoost считывает эти сигналы при ранжировании.
Пример на практике: статья с нулевым приростом против экспертного материала
Сравним два подхода к раскрытию одной темы на уровне архитектуры документа.
Анализ типичной статьи-агрегатора
Стандартная статья-агрегатор базируется на предсказуемом каркасе: словарное определение термина, перечисление базовых принципов, список популярных сервисов, короткое заключение. Все тезисы дублируют топ-10. Текст лишен оригинальных сущностей: нет исследований, цифр из кейсов, комментариев инженеров.

Алгоритм помещает векторное представление такой страницы в самый центр кластера конкурентов. Divergence score падает до нуля. Документ не формирует новых узлов знания, теряя шансы на попадание в AI-ответы. В классической выдаче страница временно удерживается за счет старых ссылок, но генеративный поиск ее игнорирует.
Кейс: рост органического трафика за счет оптимизации
Рассмотрим процесс трансформации контента. Исходные данные: статья-рерайт с высокой технической уникальностью, но нулевым приростом смыслов. Действия: редакция добавила результаты опроса 100 клиентов, комментарий юриста с разбором штрафов, калькулятор расчета стоимости и блок с анализом частых ошибок.
Итог: контент вышел за границы семантического кластера. Страница получила цитирование в AI-ответах. Органический трафик продемонстрировал уверенный рост. Практика подтверждает теорию: интернет-магазин, переписавший 100 карточек товаров с добавлением сравнительных таблиц и оригинальных описаний, за три месяца получил прирост органического трафика на 35% и увеличение конверсии на 15%.

Типичные ошибки, убивающие добавочную ценность контента
Разберем главные антипаттерны, приводящие к обнулению ценности материалов.
Погоня за объемом и LSI-спам. Механическое раздувание текста синонимами без внедрения новых фактов бессмысленно. Алгоритм сканирует плотность уникальных сущностей, а не количество печатных знаков.
Безликая подача без авторской позиции. Текст без признаков усилия (contentEffort) — поверхностное изложение без примеров, временных маркеров и деталей реальных сценариев — получает низкий рейтинг. Генеративные системы избегают ссылаться на абстрактные рассуждения.
Слепая AI-генерация без фактчекинга. Нейросеть компилирует данные из открытых источников, выдавая шаблонные фразы. Без жесткой редакторской обработки и промптов на добавление новых сущностей такой текст остается переупакованным консенсусом. Маркеры подобных текстов разобраны в статье про определение текста, написанного нейросетью.
Нарушение семантической структуры. Пропуск уровней заголовков (прыжок от H1 к H4) и отсутствие логической иерархии сигнализируют о низком качестве проработки. Это ломает passage indexing и снижает извлекаемость фрагментов для быстрых ответов.
Принципы создания материалов, выживающих в эпоху нейросетей, детально описаны в материале о принципах экспертного контента.
Текст без оригинальных данных, четкой авторской позиции и подтвержденных примеров превращается в информационный шум. Поисковик постепенно вытесняет такие страницы из видимой зоны.
Для понимания контентной стратегии под требования генеративного поиска изучите гайд по продвижению в нейросетях (GEO и AEO). Практическую реализацию задач можно делегировать, заказав услугу по продвижению сайта в нейросетях у профильных специалистов.
FAQ: частые вопросы о Приросте Информации
Заменяет ли Information Gain ссылки (Backlinks)?
Нет. Ссылочный профиль отвечает за авторитетность домена (Authority), сигнализируя о значимости ресурса. Прирост информации отвечает за ценность контента (Value). Факторы работают исключительно в синергии. Авторитетные ссылки помогают документу попасть в поле зрения алгоритма, но только качественный контент, генерирующий позитивные пользовательские сигналы, фиксирует позиции в топе. Ссылка передает вес только тогда, когда принимающая страница решает задачу посетителя.
Как измерить Information Gain до публикации статьи?
Специалисты применяют несколько методов оценки черновиков. Первый — регрессионное тестирование на Golden Dataset. Создается верифицированный набор эталонных ответов, с которым LLM сравнивает черновик по метрикам полноты и релевантности. Второй метод — анализ инференс-нагрузки. Модель проверяет, активирует ли текст новые смысловые цепочки или пересказывает известное. Третий — оценка семантической полноты через экспертное сравнение. Промпт заставляет LLM выступить в роли критика, оценивающего текст по шкале до 10 баллов с указанием пропущенных концепций. Если оценка ниже 7 баллов, материал отправляется на доработку.
Умрет ли SEO-копирайтинг из-за Information Gain и ИИ?
Умрет исключительно низкоквалифицированный рерайт, базирующийся на слепом пересказе топ-10. Спрос на авторов-экспертов (SME-writers) и редакторов, умеющих работать с сырыми данными, кратно возрастет. Алгоритмы не способны заменить специалиста с практическим опытом, умеющего проводить опросы, анализировать CRM-выгрузки и брать интервью у инженеров. Трансформация роли автора в сложных нишах разобрана в гайде по написанию текстов для медицинских сайтов.
Коротко о главном
- Метрика прироста информации оценивает добавочную ценность страницы относительно изученного пользователем материала. В условиях доминирования AI Overviews контент с низким показателем новизны теряет трафик, уступая место фактологически плотным статьям.
- Смысловая новизна важнее технической уникальности текста.
- Поисковик оценивает divergence score — степень выхода страницы за пределы семантического кластера конкурентов.
- Компиляция фактов из топ-10 без интеграции свежих данных обнуляет шансы на попадание в генеративную выдачу.
- Базовые источники ценности: first-party data, комментарии профильных экспертов, детализация узких микро-интентов.
- Нужно знать, как использовать показатель information gain в SEO, значит уметь находить пробелы в контенте конкурентов и закрывать их собственными исследованиями.
- Качественный контент и ссылочный профиль работают совместно: авторитет привлекает внимание алгоритма, а ценность материала удерживает позиции.
- Оценка черновика до публикации проводится через LLM-промпты, выявляющие дефицит смыслов по сравнению с эталонными текстами.
.png)
.png)



Комментарии
Комментариев пока нет. Будьте первым!
Оставить комментарий