


Микроразметка для нейросетей — процесс структурирования данных сайта в формате JSON-LD с использованием словарей Schema.org. Цель внедрения — повысить машинную читаемость контента, чтобы поисковые системы и AI-платформы точнее извлекали факты, разрешали сущности и формировали корректные генеративные ответы. Это базовый технический слой Generative Engine Optimization (GEO), который повышает шанс попадания ресурса в AI Overviews, SearchGPT, Perplexity и «Яндекс Нейро».
Важно разделять два смежных понятия. GEO отвечает за оптимизацию контента непосредственно для генеративных ИИ-платформ, чтобы материалы становились первоисточником для синтезированных ответов. Answer Engine Optimization (AEO) охватывает более широкую концепцию: подготовку сайта под системы готовых ответов, включая голосовых ассистентов, featured snippets и блоки «Люди также спрашивают». Если классическое SEO борется за позиции в стандартной выдаче из десяти синих ссылок, то GEO и AEO сражаются за место в нейроответах на нулевой позиции, где метрикой успеха выступает импрессия бренда — частота цитирования компании алгоритмами.
- Семантическая разметка для LLM: как ИИ понимает контент сайта
- Сравнение типов Schema.org для LLM и AEO-оптимизации
- JSON-LD или Microdata: какой формат лучше понимают нейросети
- Чек-лист внедрения разметки для ИИ
- Кейс: как пересборка структуры увеличила цитирование в нейросетях в 6 раз
- Специфика разметки для разных типов сайтов
- Часто задаваемые вопросы о микроразметке для нейросетей
- Коротко о главном
Семантическая разметка для LLM: как ИИ понимает контент сайта
Классический поисковый робот работает на уровне страницы: анализирует статический HTML-код, извлекает ключевые слова, оценивает HTTP-заголовки и строит лексический индекс на основе алгоритмов вроде TF-IDF. AI-поиск устроен принципиально иначе. Системы на базе архитектуры RAG (Retrieval-Augmented Generation) не индексируют страницу целиком в привычном понимании. Процесс делится на три этапа: извлечение релевантной информации из внешних источников (Retrieval), помещение фрагментов в изолированный контекст (Augmentation) и интерпретация данных моделью (Generation).
На этапе подготовки поисковые боты разбивают контент на смысловые блоки — чанки объемом по 150–400 токенов. Затем текст преобразуется в векторное представление (Word Embeddings) с помощью семантических моделей. Алгоритм ищет семантически близкие фрагменты к запросу пользователя, и финальный ответ синтезируется из нескольких таких чанков. Именно здесь семантическая разметка для LLM приобретает критическую ценность. Структурированные данные передают алгоритму жесткие факты, которые не нужно вычислять через векторную близость.

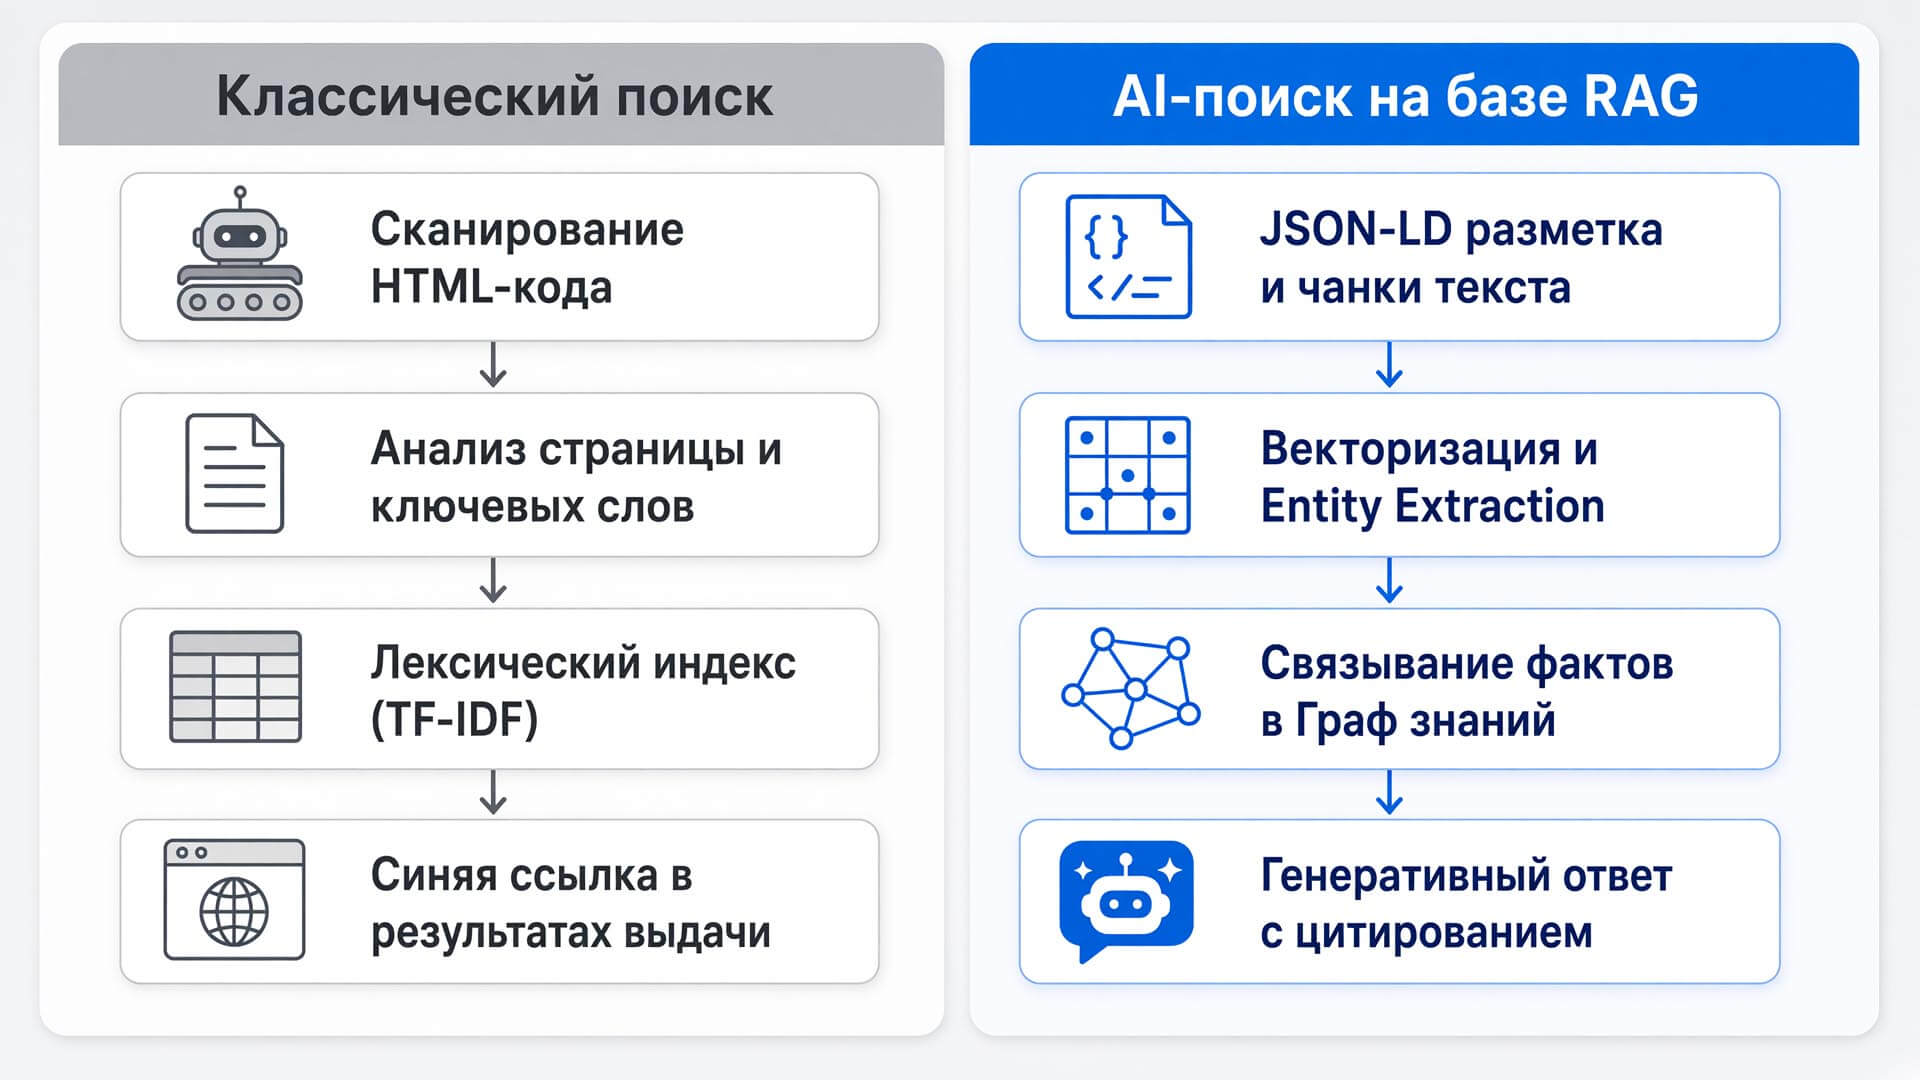
Entity Extraction и снижение неоднозначности
У ИИ-систем есть две фундаментальные проблемы при работе с неструктурированным текстом. Первая — неоднозначность сущностей: без явной разметки модель вынуждена вычислять, кто выступает автором статьи, какова актуальная цена продукта или к какой организации относится эксперт. Вторая — риск опоры на устаревшие или противоречивые данные из базового обучающего корпуса, что приводит к галлюцинациям.
Внедренная микроразметка для LLM решает обе проблемы через механизм Entity Extraction (извлечение именованных сущностей). Когда тип Person содержит атрибуты name, jobTitle и sameAs со ссылкой на Wikidata, модель получает связи напрямую из машиночитаемого кода. Для YMYL-тематик (здоровье, финансы, право) предоставление верифицированных фактов заставляет генератор опираться на переданные данные, а не домысливать их.
структурированные данные не запрещают модели галлюцинировать технически, но они создают жесткий информационный каркас. Чем точнее код описывает сущности и их связи, тем выше вероятность, что AI-система использует именно эти факты при формировании ответа, экономя вычислительные ресурсы на поиске истины.
Сравнение типов Schema.org для LLM и AEO-оптимизации
Не все словари одинаково полезны для нейросетей. Грамотная разметка schema org для AEO смещает фокус с визуального оформления сниппетов в выдаче на передачу смыслов и подтверждение экспертизы. Таблица ниже демонстрирует приоритеты использования различных классов для обучения языковых моделей и попадания в быстрые ответы.
| Тип сущности | Приоритет для LLM (обучение/контекст) | Приоритет для AEO (быстрые ответы) | Пример использования |
|---|---|---|---|
| Article / TechArticle | ★★★★★ | ★★★★★ | информационные статьи: headline, datePublished, author (Person), publisher (Organization) |
| FAQPage / QAPage | ★★★★★ | ★★★★★ | блок вопрос-ответ: mainEntity → Question → acceptedAnswer. Текст ответа ≤ 580 символов |
| Organization / ProfilePage | ★★★★ | ★★★★ | страница компании или автора: name, logo, address, sameAs (соцсети, Wikidata) |
| Product | ★★★★★ | ★★★★★ | карточка товара: name, price, aggregateRating, offers, MemberProgram |
| Speakable | ★★★ | ★★★ | выделение фрагментов текста для голосового поиска и технологии FastSearch |
| Dataset | ★★ | ★★ | описание открытых наборов данных для научного и исследовательского контента |
| ClaimReview | ★★ | ★★ | проверка фактов (Google поэтапно выводит поддержку из Search results с 2025 года) |
Связка Article и FAQPage формирует базовый стек для попадания в AI Overviews. Языковая модель извлекает готовые формулировки из FAQPage и цитирует Article как авторитетный источник. Organization Schema критична для подтверждения E-E-A-T: указание sameAs, contactPoint и точной категории через additionalType (с использованием productontology.org) повышает уровень доверия алгоритмов к домену.
E-E-A-T через ProfilePage, Article и TechArticle
Требования к сигналам доверия авторов ужесточились. Тип ProfilePage связывает создателя контента с его цифровым следом. Нейросети анализируют скрытые метрики: authorReputationScore (числовая оценка репутации, накапливаемая независимо от сайта публикации) и authorObfuscatedGaiaStr (идентификатор в глобальной системе). Чтобы верифицировать профиль, необходимо передать через код подтвержденный опыт, должность, ссылки на LinkedIn или TenChat, а также карточку в Knowledge Graph.
Тип TechArticle расширяет стандартную Article для сложных технических материалов. Он сигнализирует AI-системам о профессиональной направленности текста. Обязательные поля включают headline, datePublished, dateModified (сигнал свежести контента) и author с вложенным типом Person. Подробнее о том, как экспертный контент влияет на ранжирование в эпоху нейросетей, разобрано в отдельном материале.
JSON-LD или Microdata: какой формат лучше понимают нейросети
Для оптимизации под генеративные ответы предпочтителен JSON-LD. Schema.org официально поддерживает оба формата, включая RDFa, но внедренная json-ld для aeo имеет неоспоримые технические преимущества. Microdata требует оборачивания текста в HTML-атрибуты itemscope, itemtype и itemprop, что усложняет поддержку верстки и повышает риск поломки кода при редактировании страницы контент-менеджерами.
JSON-LD встраивается изолированным блоком в тег <script type="application/ld+json"> внутри <head> или <body>, не смешиваясь с визуальным представлением. Исследования показывают, что при прямом парсинге страницы некоторые AI-боты могут игнорировать скрипты, читая только видимый HTML. Однако при индексировании поисковыми системами (которые затем поставляют данные для RAG-моделей) JSON-LD обрабатывается приоритетнее благодаря строгой стандартизированной структуре. Google официально рекомендует этот формат и корректно считывает его даже при динамической генерации через JavaScript.
Атрибуты sameAs, about и mentions: связь с графами знаний
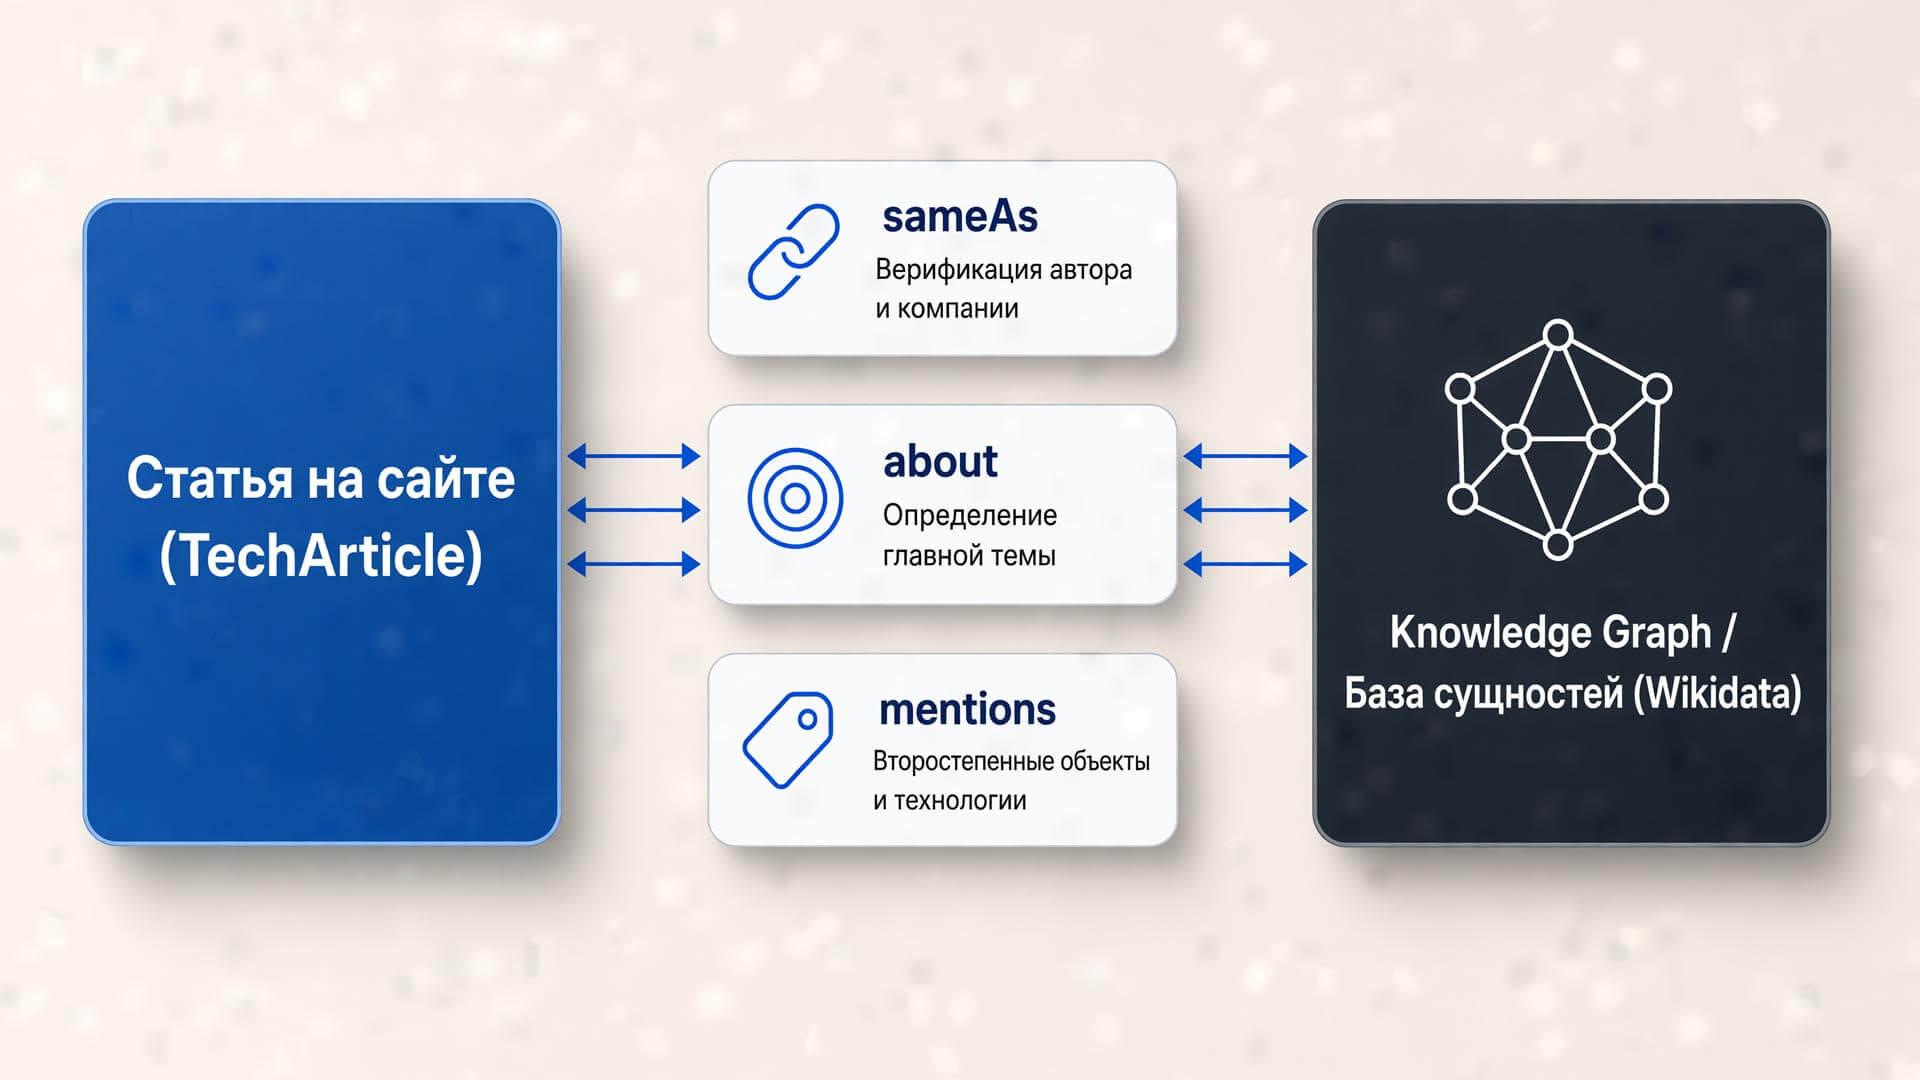
Три специфических атрибута играют главную роль при привязке локальных сущностей сайта к глобальным графам знаний (Knowledge Graphs, Wikidata, Wikipedia).
sameAs указывает на альтернативные URI объекта. Если страница через этот атрибут ссылается на Q-идентификатор Wikidata, а Wikidata через свойство P856 (official website) указывает обратно на сайт, формируется замкнутый граф. Алгоритмы entity reconciliation воспринимают такую двустороннюю связь как мощный сигнал достоверности.
about явно определяет главную тему документа. Это помогает алгоритмам устранить неоднозначность при распознавании терминов в контексте: например, отличить язык программирования Python от вида змей.
mentions перечисляет второстепенные объекты: программное обеспечение, персоны, организации или концепции, упомянутые в тексте. Атрибут расширяет семантический граф страницы, создавая плотный контекст для retrieval-систем.
Ниже представлен пример валидного кода для технической статьи с заполненными связями:
{
  "@context": "https://schema.org",
  "@type": "TechArticle",

  // Основные метаданные статьи
  "headline": "Микроразметка для LLM: как использовать Schema.org и JSON-LD для AEO",
  "datePublished": "2026-01-15",
  "dateModified": "2026-06-01",
  "inLanguage": "ru-RU",

  // Автор: Person с привязкой к внешним профилям
  "author": {
    "@type": "Person",
    "name": "Сергей Шабуров",
    "jobTitle": "Руководитель отдела SEO",
    "url": "https://kokoc.com/authors/sergej-shaburov/",
    // sameAs: связываем автора с профилями в соцсетях и Wikidata
    "sameAs": [
      "https://t.me/seo_pro_money",
      "https://www.linkedin.com/in/shaburov/"
    ]
  },

  // Издатель с логотипом
  "publisher": {
    "@type": "Organization",
    "name": "Kokoc.com",
    "logo": {
      "@type": "ImageObject",
      "url": "https://kokoc.com/logo.png"
    },
    // sameAs для организации: Wikidata, соцсети
    "sameAs": [
      "https://www.wikidata.org/wiki/Q123456789",
      "https://vk.com/kokoc_com"
    ]
  },

  // about: основная тема со ссылкой на Wikidata
  "about": [
    {
      "@type": "Thing",
      "name": "Структурированные данные",
      "url": "https://www.wikidata.org/wiki/Q7846"
    },
    {
      "@type": "Thing",
      "name": "Оптимизация для поисковых систем",
      "url": "https://www.wikidata.org/wiki/Q180711"
    }
  ],

  // mentions: все значимые сущности, упомянутые в тексте
  "mentions": [
    {
      "@type": "SoftwareApplication",
      "name": "Google Search Console",
      "url": "https://search.google.com/search-console"
    },
    {
      "@type": "Organization",
      "name": "Schema.org",
      "url": "https://schema.org"
    },
    {
      "@type": "Thing",
      "name": "RAG (Retrieval-Augmented Generation)",
      "url": "https://www.wikidata.org/wiki/Q120119878"
    }
  ],

  // Страница публикации
  "mainEntityOfPage": {
    "@type": "WebPage",
    "url": "https://kokoc.com/blog/mikrorazmetka-dlya-llm/"
  }
}
Пошаговый алгоритм внедрения JSON-LD для AI-поиска
Настройка микроразметки для aeo требует системного подхода. Процесс внедрения состоит из шести ключевых этапов, объединяющих техническую часть и контентную оптимизацию.
- Аудит сущностей на странице. Определите все значимые объекты: персоны, компании, продукты, термины. Для каждой сущности найдите соответствующий Q-идентификатор в базе Wikidata для заполнения атрибута
sameAs. - Passage-Level Optimization (оптимизация чанков). Разбейте текст на самодостаточные блоки под заголовками H2-H3. ИИ анализирует фрагменты, поэтому каждый абзац должен содержать прямой ответ на потенциальный интент без лишних вводных конструкций.
- Выбор релевантных словарей. Применяйте максимально специфичные классы.
LocalBusinessдает больше контекста, чем общаяOrganization.TechArticleточнее описывает руководство, чем базоваяArticle. - Генерация кода. Сформируйте скрипт с акцентом на связи. Убедитесь, что объекты вложены друг в друга логически: компания выступает издателем, эксперт — автором, а тема раскрыта через
about. - Grounding & Authority Signals. Добавьте в текст и код ссылки на исследования, точные даты и проверяемые факты. ИИ-системы «якорят» ответы на авторитетные источники, отсеивая неподтвержденную информацию.
- Валидация и деплой. Проверьте синтаксис через Schema Markup Validator и Rich Results Test. После публикации убедитесь, что боты (включая OAI-SearchBot и PerplexityBot, если они не заблокированы) имеют доступ к директориям со скриптами.
О том, как комплексно подготовить ресурс и попасть в AI-сниппеты, подробно рассказано в пошаговом руководстве по AI-поиску.
Чек-лист внедрения разметки для ИИ
Используйте этот список проверок при аудите перед запуском продвижения сайта в нейросетях. Чек-лист разделен на три функциональных блока.
Базовая разметка
- код реализован в формате JSON-LD, встроен в тег
<script>и проходит валидацию без критических ошибок; - для каждого применяемого типа заполнены все обязательные свойства: name, url, description, image;
- даты публикации и обновления указаны строго в формате ISO 8601 (YYYY-MM-DD);
- классы на странице связаны между собой иерархически: FAQPage содержит mainEntity, Article ссылается на Organization через publisher.
Разметка сущностей
- каждый ключевой объект (Person, Organization, Product) размечен явно с присвоением уникальных идентификаторов;
- применены наиболее узкие и специфичные типы из доступных в словаре;
- объекты связаны через свойства worksFor, memberOf, author, формируя локальный граф знаний;
- названия брендов и имена экспертов написаны единообразно во всех упоминаниях;
- вопросы и ответы структурированы через FAQPage или HowTo, длина ответа не превышает 580 символов;
- медиафайлы сопровождаются классом ImageObject с указанием url и подробного описания.
Разметка доверия (E-E-A-T)
- Article содержит блок author (Person с name, jobTitle и url) и publisher (Organization с name и logo);
- Product и Review включают aggregateRating с заполненными ratingValue и reviewCount;
- присутствуют datePublished и dateModified для подтверждения актуальности информации;
- для YMYL-тематик у автора прописаны jobTitle и sameAs со ссылкой на профессиональные сети;
- LocalBusiness содержит address, telephone и sameAs с ссылками на геосервисы для подтверждения физического существования бизнеса.
Кейс: как пересборка структуры увеличила цитирование в нейросетях в 6 раз
Команда Kokoc Performance провела внутреннее исследование на материалах собственного блога. Исходная ситуация: ряд статей стабильно занимал позиции в ТОП-5 органической выдачи, но в AI-ответах Яндекса и Google AI Overview практически отсутствовал, получая 1–2 цитирования в месяц.
Аудит выявил проблему: прямой ответ на пользовательский интент был смещен вниз после длинных вводных абзацев. Структура не соответствовала принципу «ответ прежде всего», а текстовые блоки не подходили для прямого извлечения алгоритмами. Высокие позиции в классическом SEO не гарантировали присутствие в генеративной выдаче.


Работы включали пересборку архитектуры контента по принципу чанкирования. Специалисты переработали заголовки H2–H3, добавили самодостаточные блоки с явными ответами и усилили E-E-A-T-сигналы. Была внедрена глубокая schema org для llm: добавлены FAQPage, атрибуты dateModified, about и mentions.
Результат: статья про хакатоны выросла с 2 до 12 цитирований в AI-ответах за два месяца, показав рост в 6 раз. Статья про диаграмму Исикавы начала регулярно появляться в генеративной выдаче. Как отмечает Lead SEO специалист DrMax, в эпоху AI Overviews структура, а не текст, становится главным оружием. Стратегия заключается в том, чтобы сделать контент настолько легким для машинного анализа, что поисковику будет экономически выгоднее использовать ресурс как источник фактов, а не синтезировать ответ с нуля.

Подробнее об эксперименте читайте в кейсе Kokoc Group.
оптимизация под AI-выдачу не заменяет SEO, а переводит работу с контентом на следующий уровень: через жесткую структуру, актуальность данных и усиление E-E-A-T-сигналов. Страницы с отличными органическими позициями могут быть полностью проигнорированы нейросетями, если их данные трудно извлечь.
Специфика разметки для разных типов сайтов
Общие принципы работы со структурированными данными универсальны, но акценты смещаются в зависимости от бизнес-модели проекта. Рассмотрим ключевые сценарии.
Schema.org для интернет-магазинов: разметка Product для AI-ассистентов
Для e-commerce фундаментальным классом выступает Product. Обязательные атрибуты включают name, description, image, offers (с указанием price, priceCurrency и availability) и aggregateRating. Недавно добавленная поддержка MemberProgram позволяет передавать данные о скидках для участников программы лояльности прямо в поисковую выдачу. Это повышает кликабельность и помогает AI-ассистентам корректно сравнивать коммерческие предложения разных магазинов.
Для категорийных страниц необходимо применять CollectionPage с вложенными элементами ItemList. Такая иерархия помогает нейросетям понять структуру каталога и точно отвечать на запросы о наличии товаров в конкретной категории. Отзывы покупателей размечаются через Review с атрибутами reviewRating, author и datePublished, что служит сильным сигналом достоверности.
Микроразметка для SaaS: SoftwareApplication и HowTo в AEO
Для SaaS-платформ базовым классом служит SoftwareApplication. Заполнение полей name, applicationCategory, operatingSystem, offers и aggregateRating позволяет AI-ассистентам корректно описывать функционал продукта при формировании сравнительных таблиц с конкурентами.
Инструкции и технические гайды размечаются через HowTo. Каждый шаг руководства оборачивается в HowToStep с атрибутами name (краткое название этапа) и text (подробное описание действий). Названия шагов в коде должны строго совпадать с формулировками в подзаголовках статьи. Языковая модель извлекает последовательность действий именно из структурированного списка.
внедрение HowToStep — это ситуация, когда код буквально пишет ответ за контент-мейкера. Алгоритму проще взять готовую последовательность из JSON-LD, чем пытаться вычленить шаги из сплошного полотна текста.
Дополнительно в документацию внедряется FAQPage для блоков с частыми вопросами. Подробнее о создании таких разделов читайте в нашем гайде.
Как LLM-модели читают Schema.org: процесс извлечения фактов
Процесс обработки данных поисковыми AI-системами проходит несколько стадий. Сначала краулер сканирует документ и передает скрипты на парсинг отдельно от HTML-контента. Затем система NER (Named Entity Recognition) идентифицирует типы объектов. Каждая сущность получает набор параметров: Salient Terms (ключевые дескрипторы), уникальный @id, Confidence Score (уровень уверенности алгоритма в достоверности) и вектор связей с другими объектами.
На основе этих данных строится локальный направленный граф страницы G(E, R), где E обозначает сущности, а R — отношения между ними (иерархические, функциональные, причинно-следственные). Система выявляет «семантические лакуны» и заполняет их. Чем плотнее и логичнее выстроен граф, тем выше вероятность попадания фрагмента в retrieval-пул при генерации ответа.
О том, как работают алгоритмы и выстраивается продвижение сайта в нейросетях через GEO и AEO, читайте в полном руководстве. Также полезно изучить механику работы Google SGE и изменения в логике ранжирования.
Часто задаваемые вопросы о микроразметке для нейросетей
Ответы в этом разделе подготовлены с учетом требований к чанкированию и готовы к извлечению алгоритмами.
Нужно ли удалять старую Microdata при переходе на JSON-LD?
Немедленное удаление не требуется. Скрипты встраиваются изолированно и не конфликтуют с существующей Microdata на уровне HTML-тегов. Оптимальная стратегия миграции: добавить новый код параллельно, проверить корректность через валидаторы, убедиться в отсутствии дублирующих противоречивых сигналов, и только после этого постепенно вычищать устаревшие атрибуты из верстки. Резкое удаление без тестирования приводит к временной потере расширенных сниппетов.
Понимают ли LLM-модели нестандартные типы Schema.org?
Нейросети работают с объектами через семантическое понимание контекста, а не через жесткий реестр допустимых классов. Нестандартный тип не игнорируется полностью: модель извлекает информацию через базовые атрибуты name, description и связанные элементы. Однако приоритет всегда отдается стандартизированным классам, так как они дают системе однозначный сигнал. Для оптимизации под генеративные ответы применяйте только официальные типы из словаря, чтобы минимизировать риск неверной классификации.
Как проверить, правильно ли нейросеть считывает разметку?
Проверка проводится в несколько этапов. Google Rich Results Test выступает официальным валидатором, показывающим ошибки синтаксиса и пропущенные обязательные поля. Яндекс Вебмастер проверяет корректность считывания локальными системами. После публикации необходимо отслеживать появление расширенных результатов в панелях для вебмастеров. Критически важно убедиться, что директории со скриптами и страницы с Organization Schema не заблокированы правилами в файле robots.txt, иначе поисковик не сможет разрезолвить идентификаторы сущностей.
Если вас интересует автоматизация рутинных процессов, ознакомьтесь с материалом о том, как применять Chat GPT для SEO.
Коротко о главном
- Подготовка данных для языковых моделей — обязательный технический фундамент для работы с AI-поиском. Алгоритмы оценивают контент на уровне небольших фрагментов, и машиночитаемый код дает им однозначные факты для синтеза ответов.
- Предпочтительный формат внедрения — JSON-LD. Он рекомендован поисковыми системами, не ломает верстку и корректно обрабатывается при динамической генерации.
- Базовый стек для попадания в быстрые ответы включает Article, FAQPage и Organization с детально заполненными атрибутами sameAs, dateModified и author.
- Свойства sameAs, about и mentions создают прочные связи с глобальными графами знаний, снижая неоднозначность при распознавании терминов.
- Класс ClaimReview постепенно выводится из поддержки, поэтому строить стратегию оптимизации вокруг него нецелесообразно.
- Для e-commerce приоритетным остается Product с aggregateRating и MemberProgram. Для SaaS-проектов — SoftwareApplication и детализированный HowTo.
- Высокие позиции в классической органике не гарантируют видимость в AI-поиске. Пересборка структуры текста под чанкирование и внедрение кода кратно увеличивают частоту цитирования бренда.
- Любые изменения в коде требуют обязательной проверки через официальные валидаторы Google и Яндекса перед публикацией на боевом сервере.

.png)
.png)



Комментарии (3)
Оставить комментарий