


- Что такое AI и AEO аудит сайта
- Чек-лист AI и GEO-аудита сайта
- Как подготовить сайт к ИИ-поиску
- Ошибки оптимизации под генеративный поиск
- Часто задаваемые вопросы (FAQ)
- GEO-аудит сайта от Kokoc.com
- Коротко о главном
Что такое AI и AEO аудит сайта
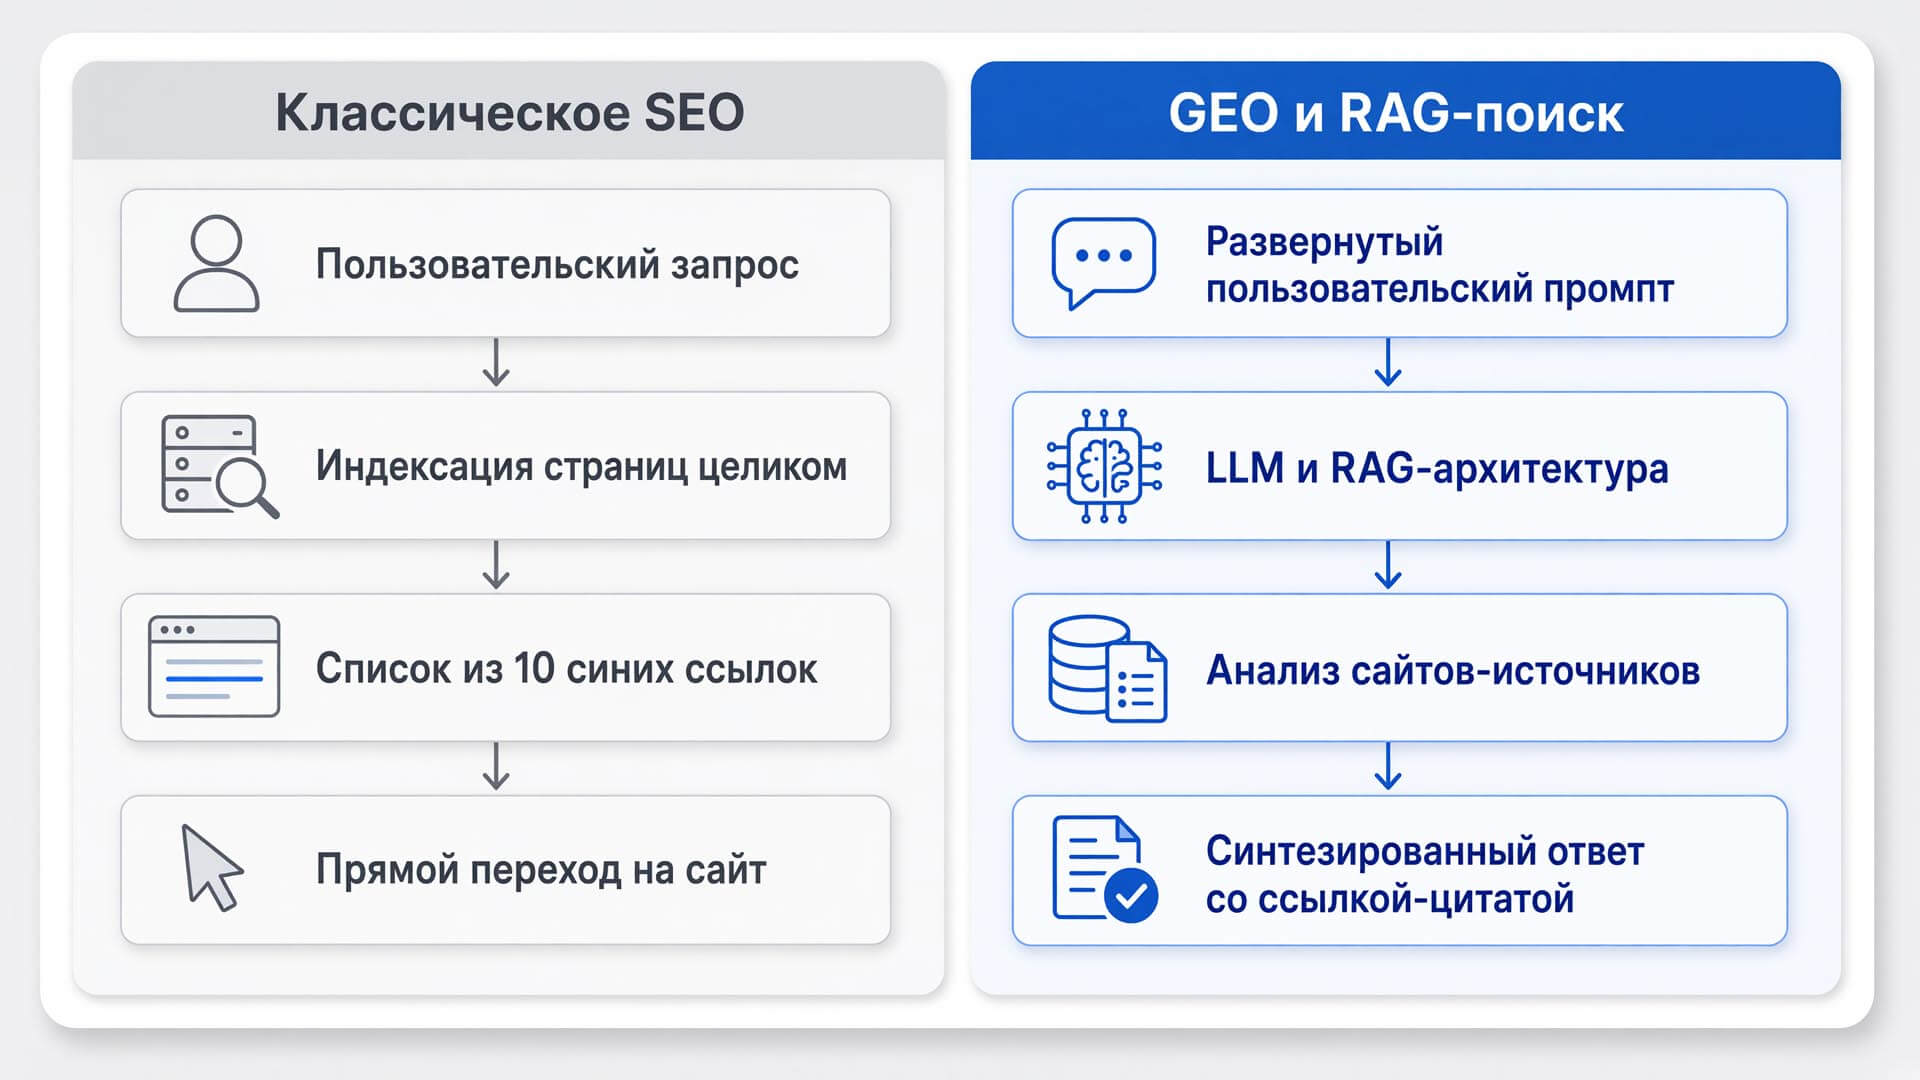
Генеративный поиск радикально изменил механику взаимодействия пользователя с информацией. Человек формулирует развернутый вопрос и моментально получает синтезированный ответ, минуя стадию изучения десяти синих ссылок. Статистика подтверждает смену парадигмы: Google отображает панели AI Overviews (SGE) для 86,8 % всех поисковых запросов. При этом более 90 % ссылок, которые нейросеть использует в качестве источников, не совпадают с топ-10 классической органической выдачи. В таких условиях ресурс конкурирует не за позицию в SERP, а за право стать доверенной базой знаний для языковой модели. Именно эту задачу решает ai аудит сайта, оценивая техническую и контентную базу проекта.
Профессиональный аудит сайта для нейросетей представляет собой глубокую проверку доступности ресурса для специализированных краулеров. Анализируется корректность считывания структуры DOM-дерева, наличие упоминаний бренда в ответах ChatGPT, Perplexity, Gemini и Яндекс Алисы. В свою очередь, aeo аудит сайта (Answer Engine Optimization) фокусируется на адаптации контента под форматы быстрых ответов. Главная цель — структурировать данные так, чтобы искусственный интеллект извлек конкретный фрагмент текста в качестве безальтернативного ответа. Концепция GEO (Generative Engine Optimization) объединяет эти направления, смещая фокус с плотности ключевых слов на семантическую архитектуру, доказательную авторитетность и плотность цифрового следа компании на внешних трастовых площадках.
Технологическим фундаментом генеративной выдачи выступает архитектура RAG (Retrieval-Augmented Generation). Алгоритм функционирует в три этапа: извлечение релевантных фрагментов из векторной базы данных, помещение их в изолированный контекст языковой модели и генерация итогового текста с простановкой ссылок на первоисточники. Единицей ранжирования выступает не страница целиком, а атомарный смысловой чанк объемом 150–400 токенов. Если материал представляет собой монолитное полотно без четкой иерархии, система физически не способна вычленить из него фактологию. Подробнее о том, как оптимизировать сайт и попасть в AI-сниппеты Google и Яндекс Нейро, рассказано в профильном руководстве.

Чек-лист AI и GEO-аудита сайта
Практический чек-лист ai-аудита сайта базируется на трех фундаментальных кластерах: техническая доступность, информационная плотность контента и подтвержденная авторитетность сущностей. Подобное разделение зеркально отражает логику работы генеративных алгоритмов. Сначала краулер должен беспрепятственно просканировать код, затем алгоритм MUVERA (Multi-Vector Retrieval) разбивает текст на passage-level векторы для оценки смысловой нагрузки, и на финальном этапе система проверяет траст источника. Последовательная проверка каждого кластера гарантирует комплексную готовность сайта к генеративному поиску.
Блок 1. Техника и краулинг AI-ботами
Базовый аудит сайта для генеративного поиска стартует с анализа технической доступности. Первоочередная задача — проверка файла robots.txt на предмет блокировок специализированных агентов. Важно дифференцировать тренировочных ботов (GPTBot, ClaudeBot, Google-Extended), собирающих данные для обучения моделей, и поисковых retrieval-краулеров (OAI-SearchBot, PerplexityBot), формирующих ответы в реальном времени. Блокировка первых защищает авторский контент от поглощения, тогда как запрет для вторых полностью исключает ресурс из генеративной выдачи. Максимальный размер файла инструкций ограничен 500 КБ для Google и 32 КБ для Яндекса.
Следующий этап технической валидации — настройка систем защиты от DDoS-атак. Практика показывает, что решения уровня Cloudflare или WAF часто классифицируют запросы AI-краулеров как аномальную активность, отдавая ошибку 502 Bad Gateway. Для предотвращения блокировок требуется внесение IP-диапазонов поисковых систем в whitelist и снижение чувствительности режима Bot Fight Mode. Параллельно проводится ревизия DOM-дерева: исключается скрытие контента через CSS-свойство display:none, удаляются пустые узлы, затрудняющие парсинг. Критическое значение приобретает микроразметка Schema.org. Внедрение типов LocalBusiness, FAQPage, Article и Person формирует структурированный каркас, позволяющий алгоритмам безошибочно идентифицировать факты.
| Название AI-бота | User-Agent для robots.txt | Принадлежность (Чья нейросеть) |
|---|---|---|
| GPTBot | GPTBot | OpenAI (ChatGPT) |
| ClaudeBot | ClaudeBot | Anthropic (Claude) |
| Google-Extended | Google-Extended | Google (Gemini / SGE) |
| PerplexityBot | PerplexityBot | Perplexity AI |
Блок 2. Контент и Information Gain
Трансформация пользовательского поведения привела к доминированию Conversational Search. Средняя длина запроса увеличилась до 7–9 слов, а доля zero-click поиска достигла 58,5 %. Люди формулируют длинные, детализированные вопросы естественным языком. Контентная стратегия обязана адаптироваться под механизм Query Fan-Out, при котором языковая модель дробит один сложный промпт на десяток микро-запросов для агрегации исчерпывающего ответа. Тексты необходимо структурировать по принципу перевернутой пирамиды: прямой ответ размещается в первом абзаце раздела, а расширенная аргументация и детали — ниже. Внедрение блоков TL;DR (краткая выжимка) в начале лонгридов существенно повышает вероятность захвата сниппета.
Ключевым фактором ранжирования в эпоху LLM становится Information Gain — показатель информационного прироста. Нейросети пессимизируют вторичные компиляции, отдавая приоритет страницам, содержащим уникальные статистические выкладки, результаты собственных исследований и подтвержденный практический опыт. Высокая информационная плотность требует полного отказа от вводных конструкций и общих рассуждений в пользу точных цифр. Эксперименты доказывают: разделение текста на чистые тематические блоки (чанки) с релевантными подзаголовками повышает retrieval score на 10–15 % по сравнению с неструктурированными массивами текста. Детальный разбор методологии представлен в материале про продвижение сайта в нейросетях по стандартам GEO.
Блок 3. Авторитетность и Entity SEO
Языковые модели анализируют информационное пространство через призму сущностей (Entities) и связей между ними, формируя глобальный граф знаний. Авторитетность ресурса выстраивается за счет жесткой связки бренда, профильных услуг и конкретных авторов. Размытые формулировки недопустимы: позиционирование должно быть предельно точным. Прокачка Entity SEO требует создания детализированных страниц специалистов с указанием реального опыта, сертификаций и ссылок на внешние профессиональные профили. Алгоритмы Google отслеживают репутацию создателей контента через внутренние метрики, накапливая траст независимо от конкретного домена.
Усиление сигналов E-E-A-T (Experience, Expertise, Authoritativeness, Trustworthiness) напрямую коррелирует с частотой попадания в генеративные ответы. Страницы, подкрепленные ссылками на независимые исследования и содержащие валидную разметку авторов, цитируются в два раза чаще конкурентов. Важную роль играет управление репутацией (SERM). Поскольку LLM обучаются на всем массиве доступных данных, тональность упоминаний компании на внешних трастовых площадках формирует цифровой след, определяющий контекст ответов нейросети. О правилах создания экспертного контента в эпоху нейросетей можно узнать из профильной статьи.
Фундаментальный принцип Entity SEO заключается в том, что алгоритмы ищут не совпадения по ключевым словам, а подтвержденные связи между объектами реального мира. Если компания, продукт и эксперт не образуют логичный, семантически размеченный граф знаний, языковая модель проигнорирует источник из-за невозможности верифицировать данные.
Как подготовить сайт к ИИ-поиску
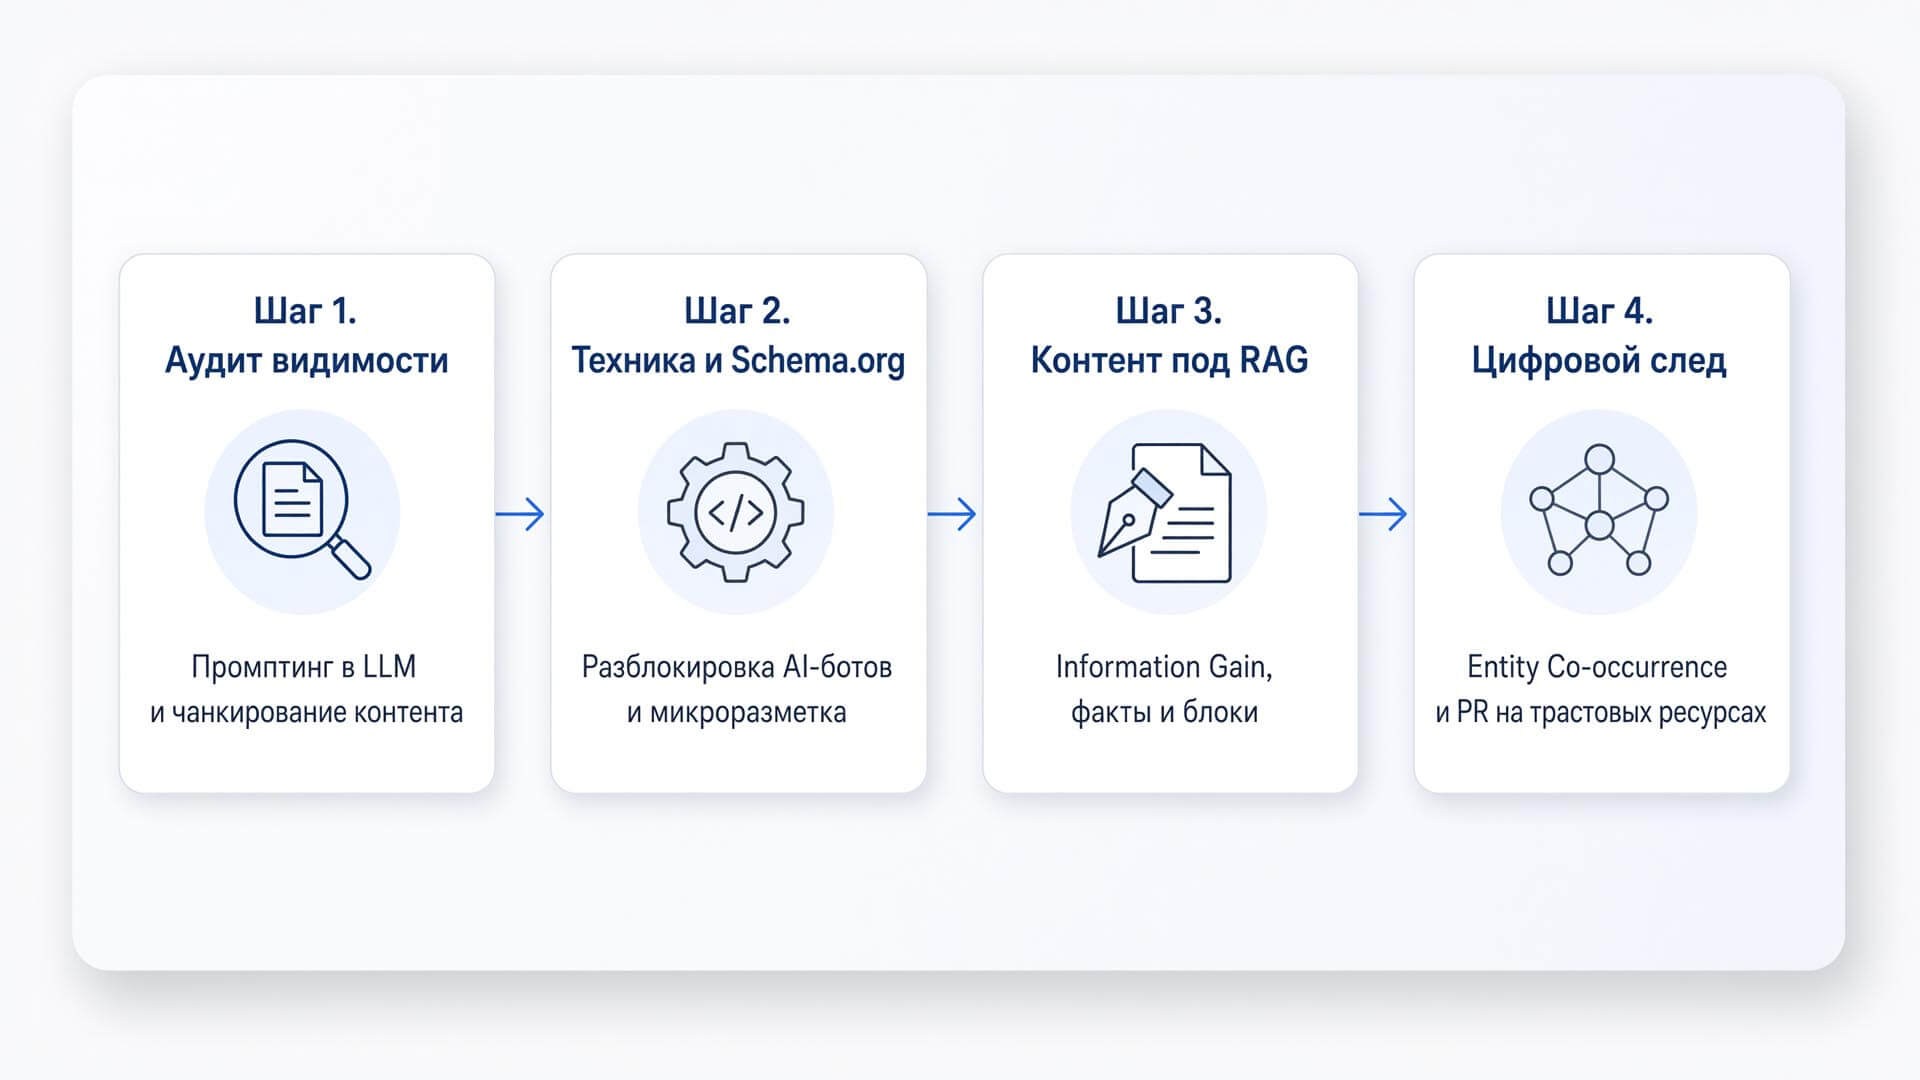
Полноценная подготовка сайта к ии поиску представляет собой алгоритмичный процесс, состоящий из четырех взаимосвязанных этапов. Игнорирование последовательности приводит к потере ресурсов: идеальная техническая база не сработает без фактологического контента, а качественные тексты останутся невидимыми при блокировке краулеров. Разберем, как подготовить сайт к ии поиску на практике.
Первый шаг — аудит текущей видимости и структурирование данных. Проводится ручной промптинг брендовых запросов в ChatGPT, Perplexity и Google SGE для фиксации базовых метрик. Параллельно запускается процесс дробления существующего контента на атомарные чанки. Целевой KPI на данном этапе: формирование 8–12 самодостаточных смысловых блоков на каждой посадочной странице с соблюдением строгой иерархии заголовков H2–H4.
Второй шаг — техническая разблокировка и внедрение семантической разметки. Проверяются логи серверов на предмет ошибок 502 от AI-ботов, корректируются правила WAF. Внедряется расширенная структура Schema.org (FAQPage, QAPage, DefinedTerm). Обязательное условие — валидация кода через инструменты поисковых систем. Целевой показатель технической оптимизации: время отрисовки основного контента (LCP) не должно превышать 2,5 секунды.
Третий шаг — переработка материалов под стандарты RAG. Тексты очищаются от маркетинговых штампов. В первые 150–200 слов интегрируются структурированные факты, идентифицирующие тему и подтверждающие экспертизу. Внедряются ответы на вопросы из блоков People Also Ask, что позволяет достичь 80 % покрытия смежных интентов. Каждый смысловой блок насыщается LSI-терминами и ссылками на первоисточники с указанием провенанса (автор, дата публикации).

Четвертый шаг — формирование внешнего цифрового следа (Entity Co-occurrence). Реализуется стратегия публикации гостевых материалов на авторитетных отраслевых порталах. Цель — создать плотную семантическую сеть упоминаний бренда в связке с профильными услугами. Чем больше независимых трастовых источников подтверждают компетенции компании, тем выше вероятность выбора ресурса в качестве канонического ответа.

Ошибки оптимизации под генеративный поиск
Адаптация проектов часто тормозится из-за применения устаревших паттернов. Наиболее критичная ошибка — случайная блокировка AI-краулеров на уровне CDN. Системы защиты идентифицируют нестандартные User-Agent как угрозу, отсекая ботов от сканирования. Ресурс функционирует штатно для пользователей, но полностью выпадает из баз данных языковых моделей. Не менее опасны синтаксические ошибки в файле robots.txt, где лишний пробел в директиве Disallow способен закрыть индексацию всего домена.
Вторая группа проблем связана с архитектурой текстов. Использование SEO-копирайтинга старого образца с искусственным внедрением ключевых фраз (keyword stuffing) воспринимается алгоритмами как манипуляция. Нейросети анализируют семантическую релевантность через призму сущностей, а не через плотность n-грамм. Отсутствие четкой иерархии заголовков приводит к тому, что парсер не может сегментировать полотно текста на логические блоки. Дополнительно негативно влияет использование датированных URL-адресов: страницы с указанием года в slug теряют накопленный исторический траст при ежегодном обновлении контента.
| Устаревший SEO-подход (Ошибка) | Современный GEO-подход (Решение) |
|---|---|
| Текст ради объема и вхождения ключей | Экстрактивное сжатие, Information Gain, блоки TL;DR |
| Маркетинговые слоганы в первых абзацах | Структурированные факты в первых 150 словах: тезис, E-E-A-T |
| Изолированная микроразметка | Вложенная разметка: FAQPage, Person, Organization со связями |
| Блокировка всех ботов для защиты контента | Разделение политик: тренировочные закрыты, поисковые открыты |
| Позиции в SERP как главная метрика | Оценка импрессии бренда и цитируемости в AI Overviews |
Распространенное заблуждение заключается в уверенности, что лидерство в классической органической выдаче автоматически транслируется в видимость для нейросетей. Практика доказывает обратное: страница может стабильно удерживать топ-3 по высокочастотному запросу, но полностью игнорироваться генеративными алгоритмами из-за низкой информационной плотности и отсутствия структурированных фактов.
Часто задаваемые вопросы (FAQ)
Повлияет ли SGE на трафик из органического поиска?
Внедрение генеративных ответов уже трансформирует распределение трафика. При активации панели SGE первая строка классической органики смещается вниз на 1562–1630 пикселей, что неизбежно снижает CTR (кликабельность). Информационные порталы фиксируют падение переходов на 20–30 %. Однако компании, интегрированные в AI-ответы, компенсируют эти потери ростом целевого брендового трафика до 65 %, получая максимально прогретую аудиторию.
Нужно ли создавать отдельный контент специально для AI?
Генерировать дублирующие версии страниц не требуется. Качественный материал, обладающий высокими показателями E-E-A-T, подтвержденной фактологией и строгой иерархией, эффективно обрабатывается как классическими поисковиками, так и языковыми моделями. Специфика заключается исключительно в формате подачи: приоритет отдается таблицам, маркированным спискам и прямым ответам в начале смысловых блоков.
Как отслеживать попадание сайта в ответы ChatGPT или Gemini?
Мониторинг осуществляется двумя путями. Базовый метод — регулярный ручной промптинг целевых запросов с фиксацией результатов. Профессиональный подход подразумевает использование специализированных платформ (BotricAI, brandfound, модули в Rush Analytics и Topvisor), которые автоматизируют парсинг упоминаний. Поскольку Google Search Console пока не выделяет AI Mode в отдельный сегмент отчетов, сторонние трекеры остаются единственным надежным инструментом аналитики.
Как правильно внедрить микроразметку для вопросов и ответов?
Для сохранения видимости в генеративных сниппетах требуется строгая реализация FAQPage Schema в формате JSON-LD. Обязательно использование массива mainEntity, включающего поля Question (текст вопроса) и Answer (текст ответа). Контент внутри разметки должен на 100 % совпадать с видимым текстом на странице. Корректная настройка раздела FAQ на сайте увеличивает вероятность попадания в AI-ответы на 55 %.
GEO-аудит сайта от Kokoc.com
Самостоятельная подготовка сайта к генеративному поиску сопряжена с высокими затратами времени и необходимостью глубокого погружения в архитектуру LLM-моделей. Чек лист geo аудита сайта включает десятки технических параметров, требующих специализированного софта для парсинга и валидации. Без понимания алгоритмов чанкирования и принципов работы RAG-систем классические SEO-усилия не приносят результата в новой парадигме.
Агентство Kokoc.com реализует комплексные стратегии адаптации бизнеса к эре искусственного интеллекта. Базовый пакет включает анализ цитируемости бренда по пулу промптов. Расширенные тарифы обеспечивают глубокий мониторинг видимости в 6+ нейросетях, техническую разблокировку краулеров, переработку семантической архитектуры и построение графа знаний. Интеграция AI SEO с общей маркетинговой стратегией позволяет гарантировать присутствие компании в ответах ведущих языковых моделей.
Профессиональный аудит выявляет скрытые технические барьеры и формирует точный план действий по захвату AI-сниппетов.
Коротко о главном
- Адаптация ресурса под требования языковых моделей — это не дополнение к классической оптимизации, а самостоятельный инженерный процесс. Высокие позиции в стандартной выдаче больше не гарантируют попадание в генеративные ответы, так как алгоритмы используют принципиально иные критерии оценки качества и достоверности информации.
- Необходимо дифференцировать правила в robots.txt: блокировка тренировочных ботов (GPTBot) защищает данные, а запрет поисковых агентов (PerplexityBot) исключает сайт из выдачи.
- Требуется внедрение связанной микроразметки Schema.org (Article, FAQPage, Organization) для формирования машиночитаемого графа знаний.
- Контент структурируется по принципу перевернутой пирамиды: прямой ответ размещается в начале блока, подробности и аргументация — ниже.
- Информационный прирост (Information Gain) за счет уникальных фактов и цифр критически важен для выбора страницы в качестве источника.
- Рекомендуется регулярно проверять настройки WAF и Cloudflare на предмет ошибочной блокировки IP-адресов AI-краулеров.
- Построение Entity SEO (связка бренда, авторов и услуг на внешних площадках) минимизирует риск галлюцинаций нейросети при формировании ответа.
- Для оценки эффективности применяются специализированные AI-трекеры, фиксирующие импрессию бренда в ответах языковых моделей.
.png)
.png)



Комментарии (1)
Оставить комментарий