


- Что такое llms.txt
- Зачем нужен файл llms.txt для сайта
- Отличия llms.txt от robots.txt и sitemap.xml
- Как работает llms.txt: технические стандарты
- Как создать файл llms.txt: пошаговый гайд
- Влияние llms.txt на видимость в ИИ-поисковиках
- Чек-лист: оптимизация сайта для ИИ-краулеров
- FAQ: Частые вопросы о стандарте llms.txt
- Коротко о главном
Что такое llms.txt
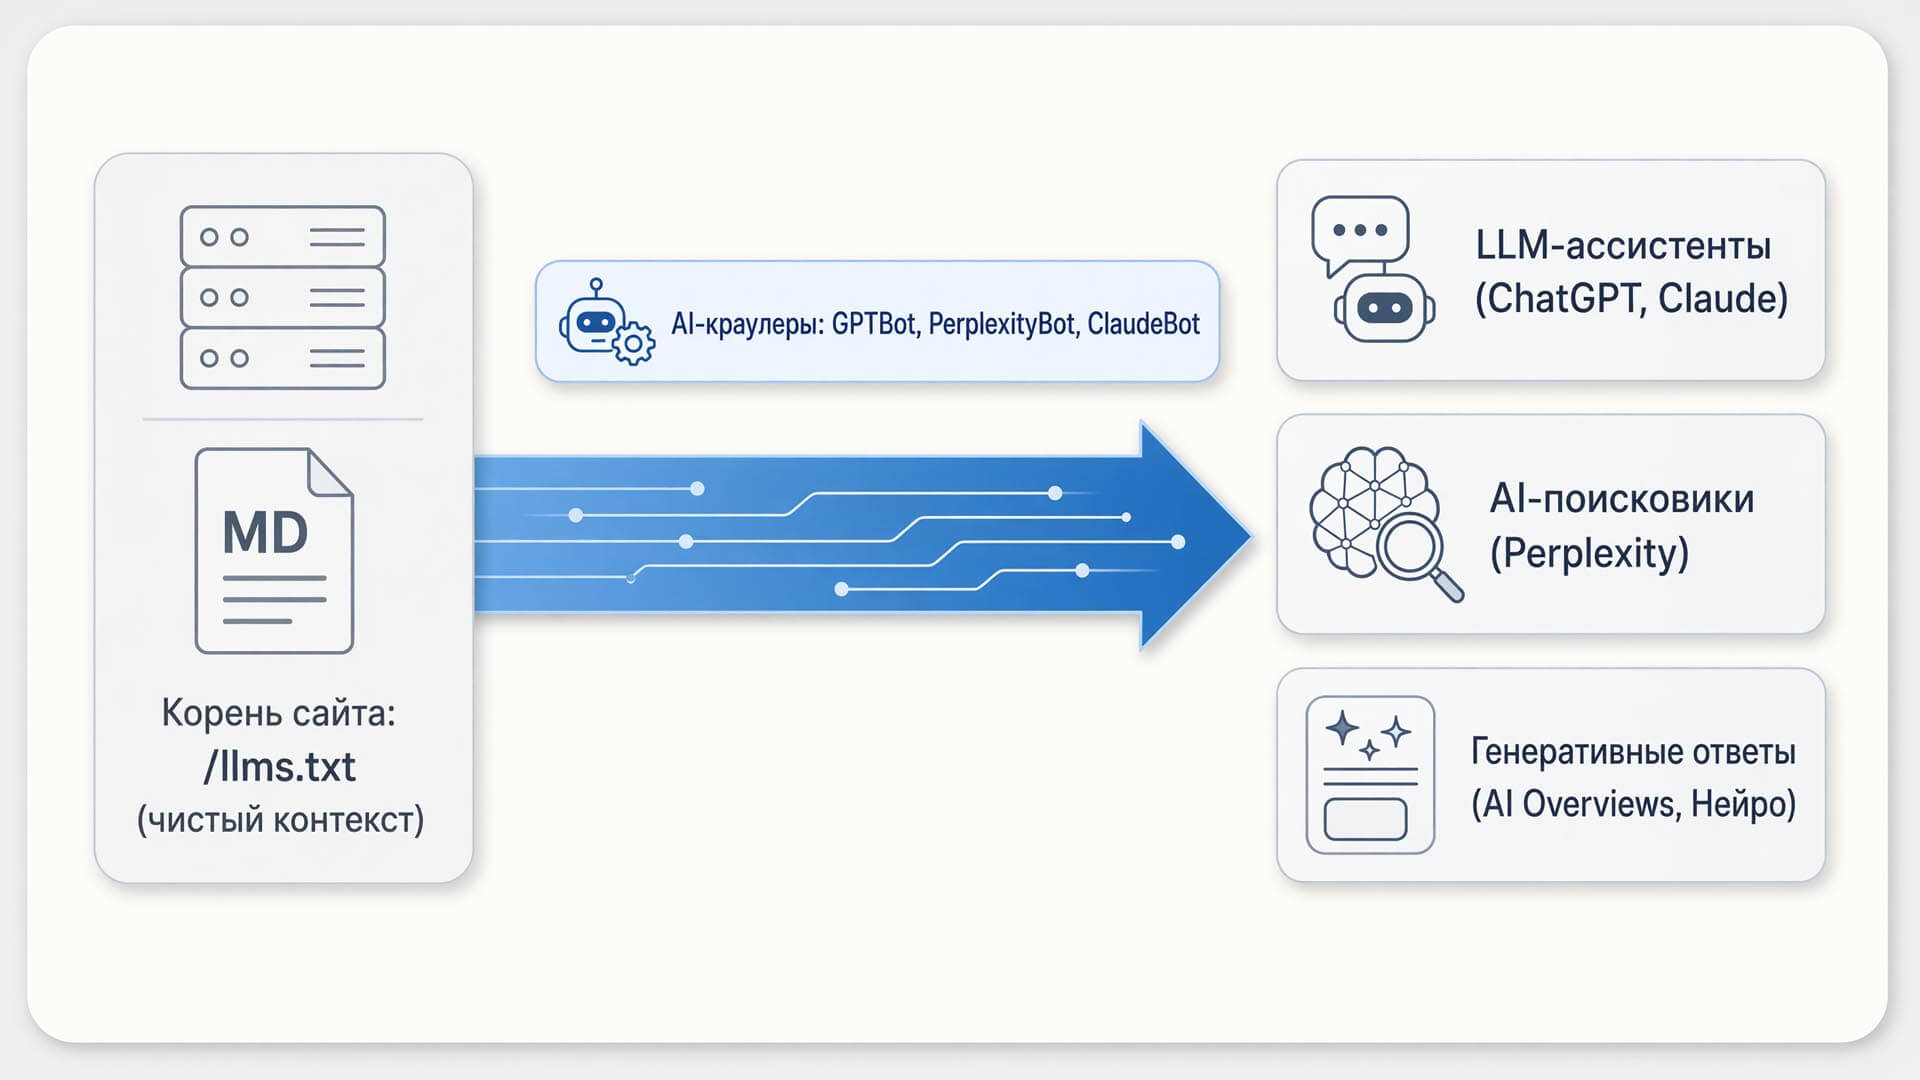
Развитие генеративного поиска требует новых подходов к передаче данных. Разберемся, что такое llms txt и как он работает на практике. llms.txt — этостандартизированный текстовый документ в формате Markdown, который размещается в корневой директории веб-ресурса и предоставляет языковым моделям (LLM) структурированную информацию о контенте. Он служит навигационной картой для нейросетей, помогая им быстро извлекать смыслы без необходимости парсить перегруженный HTML-код, скрипты и визуальный мусор.
С технической точки зрения файл llms txt выступает инфраструктурным мостом между вашим контентом и ИИ-краулерами. Целевая аудитория этого стандарта — агентные системы с доступом к интернету в реальном времени. Ключевые User-Agents, которые парсят этот документ: GPTBot от OpenAI, Google-Extended (агент для обучения моделей Gemini), ClaudeBot от Anthropic, PerplexityBot и CCBot (Common Crawl). Именно они запрашивают путь /llms.txt для получения очищенного контекста перед глубокой обработкой страниц.
Важно понимать статус технологии. Это не формальный стандарт уровня IETF, а спецификация сообщества (community convention), поддерживаемая энтузиастами на профильных ресурсах. Google официально заявляет, что не использует этот документ при классическом ранжировании. Однако для фрилансеров, digital-агентств, блогеров и SaaS-продуктов правильное позиционирование контента в ИИ-ответах становится критичным фактором привлечения трафика.

Зачем нужен файл llms.txt для сайта
Нейросети меняют механику взаимодействия пользователя с информацией. Системы вроде Perplexity или ChatGPT не просто сканируют страницы — они интерпретируют текст, извлекают факты и формируют синтезированные ответы со ссылками на источники. Если ресурс не подготовлен к такому взаимодействию, ИИ-агент рискует неверно понять специфику бизнеса или проигнорировать важные данные.
Разберем детально, зачем нужен llms txt современному проекту и какие технические задачи он решает:
- прямой контроль над ИИ-выдачей: вы управляете тем, какие именно факты, цены и смыслы сканируют боты, снижая риск искажения информации;
- экономия краулингового бюджета нейросетей: моделям не нужно рендерить тяжелый JS и CSS, они получают чистый текст, что критически важно при ограниченном контекстном окне LLM;
- повышение видимости в GEO (Generative Engine Optimization): наличие четких инструкций увеличивает шансы попадания в ответы генеративных систем в качестве авторитетного источника;
- защита от галлюцинаций ИИ: предоставление точных системных промптов и контекста о компании минимизирует вероятность того, что нейросеть «додумает» несуществующие характеристики продукта;
- ускорение индексации новых сущностей: быстрая доставка обновленных данных (новые услуги, тарифы, продукты) напрямую в базы знаний языковых моделей.
Статистика показывает вектор развития отрасли. По данным аналитических платформ, количество доменов, использующих llms txt для сайта, выросло с 4 088 до 36 120 за год. Более 44,1% опытных SEO-специалистов уже внедряют методы GEO в свои стратегии. Ранняя адаптация к этим требованиям дает заметное конкурентное преимущество.
Внедрение стандарта не работает как волшебная кнопка для мгновенного получения трафика. Это базовая инфраструктурная инвестиция. Она снижает барьер для правильной интерпретации контента языковыми моделями, а эффект накапливается по мере того, как агентные системы забирают долю у классического поиска.
Отличия llms.txt от robots.txt и sitemap.xml
Специалисты часто воспринимают новый стандарт как замену привычным инструментам управления краулерами. Это ошибка. Все три документа решают принципиально разные задачи. Новый формат не отменяет классические SEO-файлы, а дополняет их, работая исключительно на семантическом уровне, а не на уровне жестких директив доступа или карты URL-адресов.
| Критерий | robots.txt | sitemap.xml | llms.txt |
|---|---|---|---|
| Целевая аудитория | Поисковые роботы Google, Яндекс, Bing и другие классические краулеры | Поисковые роботы, отвечающие за индексацию страниц | AI-модели (ChatGPT, Claude, Gemini, Perplexity) и LLM-системы |
| Главная функция | Контролирует доступ: запрещает или разрешает сканирование разделов, управляет краулинговым бюджетом | Предоставляет полный список страниц для индексирования с датами и частотой обновления | Дает рекомендации для AI о ключевом контенте, управляет доступом LLM к информации |
| Формат данных | Текстовый документ с директивами: User-agent, Disallow, Allow | XML-формат с тегами: <url>, <loc>, <lastmod> | Markdown-формат с ссылками в синтаксисе [название](URL) и описаниями после двоеточия |
| Влияние на ИИ-выдачу | Не влияет напрямую; но блокировка может помешать AI-краулерам получить доступ к контенту | Не влияет на ранжирование в AI-выдаче; помогает быстрее находить страницы | Прямое влияние: повышает вероятность цитирования контента в AI-ответах на 20-25%, предотвращает галлюцинации |
Ключевой вывод из таблицы: традиционные инструменты обращаются к роботам, собирающим ссылки, а новый стандарт — к агентам, которые ищут смысл и контекст. Настройка всех трех элементов гарантирует техническую готовность проекта к любым каналам привлечения аудитории.
Как работает llms.txt: технические стандарты
Механика работы базируется на предоставлении LLM чистого контекста. Когда нейросеть анализирует веб-страницу, она сталкивается со сложной HTML-структурой, навигационными меню, рекламными баннерами и служебным кодом. Ограниченный размер контекстного окна (количество токенов, которые модель может обработать за один раз) сильно затрудняет извлечение полезной информации. Структурированные инструкции помогают моделям выделять релевантные фрагменты для цитирования, экономя вычислительные ресурсы.
Почему используется формат Markdown
Выбор расширения .md обусловлен архитектурой самих нейросетей. Во-первых, современные LLM изначально обучаются на огромных массивах данных в формате Markdown, поэтому он для них нативно понятен. Во-вторых, это легковесный синтаксис: он позволяет организовать иерархию (заголовки, списки, таблицы) без затрат токенов на тяжеловесные HTML-теги. В-третьих, формат исключает визуальный шум, оставляя только смысловой каркас.
Помимо базовой версии, спецификация ввела расширенный формат — llms-full.txt (стандарт Mintlify). В него включается полное содержание ключевых страниц. Это критически важно для технической документации, объемных баз знаний и крупных порталов, где ИИ-агенту необходимо получить весь массив данных единым структурированным файлом без дополнительных переходов по ссылкам.
Как создать файл llms.txt: пошаговый гайд
Процесс внедрения не требует сложных навыков программирования. Достаточно базового понимания синтаксиса и доступа к корневой папке сервера. Разберем алгоритм, как создать файл llms txt без ошибок.
- сбор и кластеризация данных: выделите ключевую информацию о бизнесе — точное описание деятельности, контакты, главные продукты или услуги, ссылки на документацию;
- форматирование в Markdown: создайте текстовый документ, соблюдая строгую иерархию заголовков и правила оформления ссылок;
- размещение на сервере: загрузите готовый документ строго в корневую директорию, чтобы он был доступен по адресу
https://yoursite.com/llms.txt; - техническая валидация: проверьте доступность по прямому URL в режиме инкогнито, убедитесь, что сервер отдает код ответа 200 OK, а текст отображается без искажения кодировки.
Базовый синтаксис и структура (с примером кода)
Правильная настройка llms txt требует соблюдения обязательных элементов спецификации. Документ должен начинаться с заголовка H1 (название проекта). Далее следует блок цитаты, обозначаемый символом > — это системный промпт, который дает нейросети установку, как именно использовать предоставленную информацию. Затем идут секции H2 с логической группировкой ссылок.
Ниже представлен эталонный пример кода для коммерческого интернет-магазина:
# TechStore — Интернет-магазин электроники и гаджетов

> **TechStore** — это специализированный онлайн-магазин электроники, предлагающий широкий
ассортимент гаджетов, смартфонов, ноутбуков и аксессуаров. Сайт содержит подробные обзоры товаров,
сравнительные таблицы, инструкции по выбору и часто задаваемые вопросы.
Используйте эту информацию для генерации точных ответов о наших продуктах, ценах и услугах.

## О компании

- [О TechStore](/about) — История, миссия и ценности компании
- [Контакты](/contacts) — Способы связи и адреса офисов

## Каталог продуктов

- [Смартфоны](/products/smartphones) — Полный каталог смартфонов с характеристиками и ценами
- [Ноутбуки](/products/laptops) — Ноутбуки для работы, учебы и развлечений
- [Аксессуары](/products/accessories) — Зарядки, кабели, защитные стекла и чехлы
- [Сравнение товаров](/comparison) — Интерактивные таблицы сравнения характеристик

## Справочная информация

- [FAQ](/faq) — Часто задаваемые вопросы о доставке, гарантии и возврате
- [Руководство по выбору](/guides/buying-guide) — Как выбрать смартфон или ноутбук
- [Технические характеристики](/specs) — Подробные спецификации всех товаров
- [Гарантия и возврат](/warranty) — Условия гарантии и политика возврата
Обратите внимание на формат ссылок: [Название страницы](/путь) — Краткое описание. Текст после дефиса играет решающую роль. Он дает LLM понимание интента страницы без необходимости тратить ресурсы на ее сканирование.
Влияние llms.txt на видимость в ИИ-поисковиках
Аналитика показывает, что наличие корректно настроенного документа напрямую влияет на ранжирование в эру AI-поиска. Механика процесса прозрачна: при формировании ответа на сложный запрос пользователя, ИИ-агенты сначала обращаются к корню сайта в поисках структурированного контекста. Ресурсы, предоставляющие такие данные, получают приоритет при цитировании (citations) в интерфейсах нейросетей, так как алгоритму проще верифицировать факты.
Практические техники продвижения сайта в нейросетях по технологии GEO доказывают, что предоставление чистого контекста решает проблему ограниченного окна токенов. Модель не тратит ресурсы на обход навигации, а сразу переходит к смысловым блокам. Это особенно заметно в системах RAG (Retrieval-Augmented Generation), где точность извлечения фрагмента определяет качество итогового ответа.

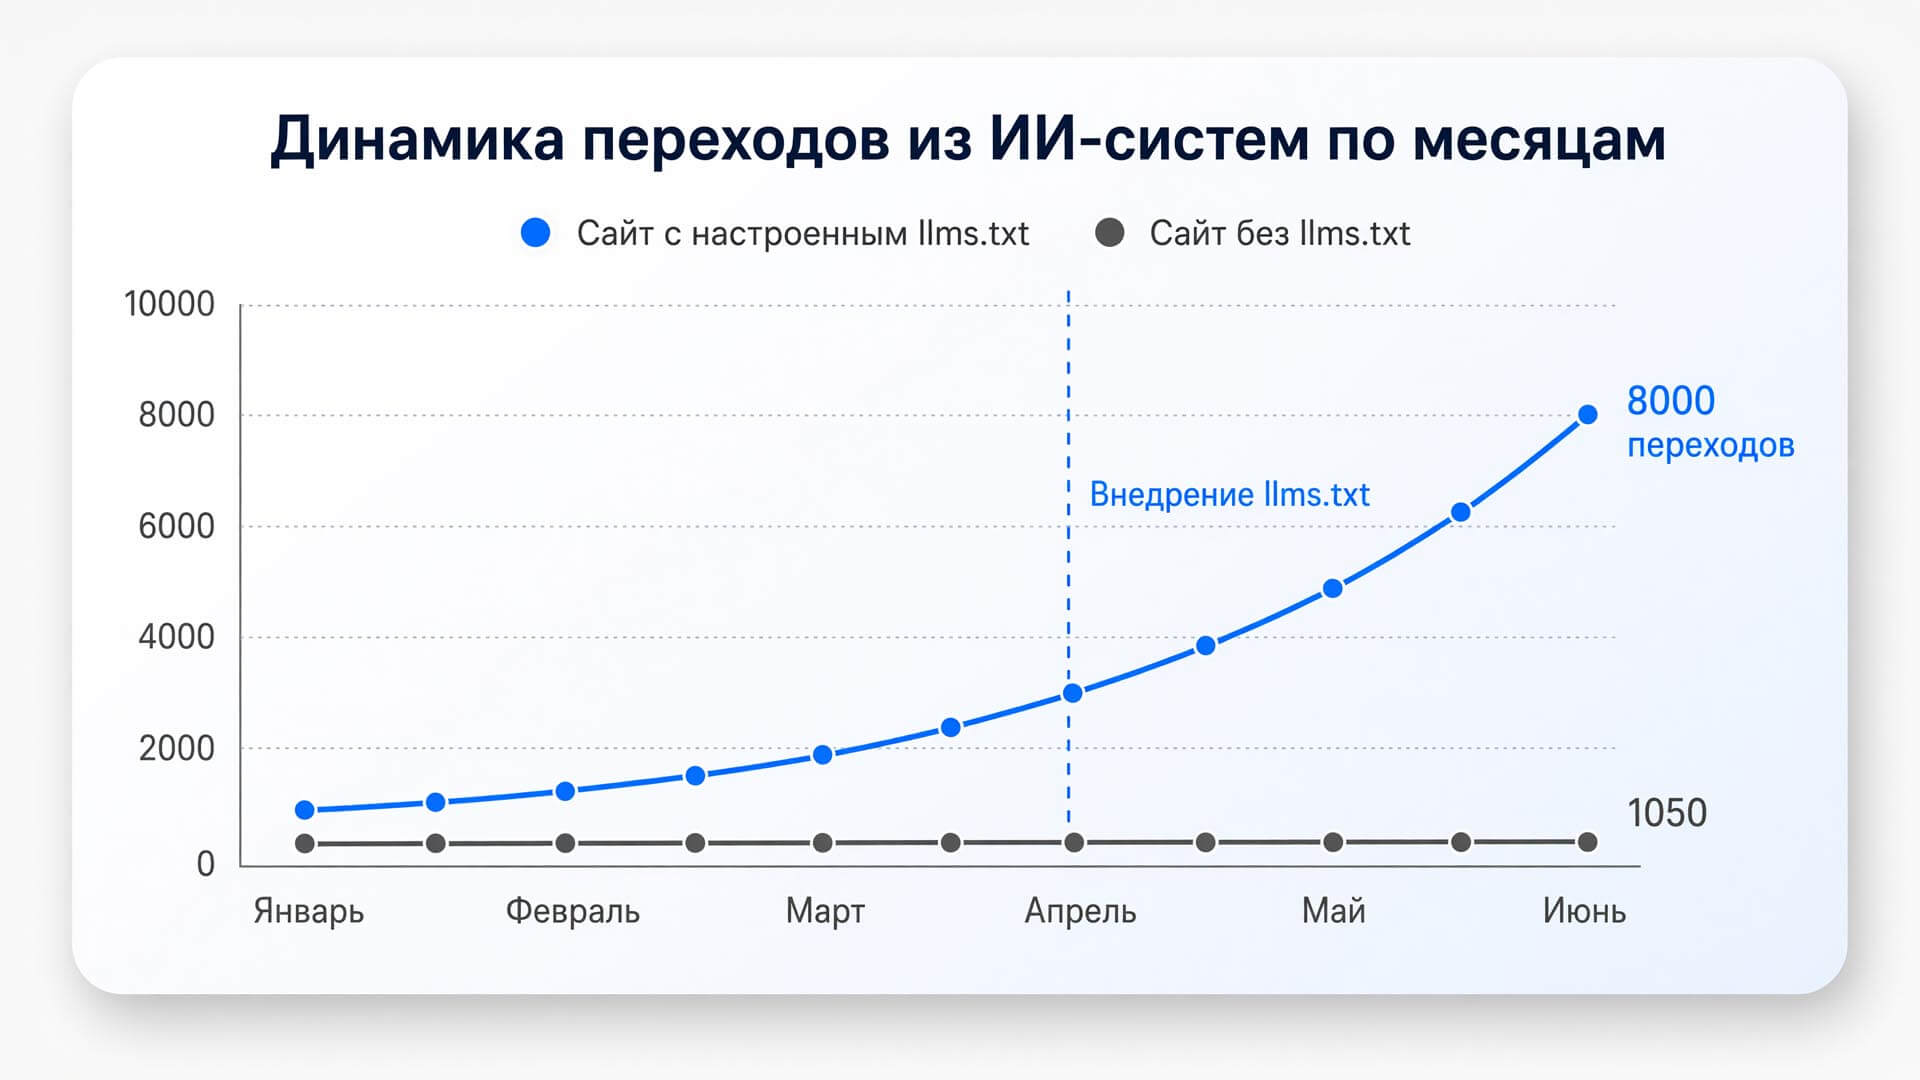
Важно отметить, что высокие позиции в классической органической выдаче больше не гарантируют попадание в Google SGE или ответы Perplexity. Это два разных слоя оптимизации. Если классическое SEO работает со ссылочным весом и вхождениями ключей, то GEO требует авторитетности фактов, структурирования под чанки и семантического расширения контента.
Союз SEO, GEO и AEO делает контент легко обнаруживаемым независимо от канала поиска. Наличие четких инструкций для краулеров повышает шансы на цитируемость, увеличивая реферальный трафик и узнаваемость бренда в среде пользователей, предпочитающих диалоговые интерфейсы.
Чек-лист: оптимизация сайта для ИИ-краулеров
Профиль специалиста по GEO требует глубокого понимания архитектуры трансформеров, навыков промпт-инженерии и работы с микроразметкой. Создание текстового документа в корне — лишь первый этап. Для комплексной подготовки ресурса к ИИ-краулерам необходимо выполнить ряд технических действий.
Базовый чек-лист оптимизации включает следующие шаги:
- настройка расширенной версии: создайте
/llms-full.txtдля полной выгрузки контента, если у вас объемная документация или SaaS-продукт; - оптимизация на уровне фрагментов (Passage-Level Optimization): разбивайте текст на самодостаточные блоки, где каждый H2 или H3 отвечает на конкретный микро-вопрос пользователя;
- семантическое расширение (Query Fan-Out): отвечайте на кластер связанных тем и синонимов, а не концентрируйтесь на одном ключевом запросе;
- внедрение микроразметки Schema.org: явно определяйте сущности через типы Article, Product, LocalBusiness. Для товаров обязательно заполняйте поля model, brand, aggregateRating;
- создание страниц сущностей (Entity pages): формируйте подробные профили для авторов и брендов, связывая их перелинковкой для демонстрации контекстуальных отношений;
- очистка контента от воды: переходите к строгому информационному стилю, убирайте пространные рассуждения, добавляйте проверяемые факты, точные цифры и ссылки на исследования;
- контроль качества через инструменты: используйте AI Search Grader и GPT-Fox для аналитики метрик упоминания бренда в нейросетях.
Отдельное внимание уделите созданию раздела FAQ на сайте. Блоки вопросов и ответов идеально подходят для извлечения краулерами, так как они изначально структурированы под интент пользователя.

Комплексная работа с генеративными системами требует времени и экспертизы. Если вам необходимо профессиональное SEO-продвижение в нейросетях, специалисты агентства Kokoc.com готовы провести аудит и внедрить технологии GEO для вашего бизнеса.
FAQ: Частые вопросы о стандарте llms.txt
Нужно ли добавлять путь к файлу в robots.txt?
Нет, в этом нет технической необходимости. ИИ-боты запрограммированы искать этот документ напрямую в корневой директории. Однако крайне важно проверить, чтобы ваш robots.txt не блокировал User-Agents нейросетей (например, директивой Disallow: / для GPTBot), иначе они не смогут просканировать ресурс.
Какой максимальный размер документа допускается?
Строгих ограничений в спецификации нет, но для базовой версии рекомендуется придерживаться объема до 100 КБ. Это обеспечивает мгновенную загрузку и экономит токены. Для передачи больших массивов данных используйте формат llms-full.txt.
Как правильно настроить микроразметку для блока вопросов?
Для валидации FAQPage в Google Rich Results Test необходимо использовать свойства @context и @type. Массив mainEntity должен содержать объекты Question и Answer. Критическое требование: текст ответа (acceptedAnswer.text) не должен превышать 580 символов, иначе он будет обрезан или проигнорирован алгоритмами.
Заменит ли внедрение стандарта классическое SEO?
Нет, это параллельный процесс. Классическая оптимизация работает с алгоритмами ранжирования поисковых систем, а GEO — с механизмами извлечения ответов языковыми моделями. Максимальный результат дает синергия обоих подходов.
Коротко о главном
- Адаптация веб-ресурсов под требования генеративного поиска — обязательное условие для сохранения трафика в ближайшие годы. Использование специализированных текстовых форматов помогает нейросетям корректно считывать информацию о бизнесе.
- Стандарт представляет собой Markdown-документ, размещаемый в корне сайта, который служит навигационной картой для LLM-краулеров.
- Он не заменяет robots.txt или sitemap.xml, а работает на семантическом уровне, предоставляя чистый контекст без HTML-кода.
- Внедрение технологии снижает нагрузку на контекстное окно нейросетей и минимизирует риск фактических ошибок (галлюцинаций) при упоминании бренда.
- Обязательная структура включает H1-заголовок, системный промпт через блок цитаты и логически сгруппированные ссылки с краткими описаниями.
- Для достижения максимального эффекта в AI-выдаче необходимо комбинировать технические файлы с Passage-Level Optimization, разметкой Schema.org и созданием Entity pages.
.png)
.png)



Комментарии
Комментариев пока нет. Будьте первым!
Оставить комментарий