


TF-IDF — это способ оценить вес слова в документе: частота слова в тексте (TF) умножается на обратную частоту документа (IDF), то есть на показатель редкости слова в коллекции текстов. Метод создавали для ранжирования результатов поиска, и он отвечает на один вопрос: какие слова выделяют этот текст среди остальных. О том, что слово значит в запросе и на странице, он ничего не знает.
Поэтому одной частоты слов для оценки релевантности не хватает: страница может повторять все слова запроса и не отвечать на него. Современные поисковые системы оценивают слова вместе с окружением, переводят тексты в векторы и учитывают сущности, то есть объекты реального мира, и связи между ними. Лексические методы вроде BM25 (развитие TF-IDF, о нём ниже) при этом не исчезли и в исследованиях поиска остаются сильной базой для сравнения.


- Как работает классический метод TF-IDF
- Почему частота слов не гарантирует релевантность
- Векторные представления слов (embeddings) простыми словами
- Как BERT и нейросетевые модели понимают контекст
- Где TF-IDF и BM25 по-прежнему полезны
- От плотности ключей к плотности сущностей
- Как писать текст под смысл, а не под частоту слов
- FAQ по TF-IDF и нейросетевому поиску
- Коротко о главном
Как работает классический метод TF-IDF
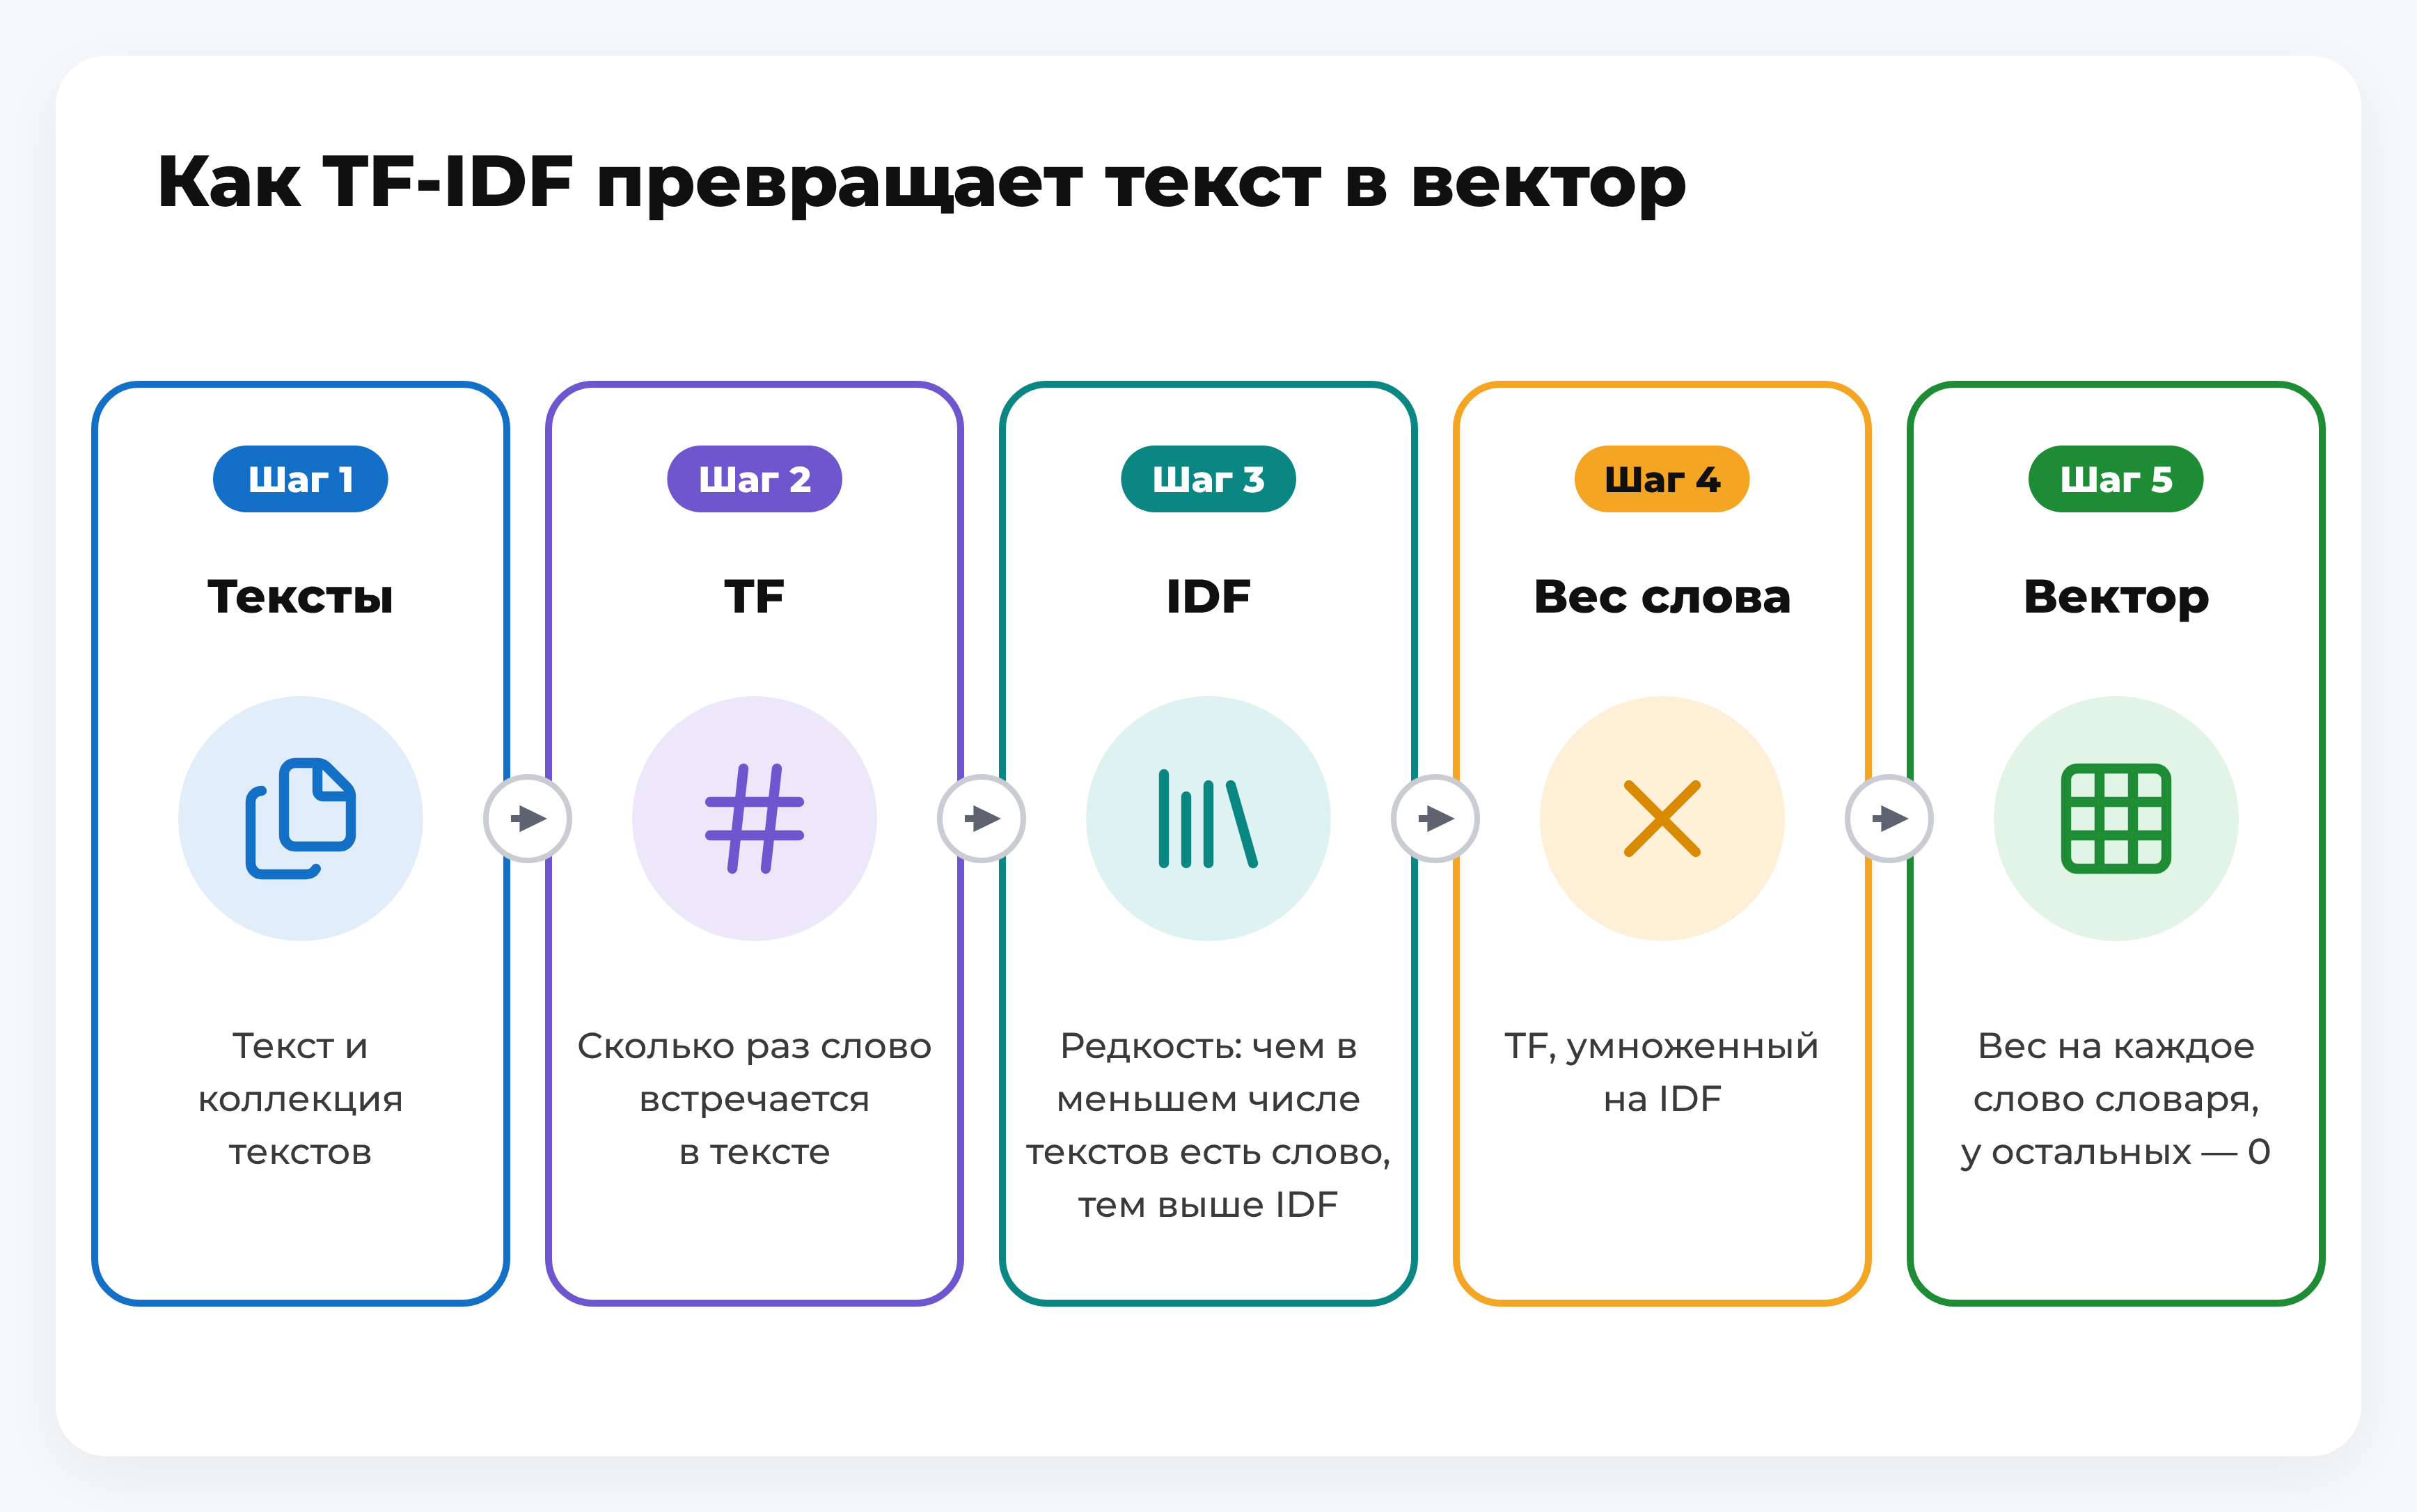
Вес слова в TF-IDF складывается из двух величин. TF показывает, сколько раз слово встречается в тексте, а IDF оценивает его редкость в коллекции: у редкого слова обратная частота документа высока, у слова, которое есть почти везде, низка. Итоговый вес получается умножением TF на IDF. Формулы в разных реализациях отличаются, а идея у всех одна.
Бытовая логика простая: слово «и» есть в каждом тексте и ничем его не выделяет, а узкий термин сразу показывает, о чём страница. Вес максимален, когда слово часто встречается в небольшом числе документов. Он ниже, если вхождений мало или слово есть во многих текстах, и минимален, когда слово есть практически во всех документах.
Так документ превращается в вектор, то есть набор чисел, где у каждого слова словаря свой вес, а у слов, которых в тексте нет, вес нулевой. Размер вектора равен размеру словаря. В основе лежит модель «мешок слов» (bag of words): текст описывается вхождениями слов, а порядок слов не учитывается совсем. Перед подсчётом слова обычно приводят к начальной форме (лемматизация), чтобы «насос» и «насосы» считались одним словом.
Условный пример: три слова из текста о тепловых насосах в коллекции из 10 текстов.
| Слово или термин | Вхождений в тексте | Текстов со словом из 10 | Вес слова |
|---|---|---|---|
| и | 14 | 10 | минимальный |
| тепловой насос | 7 | 2 | высокий |
| монтаж | 2 | 6 | ниже, чем у термина темы |
Общее слово проигрывает, несмотря на 14 повторов: оно есть в каждом тексте, и редкости у него нет. Термин темы встречается реже, но только в двух текстах из десяти, поэтому получает самый высокий вес. Слово «монтаж» проигрывает термину, потому что в тексте его мало, а в коллекции оно встречается чаще.
TF-IDF изначально разработан как схема взвешивания слов для ранжирования результатов поиска. Функция BM25 развивает ту же идею: в реализации поисковой платформы Elasticsearch, как её описывает Elastic, она тоже учитывает частоту и редкость слова, но ограничивает вклад повторов и сравнивает длину документа со средней.


Почему частота слов не гарантирует релевантность
Релевантность — это соответствие страницы смыслу запроса, а частота показывает лишь, как часто слово встречается. Поэтому страница может содержать все слова запроса и не отвечать на него, а может ответить другими словами, и подсчёт этого не заметит. Подобрать ключевые слова нужно, чтобы понять язык аудитории, однако их присутствие в тексте ещё не доказывает, что ответ получен.
Что не видит подсчёт слов
Подсчёт не различает синонимы: «авто» и «машина» для него разные признаки. Омонимы, наоборот, сливаются в одно слово, как «ключ» от двери и «ключ» запроса. Порядок слов тоже не учитывается, поэтому фразы «билет из Москвы в Казань» и «билет из Казани в Москву» дают одинаковый набор слов. Отрицание «без» и предлоги меняют смысл, но для подсчёта остаются обычными единицами.
Сам Google в октябре 2019 года показывал это на примерах из собственного поиска. В запросе о том, приходится ли косметологам много стоять на работе (do estheticians stand a lot at work), прежние системы сопоставляли слово «stand» со словом «stand-alone» в результатах, хотя значение другое. В запросе о парковке на склоне без бордюра слишком большой вес получало слово «curb», а «no» игнорировалось. Google говорил о сопоставлении ключевых слов в целом, и TF-IDF в этом посте не упоминается.

Чем грозит оптимизация под частоту
Google относит к спаму (keyword stuffing) наполнение страницы ключевыми словами или цифрами ради манипуляции ранжированием, в том числе повторение слов и фраз так часто, что текст звучит неестественно. Это спам-политика Google для веб-поиска, и переносить её на «Яндекс» без отдельной проверки нельзя. Для автора вывод практичный: повтор ради счётчика читается неестественно и рискует попасть под эту политику.
Проверяйте, что узнал читатель из абзаца: факт, критерий или действие.
Когда слово запроса уже есть в абзаце, ещё один повтор ничего не добавит. Лучше уточнить формулировку или привести пример.
Векторные представления слов (embeddings) простыми словами
Эмбеддинг (embedding) — это векторное представление данных, то есть набор чисел, который описывает слово или текст так, что близкие по смыслу объекты оказываются рядом в пространстве эмбеддингов. Расстояние между точками отражает относительную близость объектов. Такие представления получают методами машинного обучения в области обработки естественного языка (NLP) на больших массивах текстов.
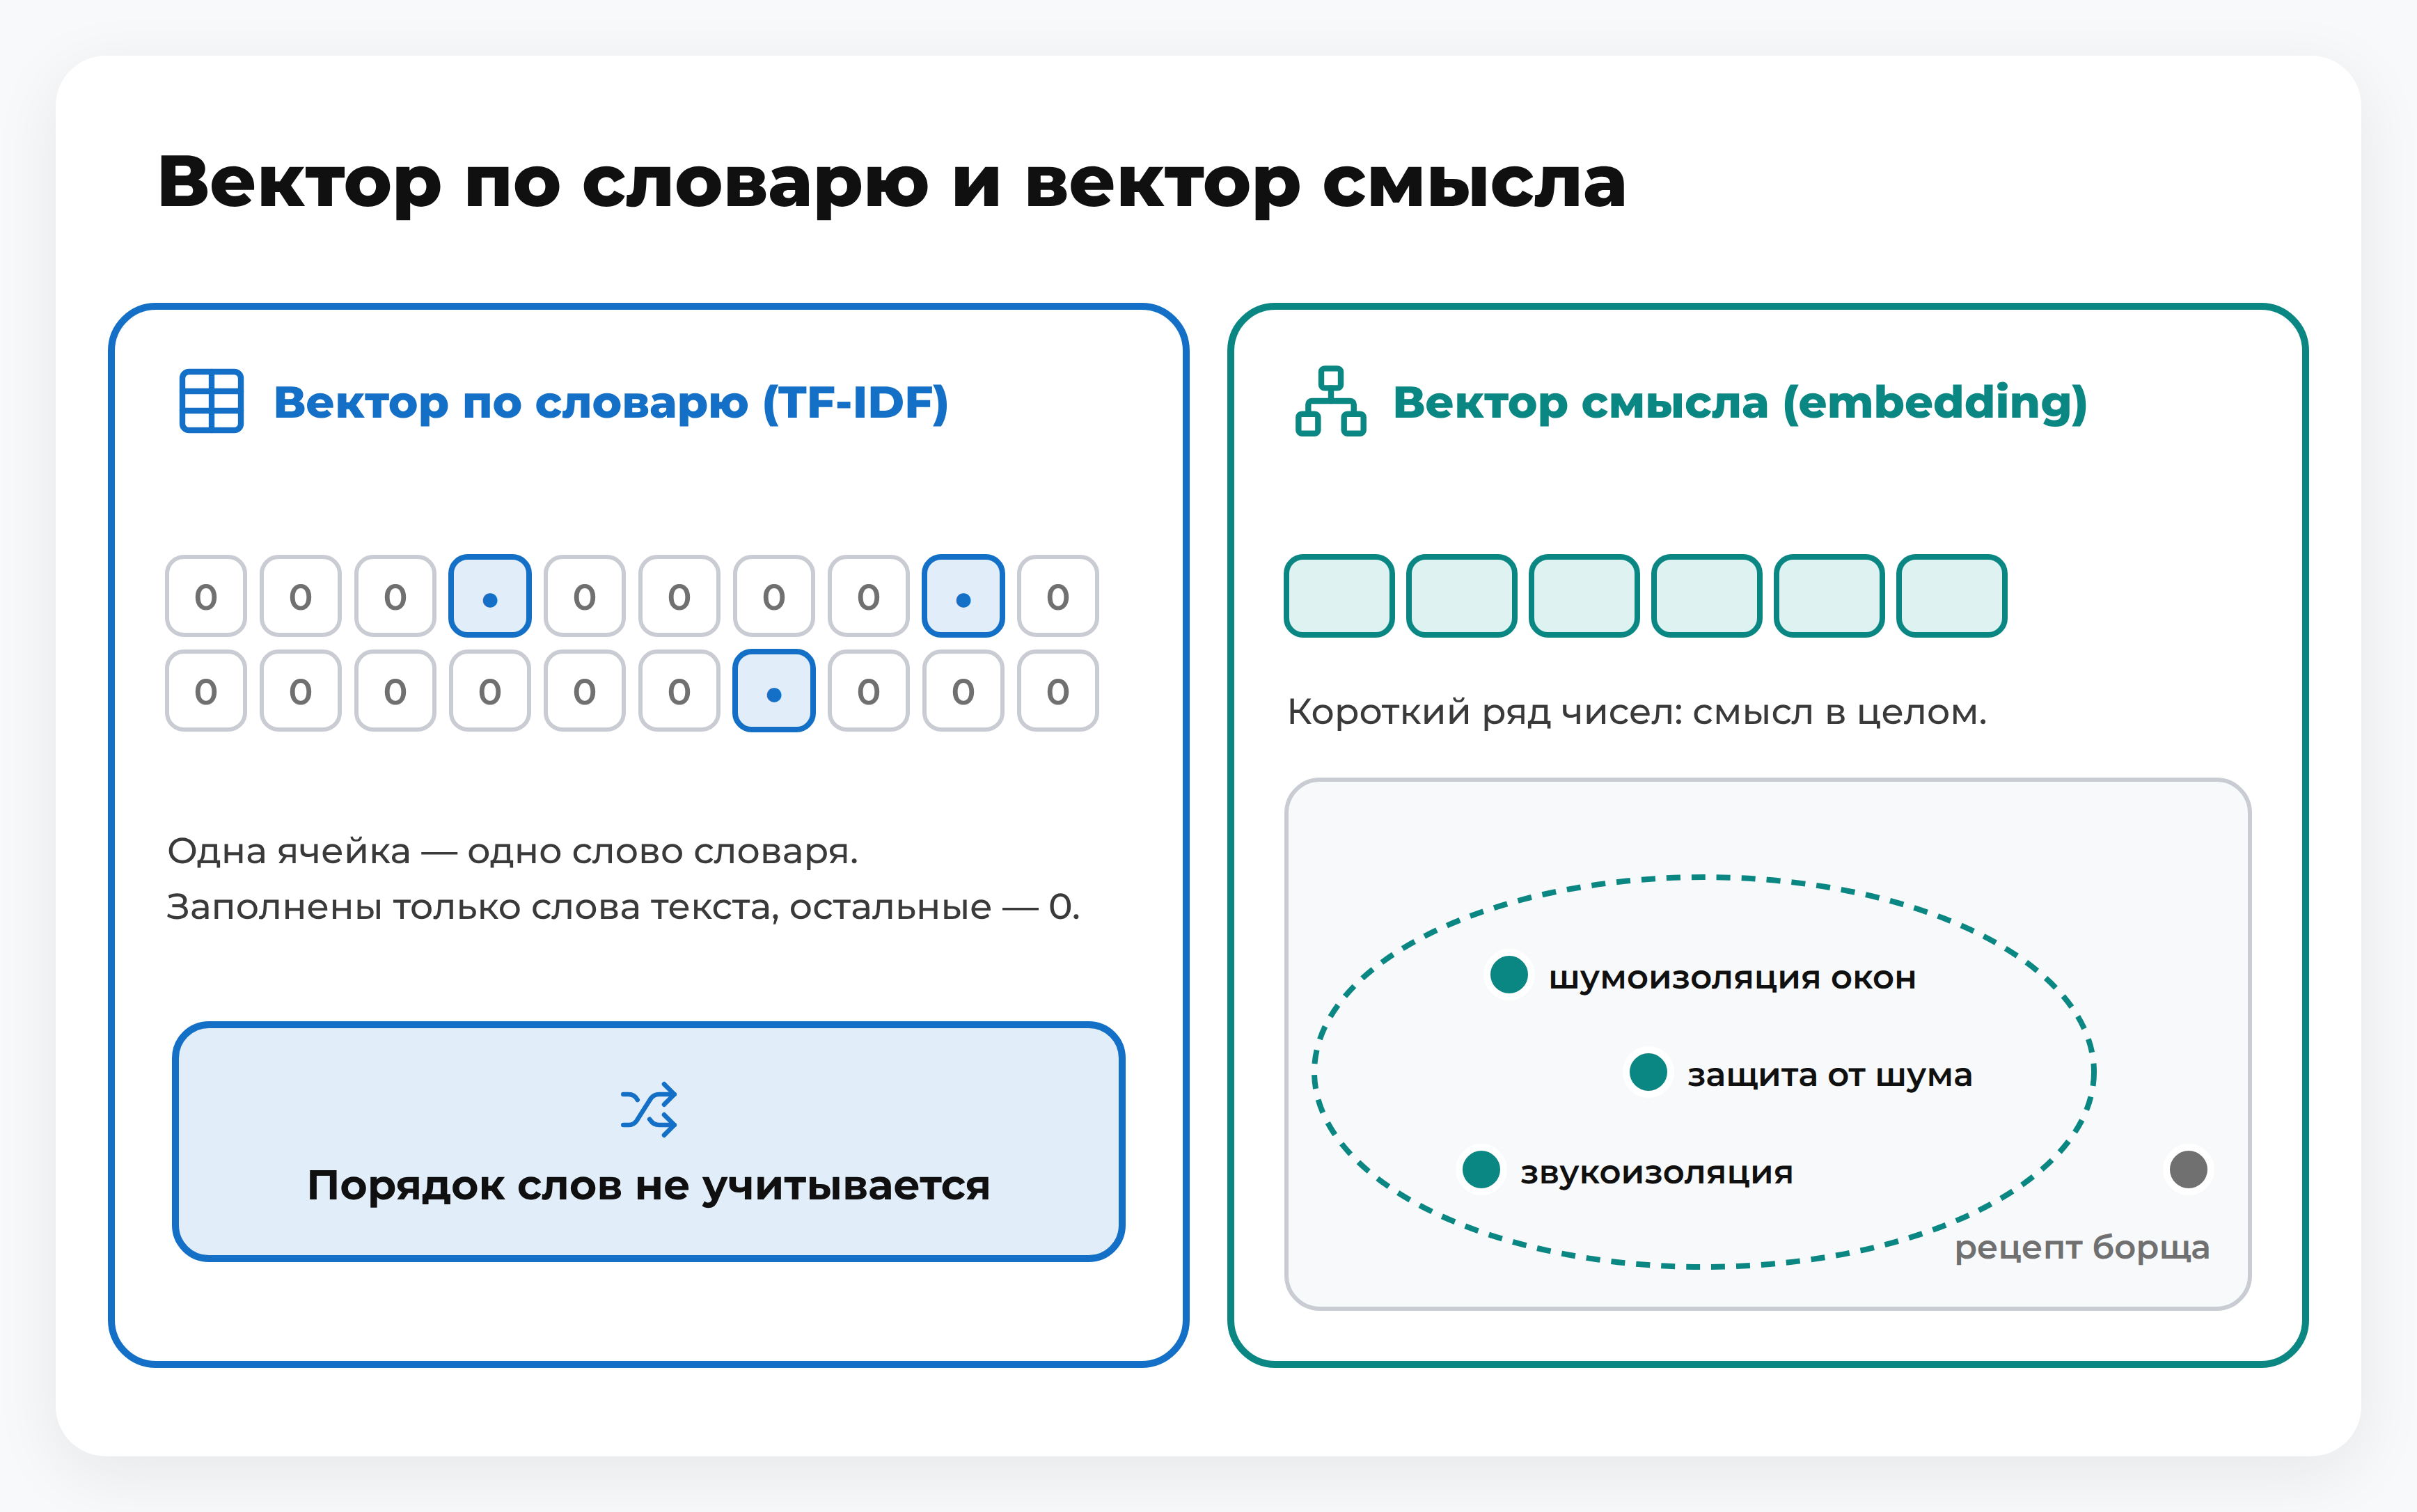
В TF-IDF каждое слово словаря образует отдельную ось, а у документа нули стоят на месте всех слов, которых в нём нет. В эмбеддинге смысл записан в компактном наборе чисел, который модель выучила на текстах, поэтому синонимы без общих букв оказываются рядом.
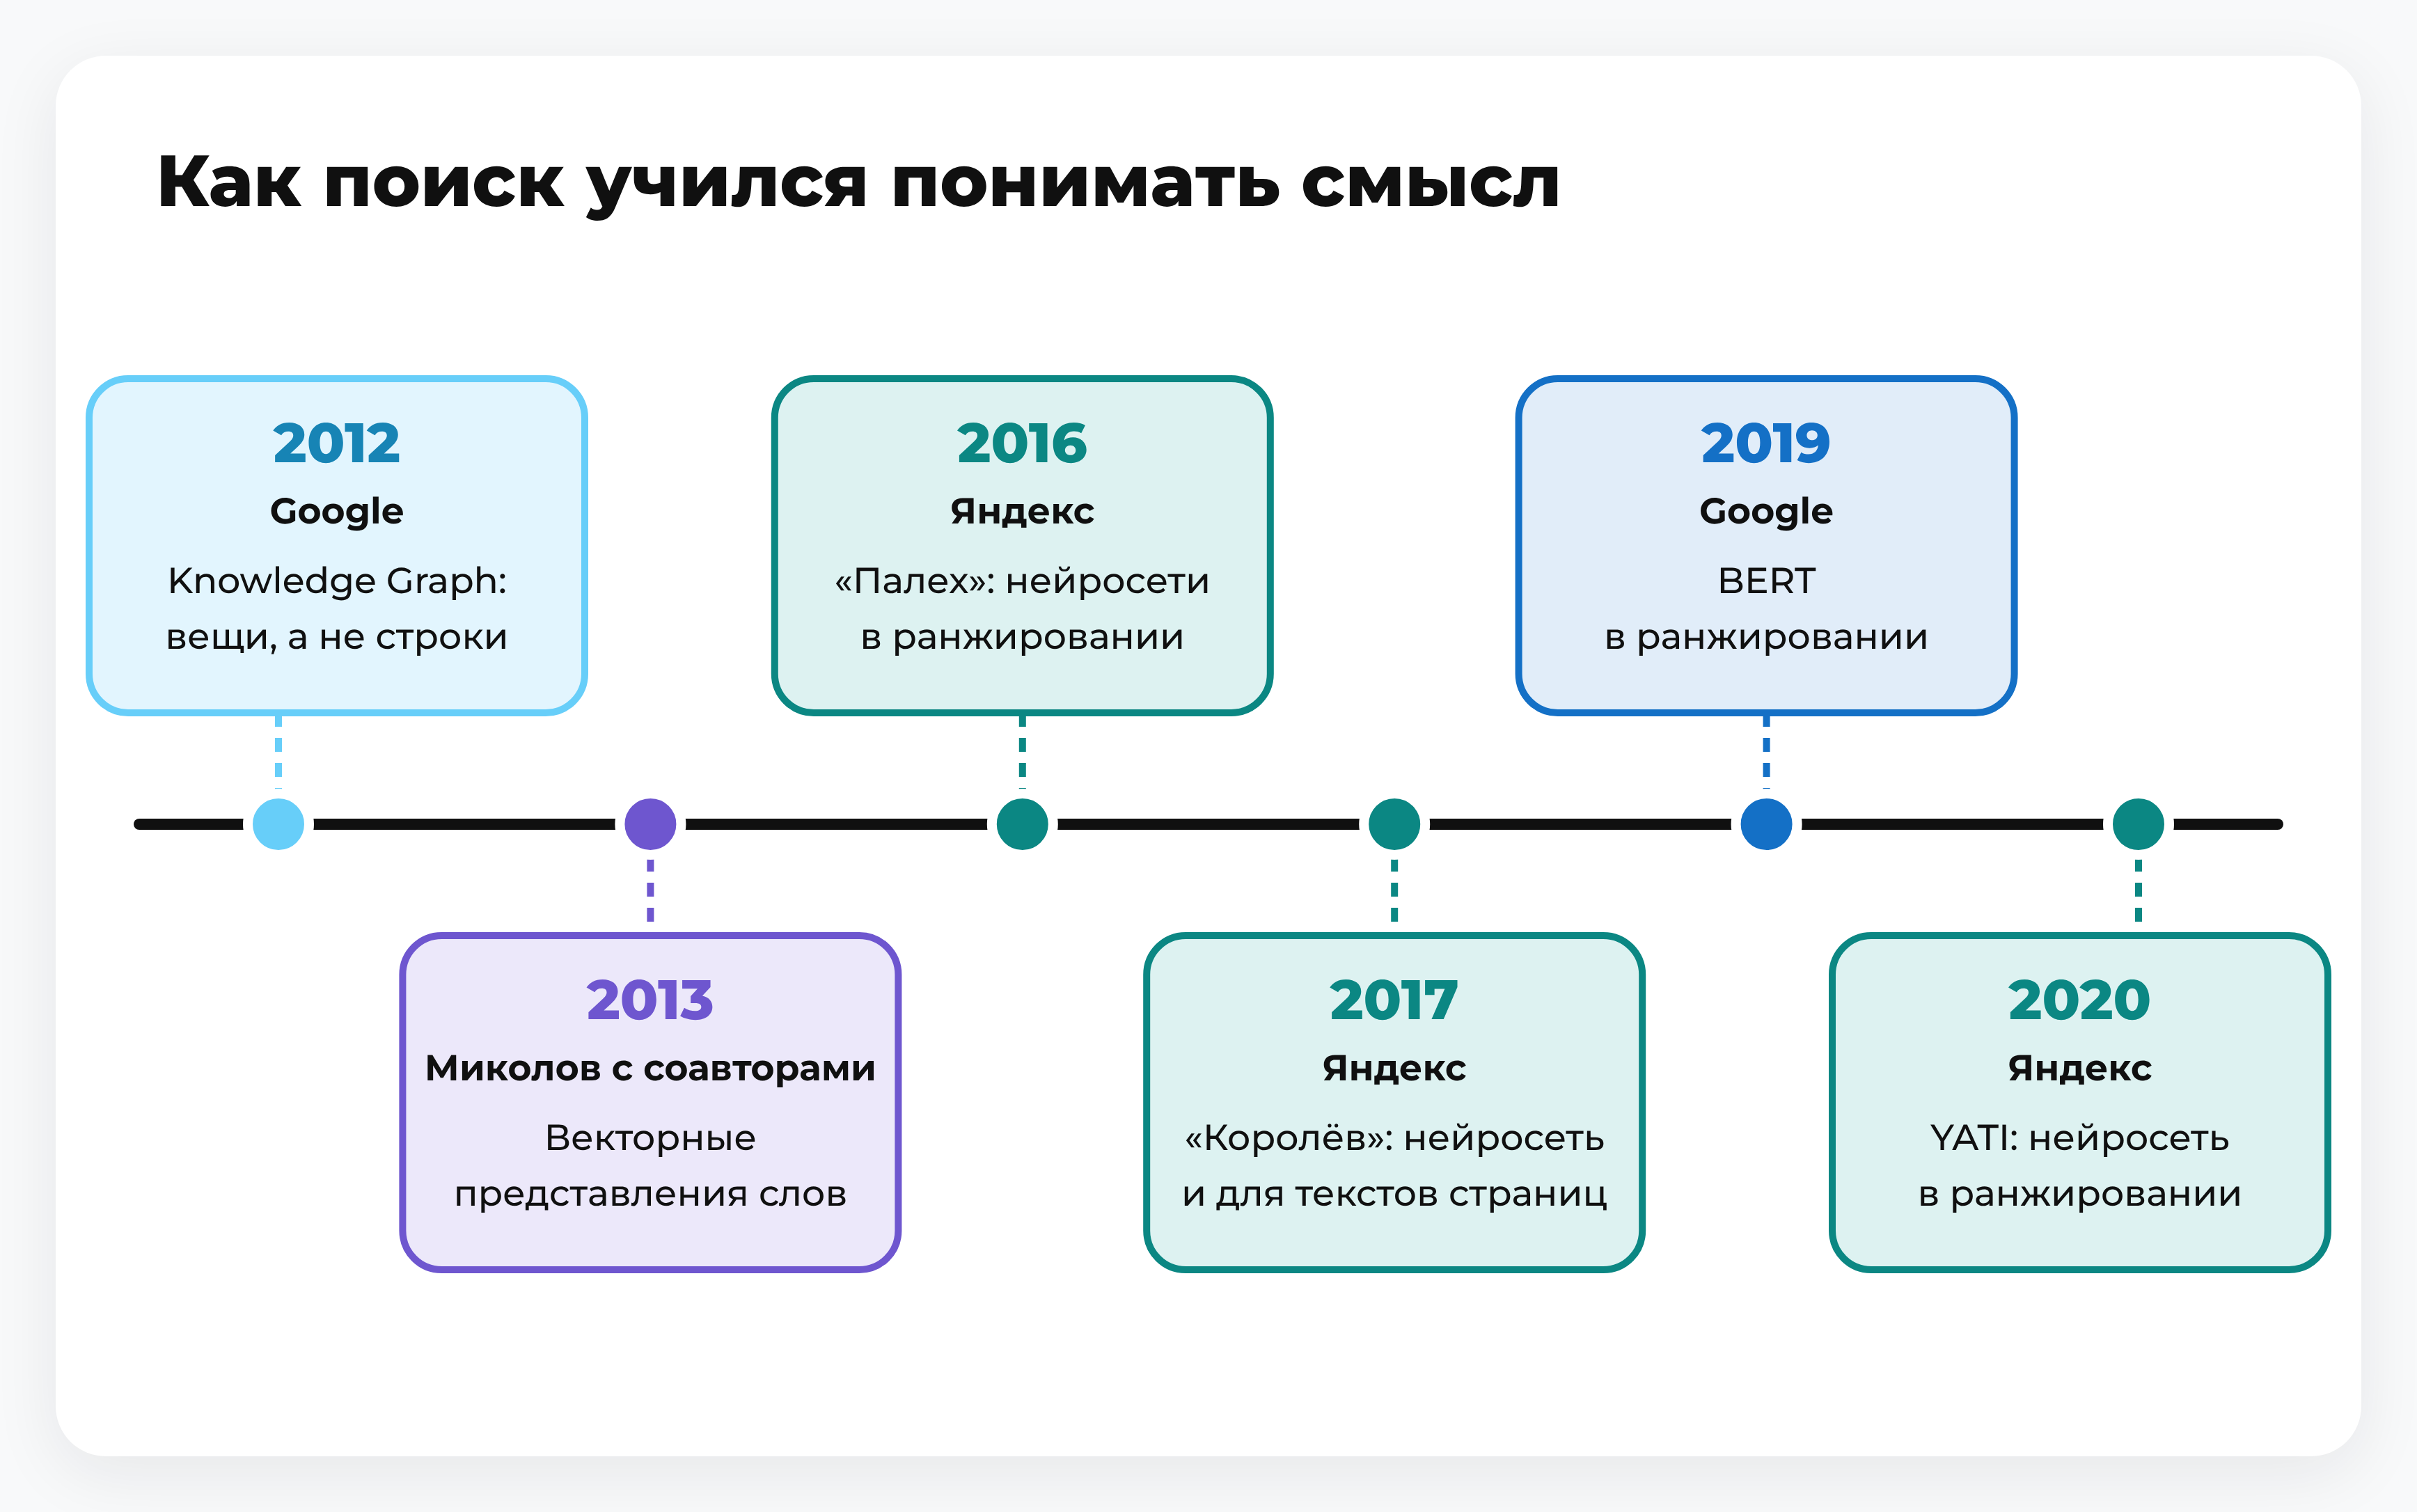
В 2013 году Миколов с соавторами предложили две архитектуры для получения непрерывных векторов слов из очень больших корпусов. Авторы показали, что на корпусе в 1,6 млрд слов качественные векторы обучаются меньше чем за сутки, а на их тестовом наборе синтаксического и семантического сходства слов эти векторы дали лучшие результаты.
Близость измеряют углом между векторами (косинусным расстоянием) или их скалярным произведением. Так «Яндекс» описывал первые нейросети в своём поиске. Поисковый запрос и документ превращаются в векторы, и страница без слов запроса может оказаться подходящей: сравниваются смыслы, и совпадение букв не требуется. Условный пример: читатель ищет «как защитить квартиру от уличного шума», а на странице написано «шумоизоляция окон» и нет ни одного слова запроса. Для подсчёта слов совпадений нет, для векторов эти формулировки близки.
У ранних решений был предел. Первые нейросети «Яндекса», алгоритмы «Палех» и «Королёв», суммировали векторы слов в один вектор текста, и порядок слов терялся или учитывался лишь частично, поэтому сам «Яндекс» называл такую сеть грубым приближением семантики, которое в основном работает для коротких текстов. Суммирование слов теряет то, что даёт окружение. Для автора отсюда следует, что поиск сопоставляет формулировки читателя и страницы, и перебор вариантов ключа этого не заменяет.
Как BERT и нейросетевые модели понимают контекст
Контекстные нейросетевые модели, которые строятся на машинном обучении, оценивают слово вместе с остальными словами фразы, поэтому значение зависит от окружения. Статические эмбеддинги вроде word2vec, напротив, описывают все значения слова одной точкой, и в ряде случаев это становится ограничением.
BERT (Bidirectional Encoder Representations from Transformers) — это нейросетевая модель Google для понимания языка; документация Google описывает её как ИИ-систему, которая помогает понять, как сочетания слов выражают разные значения и намерение. В основе лежит архитектура Transformer: трансформеры обрабатывают слова в связи со всеми остальными словами предложения, а не по одному по порядку. Поэтому BERT учитывает слова и слева, и справа от нужного.
Что изменил BERT
Пример Google 2019 года: в запросе «2019 brazil traveler to usa need a visa» важна связь слова «to» с остальными, ведь речь о путешественнике из Бразилии в США. Прежние алгоритмы возвращали результаты про граждан США, которые едут в Бразилию. С BERT, как писал Google, поиск лучше улавливает такой нюанс.
В октябре 2019 года Google объявил о применении BERT в ранжировании и в избранных сниппетах. По словам компании, в ранжировании он поможет лучше понимать один из десяти запросов в США на английском языке, а другие языки и регионы подключат со временем. В декабре 2019 года Google сообщил, что BERT раскатывается более чем на 70 языков, а доля затронутых запросов зависит от языка, но в целом близка к той же оценке «один из десяти».
В «Яндексе» похожий шаг компания описала на конференции YaC 2020: она рассказала о внедрении в ранжирование трансформера YATI и назвала это наиболее значимым событием в своём поиске за десять лет. По словам «Яндекса», «Палех» и «Королёв» вместе повлияли на поиск меньше, чем новая модель, а если оставить в ранжировании только её, качество по основной офлайн-метрике упадёт лишь на 4–5 %.

Сегодня документация Google Search Central называет BERT, RankBrain и neural matching системами ранжирования среди других. RankBrain помогает понять, как слова связаны с понятиями, и вернуть релевантное, даже если на странице нет всех слов запроса.
Хронология от слов к смыслу
В 2016 году «Яндекс» впервые применил нейросети для ранжирования сайтов в «Палехе», сравнивая заголовки страниц и запросы, а в 2017 году «Королёв» распространил нейросеть и на тексты страниц. Хронология ниже показывает путь поиска от слов к смыслу.

Где TF-IDF и BM25 по-прежнему полезны
TF-IDF перестал быть достаточным, но совпадение слов не исчезло: Google в справке о работе поиска называет самым базовым сигналом релевантности то, что в тексте есть те же ключевые слова, что в запросе. BM25 при этом не то же самое, что TF-IDF: он развивает идею взвешивания слов и, как пишет Elastic, использует другую формулу IDF.
Как новые методы выглядят рядом с лексическими, показал бенчмарк BEIR 2021 года: 18 открытых наборов данных, 10 систем поиска и режим zero-shot, то есть без обучения под конкретный набор. BM25 оказался надёжной базовой линией, а ре-ранжирование, то есть пересортировка найденных документов более точной моделью, и модели с поздним взаимодействием в среднем дали лучшие результаты, но при высокой вычислительной стоимости. Лучшая из них, связка BM25 с нейросетью, которая пересортировывает отобранных BM25 кандидатов, обошла BM25 на 16 наборах данных из 18. Плотные модели, которые сравнивают эмбеддинги запроса и документа, на многих наборах заметно уступали BM25.
Бенчмарк не измерял Google и «Яндекс» и не использовал русскоязычную выборку, поэтому об их внутреннем устройстве он не говорит. Автору лексический подход полезен как диагностика: список слов из анализатора показывает, каких терминов в тексте не хватает. Это подсказка для редактуры, а цель текста задаёт вопрос читателя.
От плотности ключей к плотности сущностей
Сущность — это объект реального мира, например человек, место или предмет, который поисковая система различает независимо от написания. Так Google описал свой граф знаний (Knowledge Graph) 16 мая 2012 года: «things, not strings», то есть вещи, а не строки.
В запуске Google объяснил переход от сопоставления слов к модели, которая понимает реальные объекты и связи между ними. Запрос [taj mahal] может означать памятник, музыканта или казино, и слова сами по себе это не различают. На момент запуска граф содержал более 500 млн объектов и более 3,5 млрд фактов и связей.
Что такое плотность сущностей
Плотность сущностей — не стандарт и не метрика поисковых систем. В исследовании автоматического реферирования Chain of Density (Адамс и соавторы, 2023) так называют число сущностей на токен текста. В этой статье понятие шире: это проверка полноты раскрытия темы через связанные понятия, организации, продукты и термины, которые упоминаются вместе с темой и объясняются.
Чем плотность сущностей отличается от привычной плотности ключей, видно по пяти признакам.
| Признак | Плотность ключей | Плотность сущностей |
|---|---|---|
| Что считаем | Повторы слова или фразы | Понятия, объекты и связи между ними, раскрытые в тексте |
| Что видит автор | Число вхождений ключа | Какие подтемы и вопросы читателя закрыты |
| Чем рискуем | Переспамом и неестественным текстом | Упустить связанное понятие |
| Как проверить | Счётчик в анализаторе | Перечень понятий и вопросов читателя, сверенный с текстом |
| Пример до и после | До: фраза «тепловой насос для дома» повторяется в каждом абзаце | После: текст объясняет, как работает насос, как выбирают модель и что входит в монтаж и обслуживание |
Плотность ключей отвечает на вопрос, сколько раз повторено слово, а плотность сущностей показывает, раскрыта ли тема. Для проверки составьте перечень понятий и вопросов читателя по теме и сверьте его с текстом: каждое понятие должно появиться и получить объяснение. Как записывать связи между понятиями, рассказывает статья про семантические триплеты.
Вместо очередного повтора ключа добавьте недостающее понятие и объясните, как оно связано с темой.
Как писать текст под смысл, а не под частоту слов
Работа над текстом начинается с вопроса читателя. Порядок такой.
- Сформулируйте главный вопрос читателя и интент страницы.
- Выпишите подтемы и понятия, без которых ответ неполон.
- Вводите ключевую фразу один раз там, где она нужна по смыслу.
- Проверьте каждый раздел вопросом из его заголовка: отвечает ли на него первый абзац.
Автору ставьте задачу через тему, вопросы и понятия. Типичная ошибка — сделать список из анализатора обязательным пунктом ТЗ: автор начинает вставлять слова, и текст теряет прямой ответ. Анализатор уместнее как проверка полноты уже написанного текста.
Черновик полезно прочитать вслух: повторы одной формулировки слышны сразу. О том, как расположение текста на странице влияет на ранжирование по ключевым словам, рассказывает разбор SEO-эксперимента британского агентства Pedalo. Если сайт нужно подготовить к нейросетевому поиску, этим занимается услуга SEO в нейросетях.
FAQ по TF-IDF и нейросетевому поиску
Используется ли MUM для общего ранжирования в Google?
Нет, в общем ранжировании MUM не участвует. Документация Google Search Central на ноябрь 2026 года сообщает, что система в настоящее время используется не для общего ранжирования, а для отдельных задач. Поэтому подавать её как общий фактор ранжирования не стоит.
Оценивает ли Google страницу целиком или по фрагментам?
У Google есть система ранжирования по пассажам. Она определяет отдельные разделы страницы, чтобы лучше понять, насколько страница релевантна запросу. Это одна из систем ранжирования Google.
Какая плотность ключевого слова допустима в Google?
Ориентира нет. Джон Мюллер из Google в ответе на вопрос о плотности ключевых слов в январе 2023 года сказал, что у Google нет понятия оптимальной плотности: системы научились понимать, о чём страница, даже если ключевые слова на ней не упомянуты. При этом он посоветовал выражаться явно и использовать терминологию, которую ищут пользователи. Ответ касается Google, а про «Яндекс» он ничего не говорит.
Коротко о главном
- Частота слов показывает, какие слова есть в тексте, но не о чём он, поэтому поиск оценивает смысл, контекст и сущности, а совпадение слов остаётся базовым сигналом.
- TF-IDF взвешивает слова по частоте в тексте и редкости в коллекции и не знает их смысла.
- Частота слов не гарантирует релевантность: страница может содержать все слова запроса и не отвечать на него.
- Эмбеддинги превращают слова и тексты в векторы, где близкие по смыслу формулировки лежат рядом.
- BERT и другие контекстные модели оценивают слово вместе с окружением, а BM25 в исследованиях остаётся сильной базой для сравнения.
- Для автора ориентир — полнота раскрытия темы через понятия и связи; число повторов ключа ориентиром не служит.

.png)
.png)



Комментарии (1)
Оставить комментарий