


Бренд нельзя вписать в ChatGPT, Claude или Gemini напрямую: у моделей нет формы, через которую компания добавляет себя в ответы. Повлиять можно на три пути, по которым большая языковая модель (LLM) узнаёт о компании: знания, полученные при обучении, контекст конкретного запроса и поиск или открытие страницы в момент ответа. Лучше всего поддаётся настройке третий путь, а первые два зависят от того, что компания публикует и как её описывают в сети.
В поисковой выдаче пользователь получает список ссылок и сам выбирает страницу, а генеративный ответ собирает текст целиком и может назвать бренд, а может не упомянуть его вовсе. Попасть в обучающую выборку или в конкретный ответ гарантировать нельзя: OpenAI и Anthropic не раскрывают, какие именно сайты вошли в обучающие данные.
Эту работу часто называют GEO (generative engine optimization). Оптимизация для ChatGPT складывается из тех же решений, что и для других диалоговых нейросетей: доступ роботов, описание компании и контент. В статье эти принципы разобраны на примере ChatGPT, Claude и Gemini, а настройки доступа роботов у каждого поставщика свои.


- Что меняется для SEO, когда вместо выдачи ответ нейросети
- Откуда LLM берёт сведения о бренде и где в ответе ваш сайт
- Как попасть в обучающую выборку LLM
- Упоминания бренда в ответах ChatGPT
- Оптимизация под Gemini и Claude
- Подготовка контента и сайта к ИИ-ответам
- Как проверить, что компания попала в ответы ИИ
- Порядок действий для любой диалоговой нейросети
- FAQ по оптимизации под LLM
- Коротко о главном
Что меняется для SEO, когда вместо выдачи ответ нейросети
Выдача показывает список ссылок с позициями, и результат работы видно в позициях и кликах. Генеративный ответ устроен иначе: модель собирает связный текст, в котором бренд может прозвучать или не появиться вовсе, а ссылки на источники бывают не всегда. Поэтому к органическому трафику и позициям по коммерческим запросам добавляется отдельная проверка: называет ли ответ вашу компанию или её конкурентов.
Топ выдачи не гарантирует упоминания. Генеративные функции Google Поиска опираются на основные системы ранжирования и качества, поэтому сильные страницы получают там шанс попасть в ответ. Чат-бот без веб-поиска отвечает из того, что модель усвоила при обучении, и позиции вашей страницы в Google в этом ответе не участвуют.
Для AI Overviews и AI Mode, генеративных функций Google Поиска, Google описывает два механизма. RAG (retrieval-augmented generation, генерация с опорой на поиск) — это техника, при которой система перед ответом находит релевантные документы во внешнем источнике, например в поисковом индексе или базе знаний, и строит ответ по ним. В Google Поиске, по словам Google, она улучшает качество, точность и свежесть ответов, достаёт актуальные страницы с помощью основных систем ранжирования и называется также grounding.
Query fan-out — это набор параллельных связанных запросов, которые модель формирует, чтобы получить больше информации и найти дополнительные результаты поиска.
Поиск ChatGPT, когда обращается к поисковым партнёрам, тоже обычно переписывает вопрос в один или несколько целевых запросов (справка OpenAI), но требования Google к страницам на ChatGPT и Claude напрямую не переносятся. Чтобы страница стала поддерживающей ссылкой в AI Overviews или AI Mode, она должна быть проиндексирована и иметь право на показ в Поиске со сниппетом. Других технических требований Google не называет.
От классического SEO остаётся основа: индексация, качество и полезность контента. По словам Google, специальной оптимизации под AI Overviews и AI Mode не требуется, а базовые практики SEO сохраняют ценность. Новое здесь одно: присутствие в ответах нужно проверять отдельно от позиций. О том, как попасть в генеративные ответы Google и «Яндекса», рассказывали в материале про AI-сниппеты, а о том, как модель дробит вопрос на подзапросы, — в статье про методологию query fan-out.
Откуда LLM берёт сведения о бренде и где в ответе ваш сайт
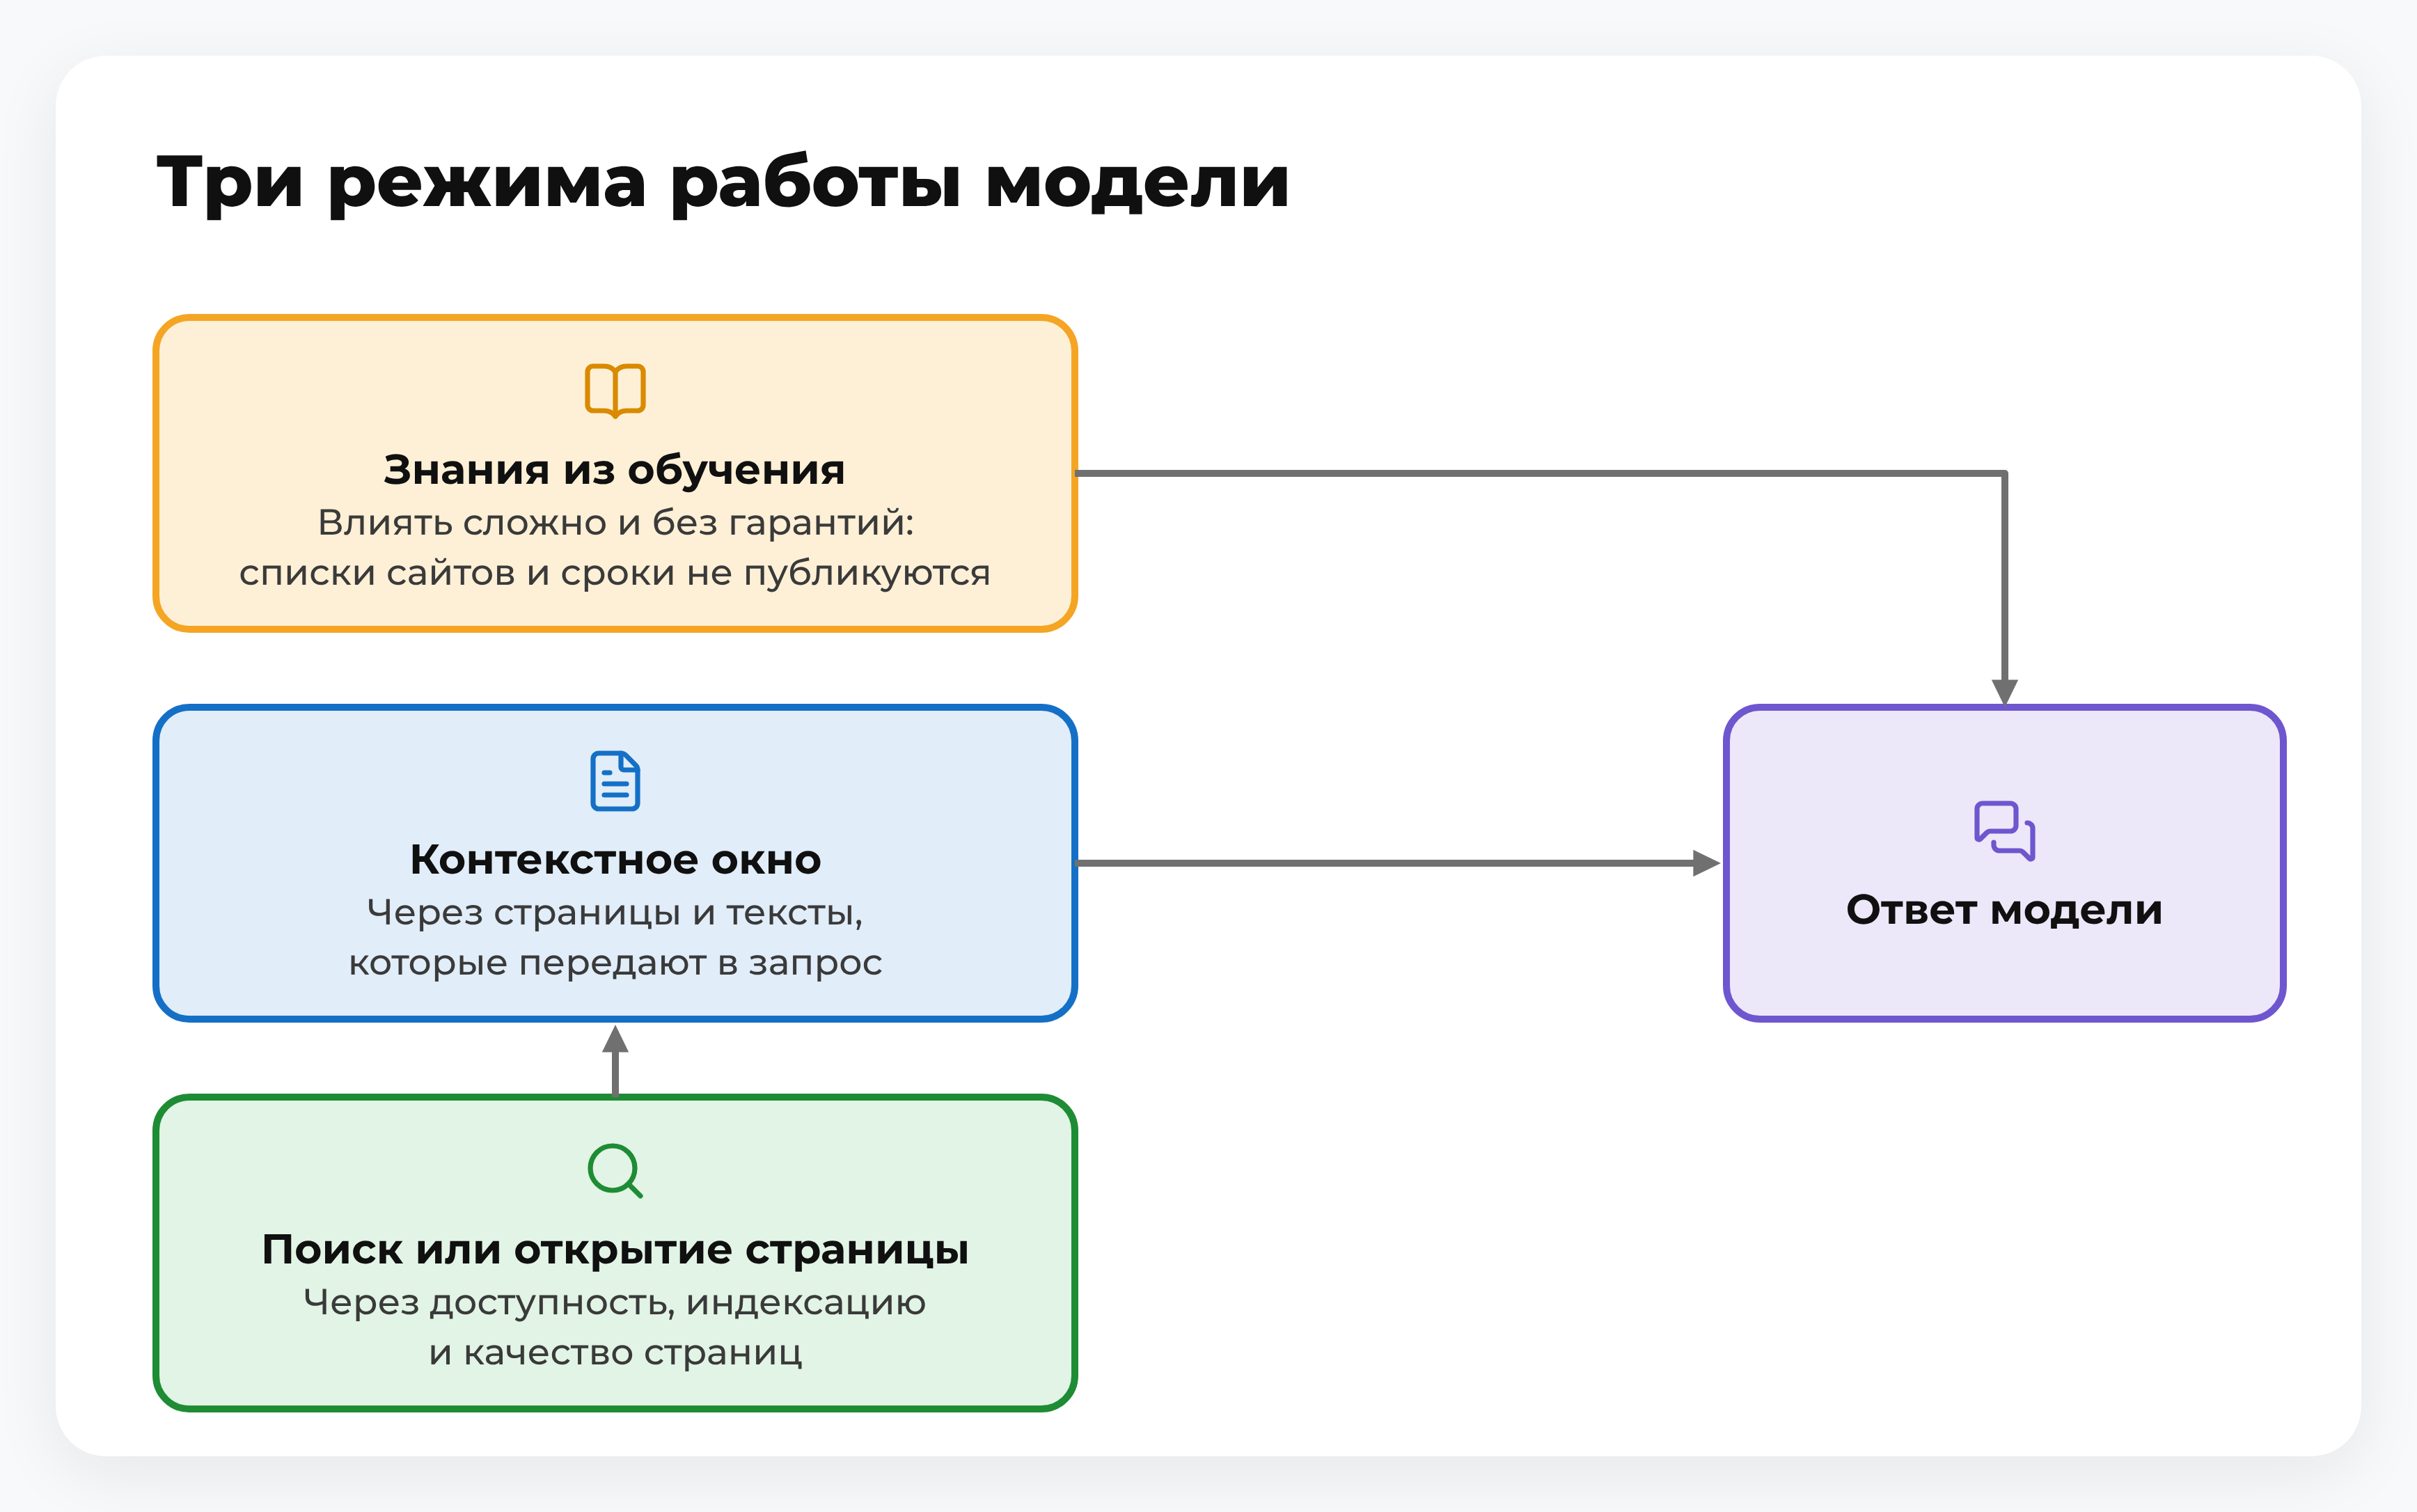
У ответа модели три источника: знания из обучения, контекстное окно и поиск или открытие страницы. Влиять на ответ можно доступностью страниц и упоминаниями компании в сторонних источниках, а вводить данные в модель напрямую нельзя.
Первый режим — знания из обучения. По документации OpenAI, базовые модели, в том числе лежащие в основе ChatGPT, разрабатываются на общедоступной информации из интернета, данных, к которым компания получает доступ через партнёров, и данных, которые дают или создают пользователи, разметчики и исследователи. Контент за платным доступом и из даркнета OpenAI сознательно не собирает. Модель не хранит копии обучающих данных: при обучении меняются значения её параметров, и один и тот же вопрос может дать разные ответы. Эти сведения относятся к моделям OpenAI и не переносятся на Claude и Gemini.
Контекстное окно — это весь текст, который языковая модель может учитывать при генерации ответа, включая сам ответ; оно служит «рабочей памятью» модели.
Второй режим работает через контекстное окно, которое отличается от корпуса обучения. Страница сайта попадает в окно, только если её передали в запрос: через поиск, открытие страницы или вставку текста пользователем. Большое окно не всегда лучше: по данным Anthropic, с ростом числа токенов точность и полнота извлечения информации снижаются, и это явление называют context rot.
Третий режим — поиск или открытие страницы. Модель обращается к индексу или к самой странице в момент запроса и использует найденное в ответе. Для бренда это самый управляемый путь: на него влияют доступ роботов, индексация и качество страниц.
Как попасть в обучающую выборку LLM
В обучающие данные OpenAI из интернета может попасть только то, что свободно и открыто доступно, но и открытая страница туда не обязательно войдёт: OpenAI отфильтровывает часть материалов, например спам. Управляемо только то, что связано с доступом роботов и качеством страниц. У Anthropic и Google на обучение тоже влияет доступ роботов: запрет ClaudeBot исключает будущие материалы сайта из обучающих наборов Claude, а токен Google-Extended — из обучения будущих моделей Gemini.
Какие роботы собирают контент сайта
Роботов делят по трём ролям: одни собирают контент для обучения, другие индексируют его для поиска, третьи открывают страницу по запросу пользователя. Различать роли нужно до правки robots.txt, потому что у разных ролей разные последствия запрета. Роли роботов у OpenAI, Anthropic и Google и последствия запрета для каждой роли показывает таблица.
| Компания | Для обучения | Для поиска | По запросу пользователя |
|---|---|---|---|
| OpenAI | GPTBot: запрет означает, что контент не должен использоваться для обучения | OAI-SearchBot: закрытые сайты не показываются в ответах поиска ChatGPT, но могут остаться навигационной ссылкой | ChatGPT-User: открывает страницу по действию пользователя, правила robots.txt могут не применяться |
| Anthropic | ClaudeBot: ограничение исключает будущие материалы сайта из обучающих наборов | Claude-SearchBot: индексирует контент для поиска | Claude-User: открывает сайты по запросу пользователя |
| Токен Google-Extended: обучение будущих поколений Gemini | Токеном не определяется: на включение сайта в Google Поиск он не влияет | Grounding в приложениях Gemini и в Grounding with Google Search на Vertex AI управляется тем же токеном |
У OpenAI три роли закреплены за тремя роботами, и настраиваются они отдельно. Если сайт разрешил и GPTBot, и OAI-SearchBot, OpenAI может использовать результат одного обхода для обеих целей, чтобы не сканировать страницу дважды. Какие боты нужны сайту, а какие лучше блокировать, подробно разбирали в статье об ИИ-краулерах.
У Google отдельного робота нет: токен Google-Extended в robots.txt управляет тем, можно ли использовать уже сканируемый контент для обучения будущих поколений Gemini и для grounding, то есть подачи модели контента из поискового индекса Google в момент запроса, в приложениях Gemini и в Grounding with Google Search на Vertex AI. На включение сайта в Google Поиск токен не влияет.
Что разрешить, а что закрыть
Владелец сайта выбирает из трёх вариантов: разрешить обучение, ограничить его или оставить только поиск и запросы пользователей. Решение зависит от цели сайта. Если нужен показ в поиске ChatGPT, обучение можно ограничить отдельным правилом, потому что для разных ролей у OpenAI разные роботы. Пример запрета обучения при открытом поиске:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
У Anthropic схема та же: три робота настраиваются отдельно, поэтому запрет ClaudeBot не закрывает Claude-SearchBot и Claude-User и не убирает то, что уже вошло в обученные модели. У Google так разделить нельзя: Google-Extended одним токеном закрывает и обучение Gemini, и опору ответов приложений Gemini на страницы сайта.
Решайте судьбу каждого бота отдельно: правило для GPTBot не должно закрывать OAI-SearchBot, если сайту нужен показ в поиске ChatGPT.
От чего зависит выбор страницы источником
Для обучения OpenAI использует общедоступные страницы, поэтому открытость сайта для роботов остаётся базовым условием. В Google Поиске, включая AI Overviews и AI Mode, страница должна быть проиндексирована и иметь право на показ со сниппетом, а Google ценит контент, который люди считают уникальным и полезным. По данным Ahrefs, упоминания бренда на сторонних сайтах связаны с видимостью в ответах ChatGPT и генеративных функций Google, но это корреляция.
Типичная ошибка — закрыть всех ИИ-ботов одним правилом. Вместе с обучением пропадёт показ в поиске ChatGPT и в ответах Claude по запросам пользователей, если эти роботы попали под запрет.

Упоминания бренда в ответах ChatGPT
По данным Ahrefs, видимость бренда в ответах ChatGPT, AI Mode и AI Overviews связана с тем, сколько и в каких контекстах о компании пишут за пределами её сайта. Чтобы эти упоминания относились к одной компании, название, адрес, описание и сфера деятельности должны совпадать в справочниках, профилях и публикациях.
Если компания названа в справочнике иначе, чем на сайте, исправьте это раньше, чем заказывать новые публикации.
Исследование Ahrefs о видимости в ответах ИИ
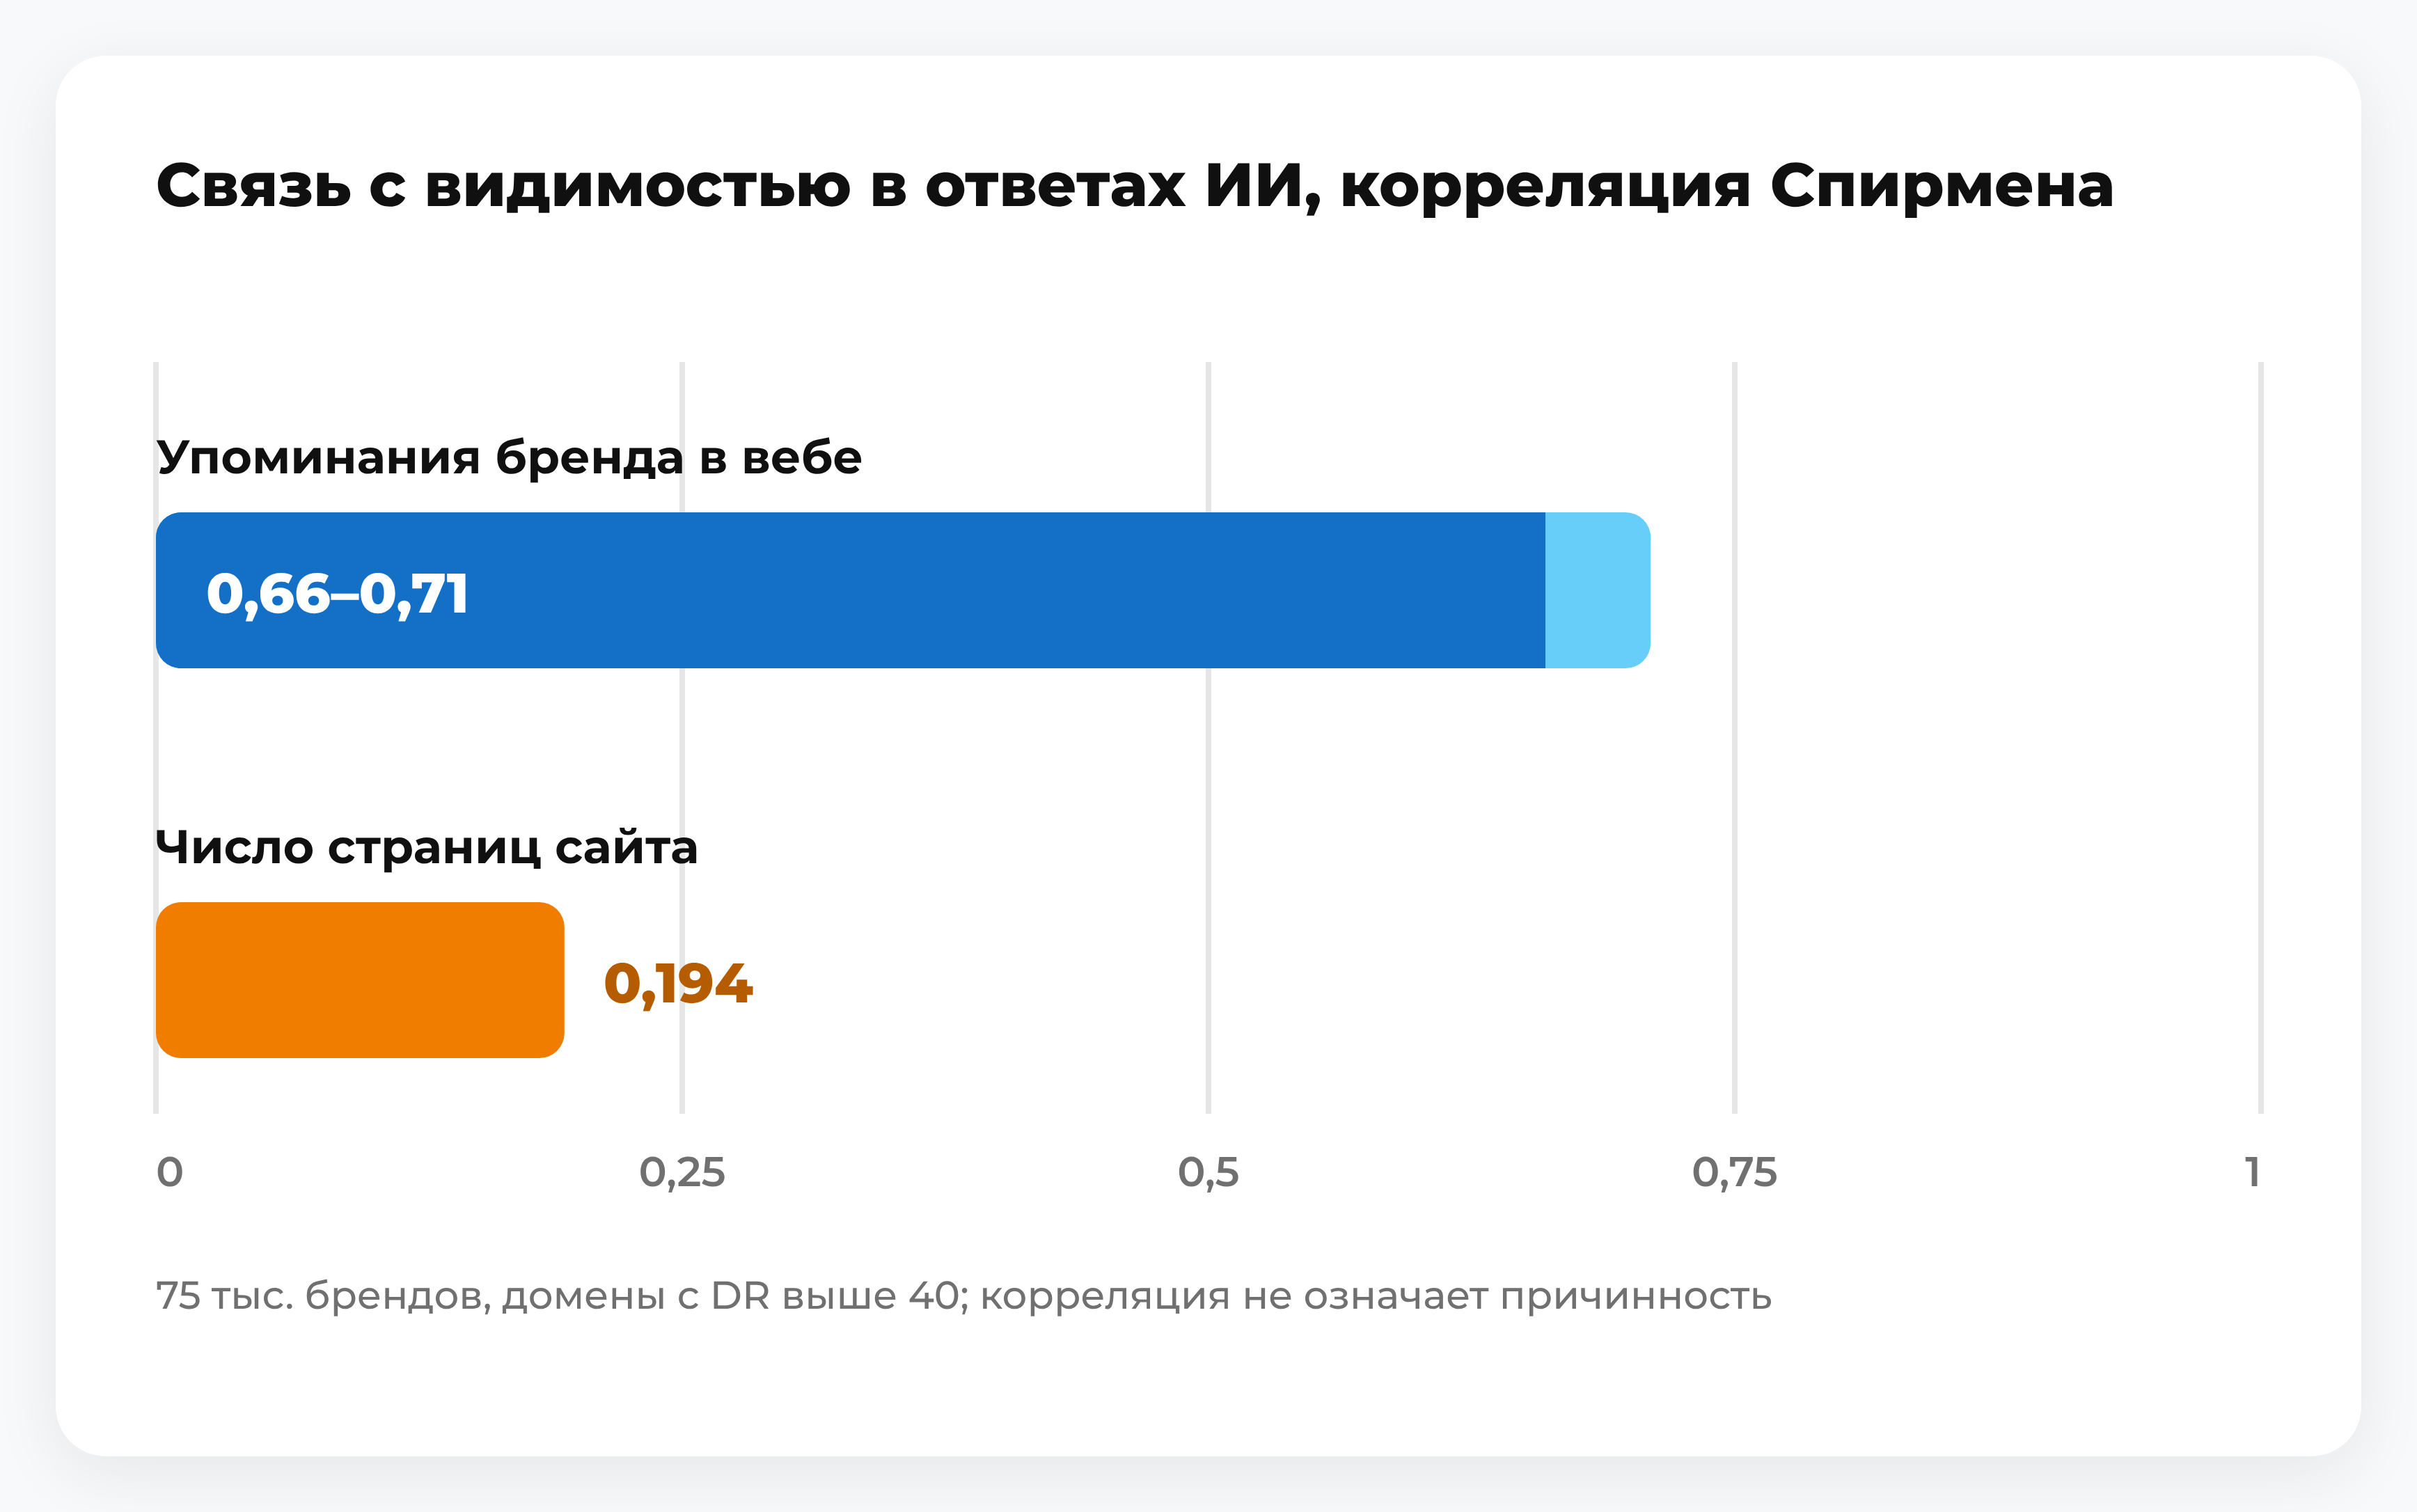
Ahrefs в начале сентября 2026 года проанализировала 75 тыс. брендов с доменами, у которых DR (рейтинг домена по ссылочному профилю) выше 40, по одному самому частотному запросу каждого домена с частотностью от 800 в месяц, и миллионы ответов ИИ в ChatGPT, AI Mode и AI Overviews. По корреляции Спирмена, упоминания бренда в вебе связаны с видимостью в ответах ИИ на уровне 0,66–0,71, а число страниц сайта — лишь около 0,194. Авторы исследования оговаривают, что корреляция не означает причинность.
По связи с видимостью в ответах упоминания бренда в сети заметно впереди объёма собственного сайта. Причину исследование не устанавливает, поэтому цифры годятся как ориентир при выборе приоритетов.
Какие внешние упоминания полезны
Стоит получать публикации в профильных СМИ и отраслевых источниках, отзывы клиентов и экспертные комментарии. Авторы Ahrefs отмечают разнообразие контекстов упоминаний (блоги, якоря ссылок, транскрипты видео, описания, заголовки): бренды с большим числом упоминаний в разных контекстах чаще появляются в ответах ИИ.
Google предупреждает, что погоня за искусственными упоминаниями в сети помогает меньше, чем кажется: основные системы ранжирования ориентируются на качественный контент, а спам блокируют отдельные системы. Это сказано о Google Поиске.
Для работы с упоминаниями, описанием компании и страницами у Kokoc.com есть услуга SEO-продвижения в нейросетях, а само агентство занимает 2 место в рейтинге SEO-компаний и агентств 2026 года по версии «Рейтинга Рунета».
Оптимизация под Gemini и Claude
Для обоих сервисов документированы настройки доступа к контенту: у Anthropic — три робота, у Google — токен Google-Extended, и с них стоит начинать работу.
Настройки для Gemini
Для приложений Gemini доступ к контенту сайта задаёт токен Google-Extended в robots.txt. Если его закрыть, Google не будет использовать контент сайта для обучения будущих моделей Gemini и для grounding в приложениях Gemini, а на показ в Google Поиске запрет не повлияет. Закрывать токен стоит, только если сайту не нужна опора ответов Gemini на его страницы. По описанию Google, при grounding модель в момент ответа получает материалы из индекса Google Поиска, поэтому для приложений Gemini важны те же основы, что и для Поиска: страница должна быть проиндексирована.
В AI Overviews и AI Mode ответ строится на основных системах Поиска, поэтому здесь работают основы SEO: индексация, право на показ со сниппетом и полезный контент.
Настройки для Claude
Если отключить Claude-User, система не сможет получить контент в ответ на запрос, а видимость сайта в поиске по запросам пользователей может снизиться. Отключение Claude-SearchBot тоже может снизить видимость и точность в результатах поиска.
Все три робота Anthropic соблюдают запреты в robots.txt, поэтому отключать Claude-SearchBot и Claude-User стоит, только если сайту не нужна видимость в ответах Claude с поиском и по запросам пользователей.
Различия ответов между моделями
Конкретных факторов отбора источников в ответах Claude и приложения Gemini поставщики не публикуют, поэтому советы надёжнее делить по режимам доступа, а не по особенностям моделей. Ответы разных моделей при этом различаются. В корейском исследовании AI Bigs Lab 715 брендов пищевых продуктов и франшиз в 30 категориях проверили в ChatGPT, Gemini, Perplexity и Claude в июле и августе 2026 года, и в 20 из 30 категорий бренд на первом месте зависел от используемого ИИ.

Подготовка контента и сайта к ИИ-ответам
Статьи в кейсе ниже перестраивали так: ответ ставили в начало, а текст делили на самостоятельные смысловые блоки. Блоки строили по логике «диагностика, причина, решение»: заголовок задаёт вопрос, первый абзац отвечает на него. Это не обязательное правило: Google для своего Поиска не требует ни дробления, ни переписывания текста специально для ИИ.
Экспертность подтверждают подписанные комментарии специалистов с должностью и практическими выводами, а E-E-A-T (опыт, экспертность, авторитетность и надёжность) служит ориентиром качества. Актуальность дают свежие данные и дата обновления страницы. Микроразметка Schema.org для генеративного поиска Google не обязательна, но остаётся частью SEO, а статья про микроразметку для LLM показывает, как её применять.

В кейсе Kokoc.com три статьи собственного блога имели хорошие позиции в органической выдаче, но почти не использовались в AI-ответах. Команда поставила ответ в начало, выделила самостоятельные блоки, обновила данные, добавила экспертные комментарии и микроразметку. К декабрю 2025 года количество упоминаний статьи про хакатоны в ответах «Алисы» и Google AI Overview выросло с 2 на 7 октября 2025 года до 12, то есть в 6 раз. Это итог комплекса работ на собственном блоге по одной статье из трёх, вклад отдельных правок не выделен.
Для бизнеса это повод проверить, цитируются ли страницы, которые уже хорошо стоят в поиске: сильные позиции не означают присутствия в AI-ответах. Как велась работа и какие правки вошли в комплекс, описано в кейсе о перестройке статей под AI-выдачу.
Как проверить, что компания попала в ответы ИИ
Чтобы узнать, называют ли вашу компанию в ответах, нужен набор вопросов о бренде и категории, которые задают одними и теми же словами при каждом замере. В набор входят вопросы покупателя на разных стадиях выбора, а не только название компании.
Каждый замер записывайте по одной схеме. Один ответ ничего не доказывает: по документации OpenAI, один и тот же вопрос может давать разные ответы, поэтому сопоставимы только повторные замеры по одному набору вопросов. В записи нужны пять полей:
- Дата и время замера.
- Модель.
- Режим работы, с поиском или без.
- Точная формулировка вопроса.
- Полный текст ответа.
Замеры разделяйте по режимам: ответ без поиска показывает знания модели, а ответ с поиском показывает доступность страниц.
Для Google есть отдельный инструмент: отчёт Generative AI performance в Search Console показывает, как контент работает в генеративных функциях Google Поиска и Discover. Он охватывает только Google, поэтому видимость в ответах ChatGPT, Claude и приложения Gemini проверяют по собственному набору вопросов.
На 1 ноября 2026 года России нет в официальных списках поддерживаемых стран ChatGPT (справка OpenAI), Claude (политика поддерживаемых регионов Anthropic) и веб-приложения Gemini (справка Google). В мае 2026 года сообщалось, что Claude массово блокирует аккаунты российских пользователей. Поэтому, планируя замеры в этих сервисах, учитывайте, что из России они официально недоступны.
Подробно о методике замера — в руководстве по видимости бренда в нейросетях.
Порядок действий для любой диалоговой нейросети
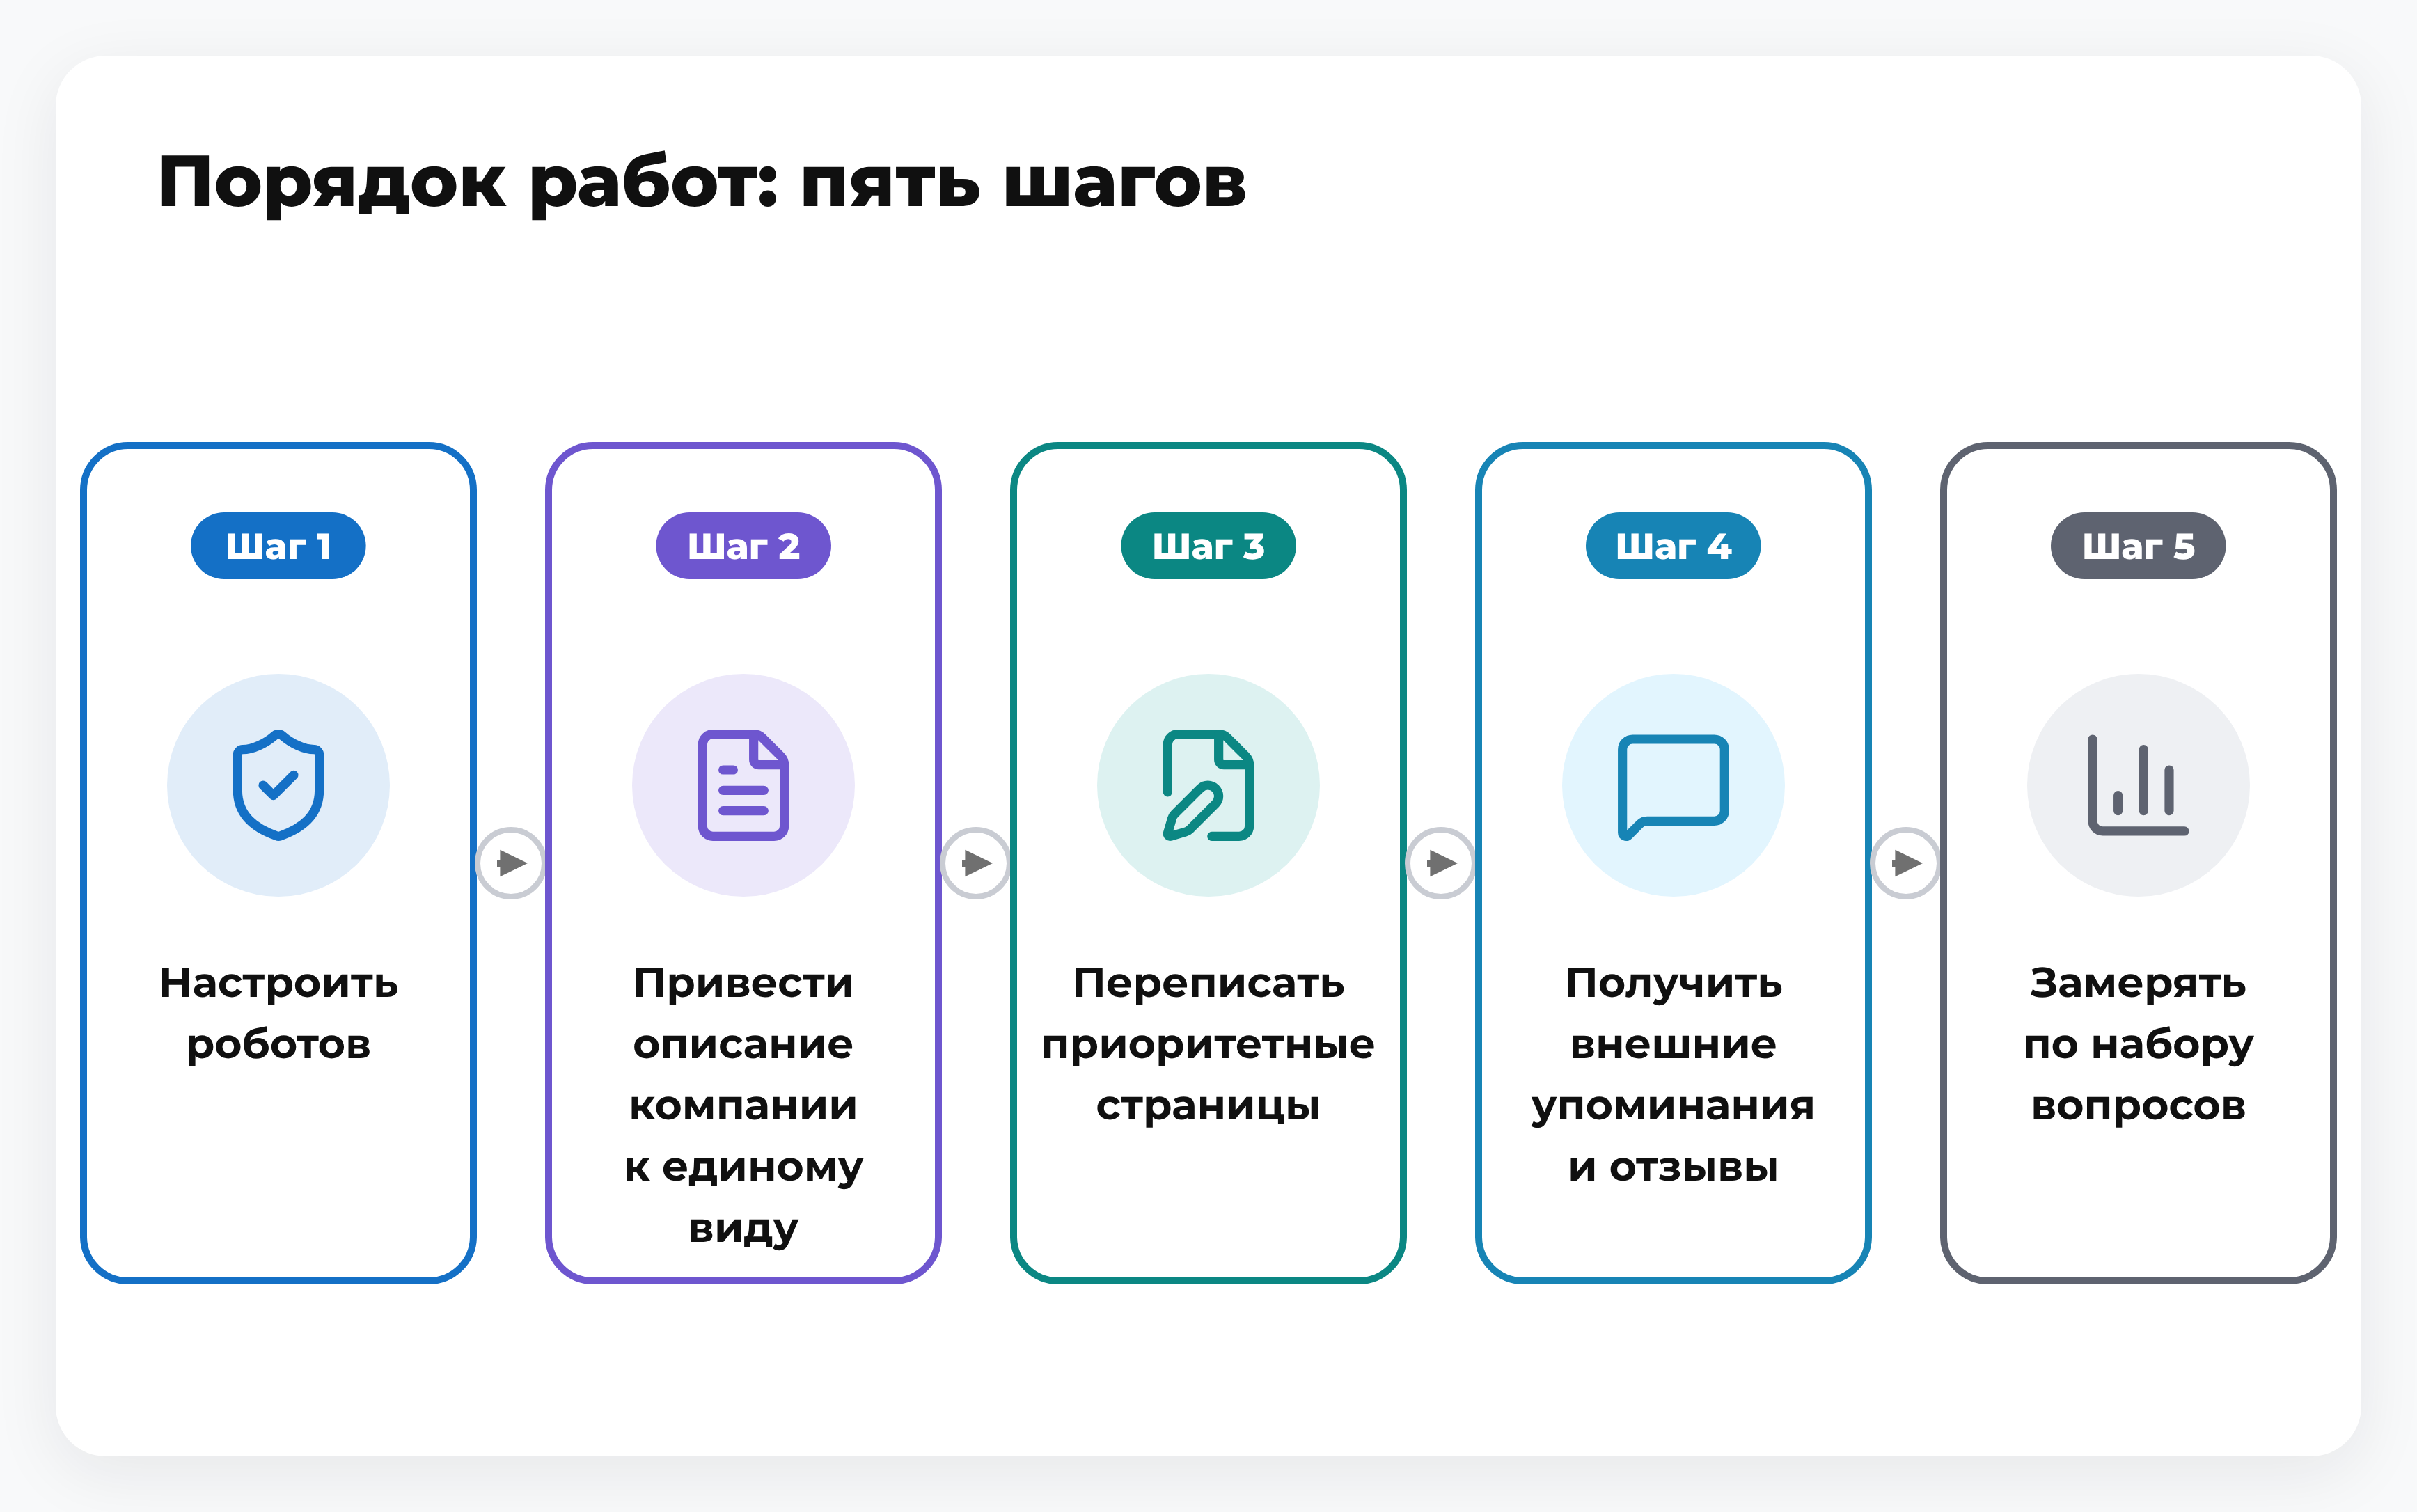
Работа идёт от того, что компания делает сама, к внешним упоминаниям и замеру, и стратегию лучше строить именно в этой последовательности.
- Проведите аудит robots.txt: решите по каждому боту, что ему разрешено (обучение, поиск, запрос пользователя), и убедитесь, что страницы открываются, попадают в карту сайта и проиндексированы.
- Приведите описание компании к единому виду на сайте и во внешних источниках.
- Перепишите приоритетные страницы: ответ в начале, самостоятельные блоки, экспертные комментарии, актуальные данные.
- Получите внешние упоминания и отзывы в авторитетных источниках без накрутки.
- Замеряйте ответы по набору вопросов и корректируйте приоритеты.
Результат зависит от конкурентов, ниши и рынка, поэтому гарантировать его нельзя, а замеры нужны, чтобы корректировать приоритеты. Начинайте с шагов 1–3: их компания выполняет сама, и они готовят основу для внешней работы. Ставка на один инструмент, например на специальный файл, не заменяет ни один из пяти шагов.
FAQ по оптимизации под LLM
Как быстро изменения отразятся в ответах?
Зависит от пути. После правки robots.txt системам поиска ChatGPT нужно примерно 24 часа, чтобы учесть новые настройки доступа: так сказано в документации OpenAI про OAI-SearchBot. Это срок для настроек, а не для появления в ответах: когда изменения на страницах и новые упоминания отразятся в ответах, поставщики не сообщают, а сроки попадания контента в обучение моделей не публикуют.
Нужен ли файл llms.txt?
Файл llms.txt советуют добавлять на сайт ради ИИ-систем, но Google Search его игнорирует: по словам Google, он не повредит и не поможет видимости сайта в Google. Другие сервисы и системы могут его использовать, и ради них файл можно создавать и вести.
Что делать компании с небольшим числом упоминаний?
В том же исследовании Ahrefs у ChatGPT самые слабые корреляции с брендовым поисковым спросом (0,352) и DR (0,266) среди трёх изученных систем. Авторы предполагают, что ChatGPT может чаще упоминать бренды с разным цифровым профилем, а не только крупных игроков, и для компании со скромным спросом, ссылками и упоминаниями он может оказаться удачной точкой входа. Это гипотеза авторов, а не гарантия.
Коротко о главном
- Бренд попадает в ответы моделей через доступность страниц и упоминания компании в сторонних источниках, а прямого способа внести его в модель нет.
- Ответ модели складывается из знаний обучения, контекстного окна и поиска или открытия страницы, и лучше всего настраивается третий путь.
- Роботы OpenAI, Anthropic и Google делятся по ролям: обучение, поиск, запрос пользователя; решение по каждой роли принимают отдельно.
- Внешние упоминания связаны с видимостью в ответах ChatGPT, AI Mode и AI Overviews сильнее, чем объём сайта (данные Ahrefs), но это корреляция, а не причинность.
- Ответ в начале страницы, экспертные комментарии и актуальные данные вошли в комплекс правок кейса Kokoc.com, где упоминаний одной статьи стало больше; вклад отдельных правок не выделен.
- Результат замеряют по повторяемому набору вопросов.

.png)
.png)



Комментарии (2)
Оставить комментарий