

Один общий запрет для всех ИИ-ботов в robots.txt закрывает сразу и тех, кто собирает контент для обучения моделей, и тех, кто даёт ссылки на ваш сайт в ответах ChatGPT, Claude и Perplexity. Цена такой ошибки — потеря видимости в ответах нейросетей.
ИИ-краулер — это бот нейросетевого сервиса, который заходит на страницы сайта, читает их и передаёт контент либо в обучающие наборы, либо в поисковый индекс сервиса.
В логах сервера и в настройках краулеров встречаются GPTBot, ClaudeBot, OAI-SearchBot, PerplexityBot. Страшно потерять трафик из ChatGPT, но и бесплатно отдавать материалы для обучения чужих моделей не хочется. Решение принимается по назначению бота.
- Два типа ИИ-краулеров и их фундаментальные отличия
- Боты для обучения и риск потери уникальности контента
- Боты для RAG-поиска как источник нового AEO-трафика
- Стратегия гибридного доступа (Allow/Disallow)
- Кейсы и последствия блокировки всех ИИ-ботов
- FAQ по работе ИИ-крайлеров
- Коротко о главном
Два типа ИИ-краулеров и их фундаментальные отличия
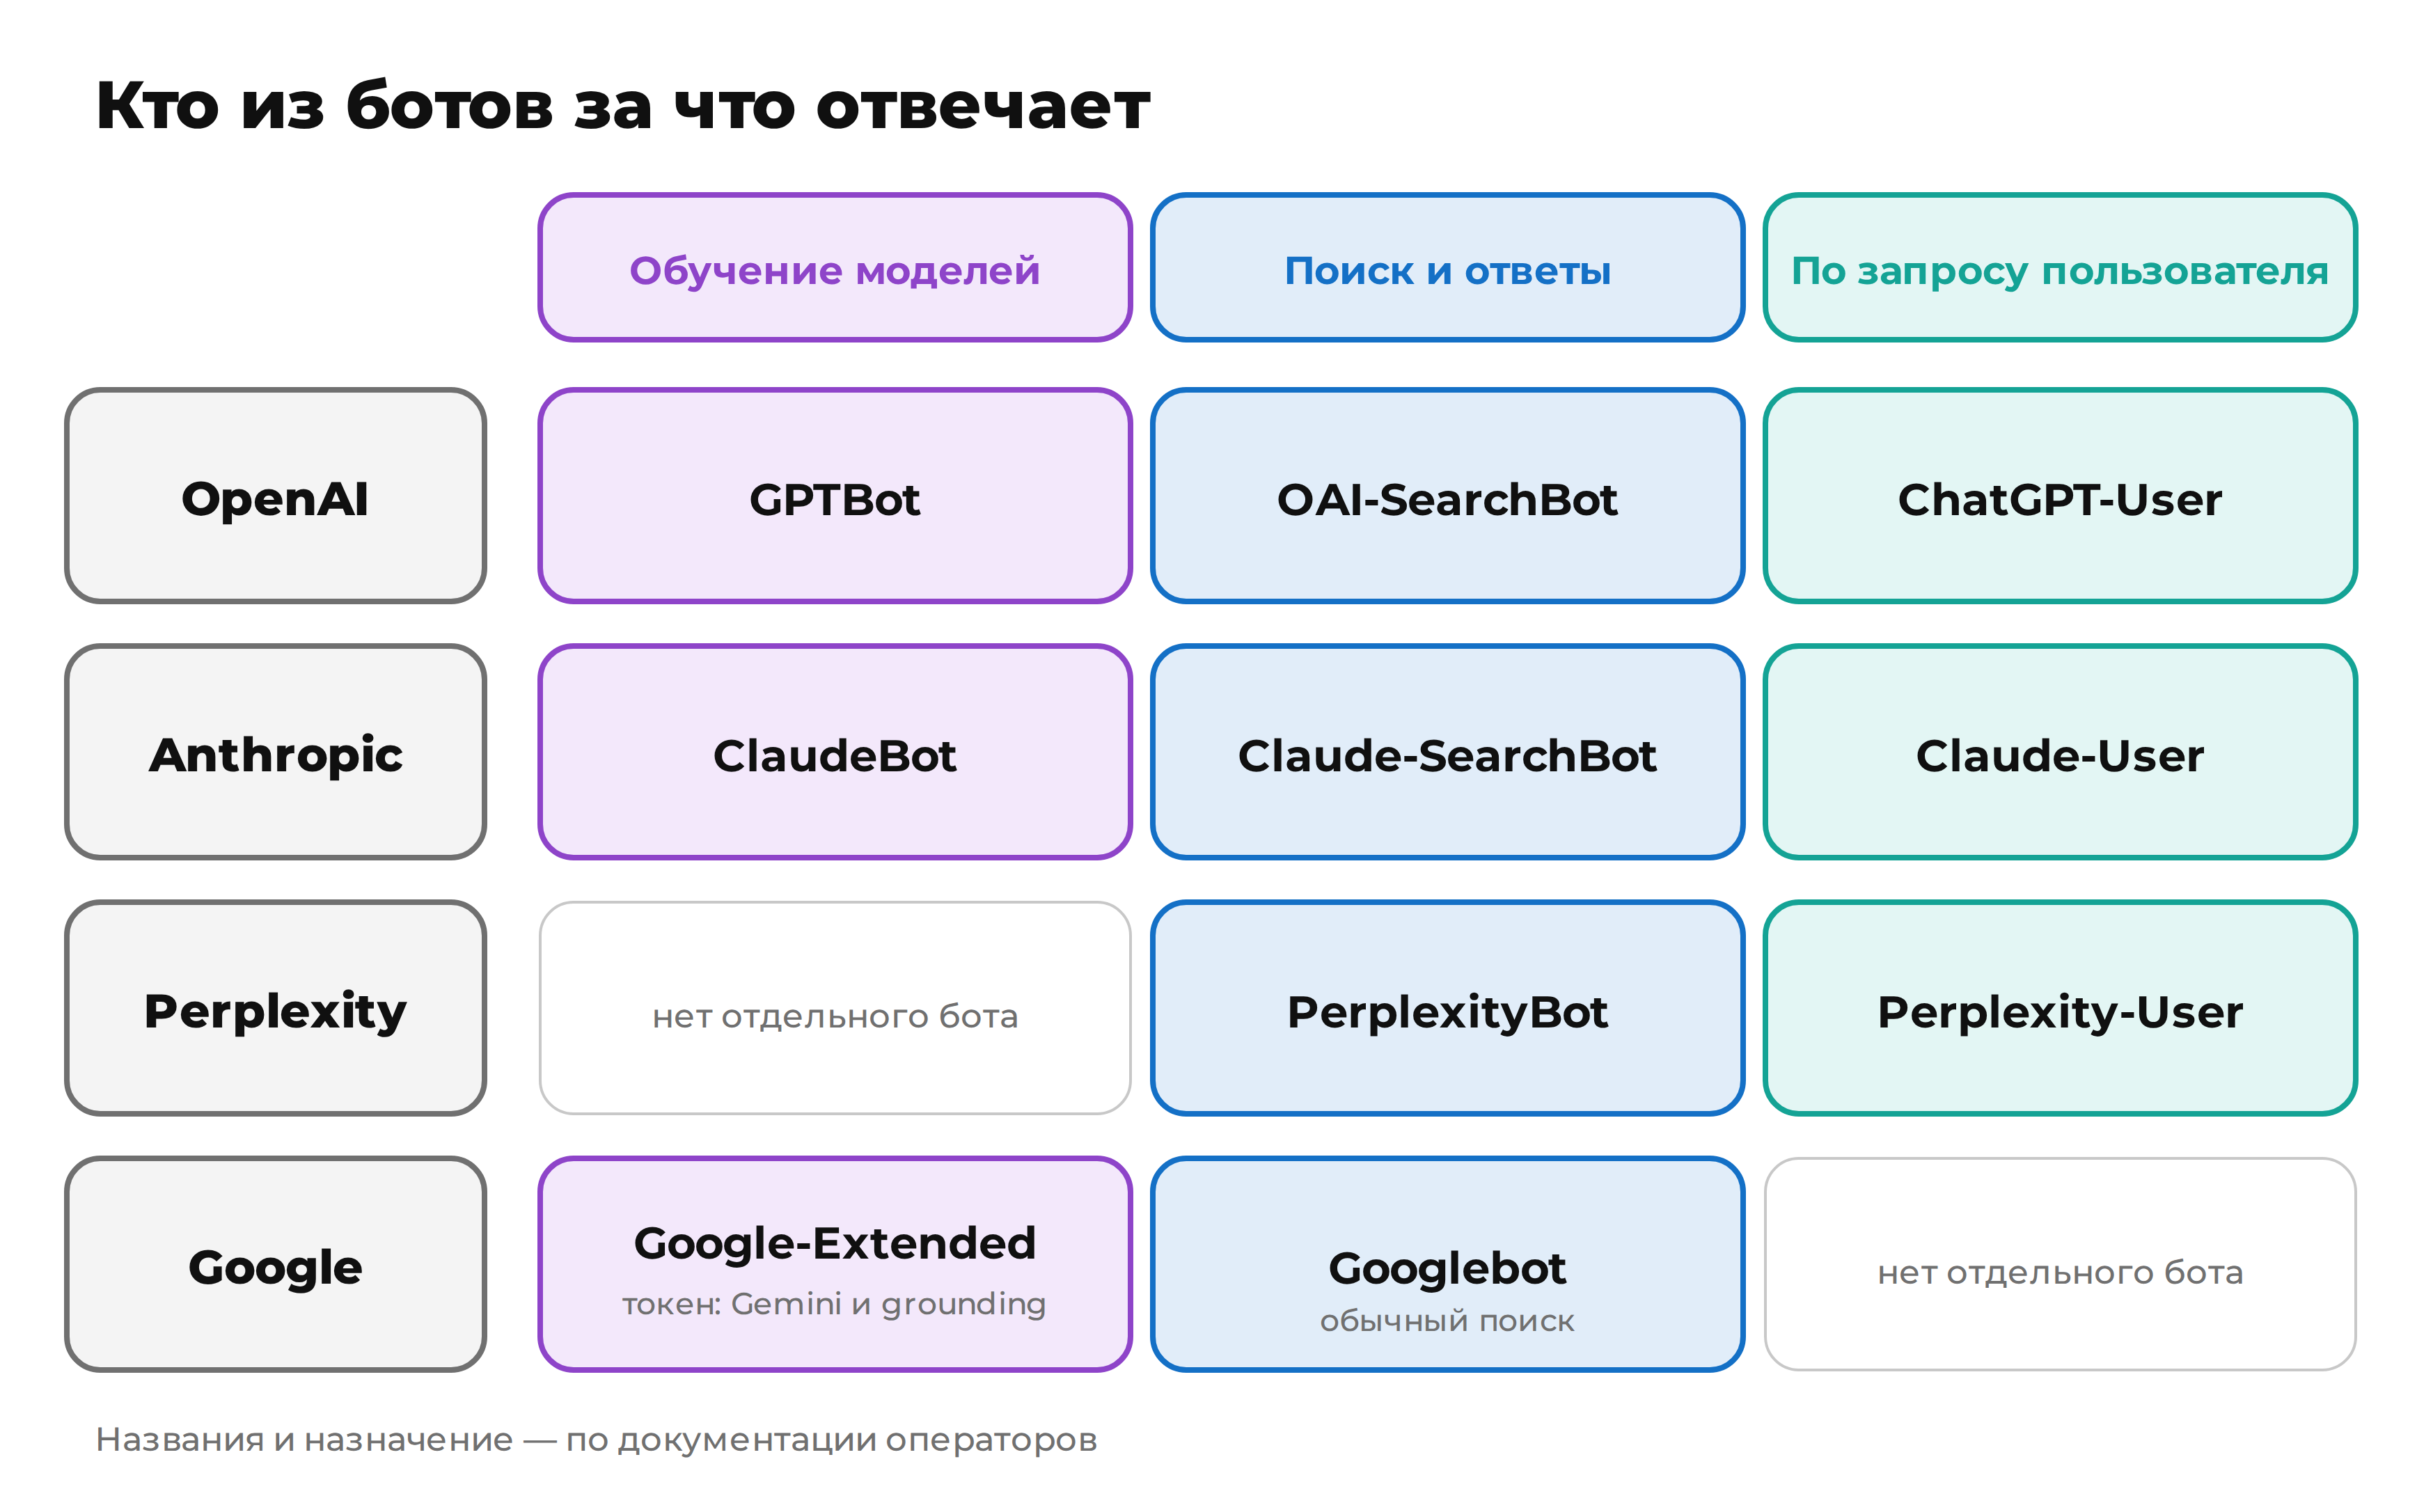
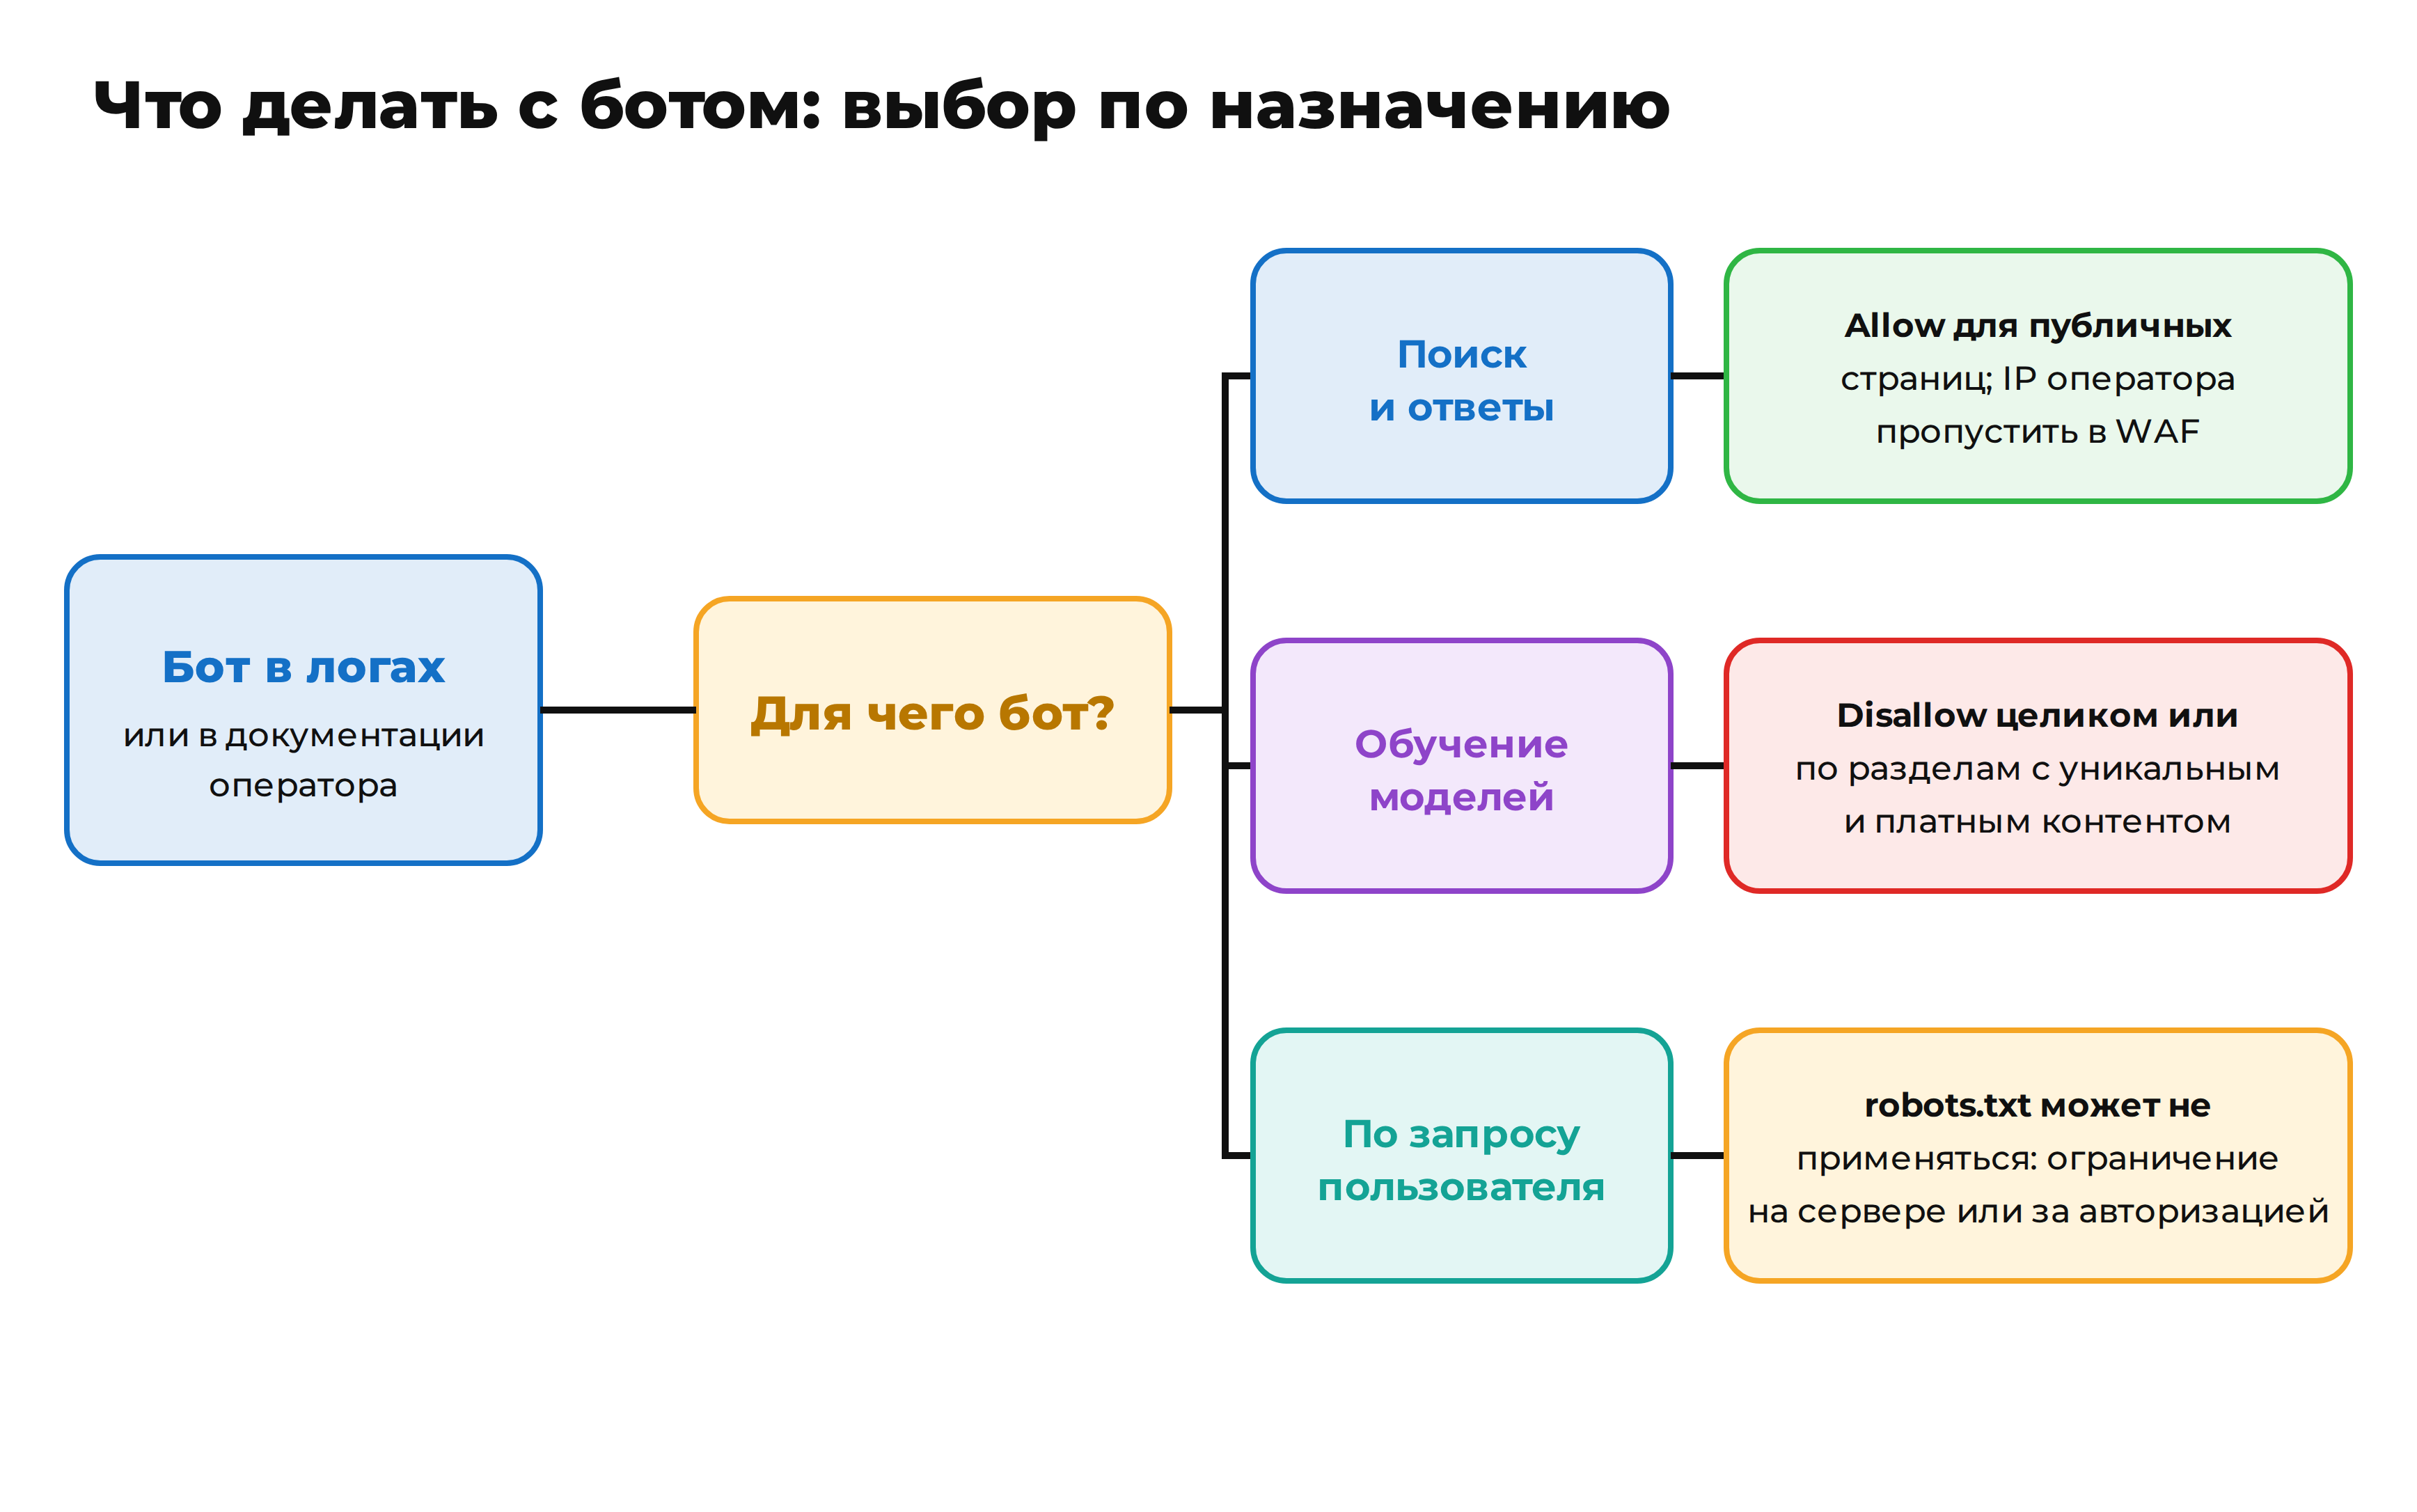
Бот для обучения собирает материал для будущих моделей, а бот поиска и ответов формирует индекс, из которого нейросеть берёт источники и ссылки. У одного оператора таких ботов несколько, и каждый настраивается отдельно: у OpenAI, например, OAI-SearchBot можно открыть, а GPTBot закрыть.
| Признак | Боты для обучения | Боты ИИ-поиска и ответов |
|---|---|---|
| Что делает бот | Обходит контент, который может использоваться для обучения моделей | Формирует поисковый индекс для ответов и ссылок |
| Что при блокировке | Сигнал не использовать материалы сайта для обучения; у Anthropic речь о будущих материалах | Сайт не показывается в поисковых ответах ChatGPT, но может остаться навигационной ссылкой; у Claude видимость может снизиться |
| Влияние на бизнес | Защита контента от бесплатного использования | Потеря видимости и трафика из нейросетей |
- Обучением занимаются GPTBot у OpenAI, ClaudeBot у Anthropic и токен Google-Extended у Google, который управляет ещё и подкреплением ответов в Gemini.
- Поиск и ответы обслуживают OAI-SearchBot, Claude-SearchBot и PerplexityBot, а обычный поиск Google — Googlebot.
- Запрос пользователя запускает ChatGPT-User, Claude-User и Perplexity-User.
ChatGPT-User, Perplexity-User и пользовательские загрузчики Google открываются, когда человек сам запросил страницу. OpenAI пишет, что правила robots.txt для таких действий могут не применяться, а Perplexity и Google отмечают, что их загрузчики, как правило, игнорируют эти правила. Claude-User в этой группе исключение: по документации Anthropic, боты компании соблюдают стандартные директивы robots.txt.
ChatGPT-User не определяет попадание в поиск ChatGPT, поэтому закрывать его ради выхода из поиска не стоит: для этого у OpenAI есть OAI-SearchBot.
Боты для обучения и риск потери уникальности контента
GPTBot и ClaudeBot собирают контент, который может использоваться для обучения моделей. По документации OpenAI, запрет GPTBot означает, что материалы сайта не следует использовать для обучения, а Anthropic уточняет, что ограничение ClaudeBot относится к будущим материалам. Так блокировка GPTBot защищает контент от бесплатного использования в обучении. Ни OpenAI, ни Anthropic не заявляют, что запрет удаляет уже собранные данные из обучающих наборов, поэтому его стоит считать сигналом на будущее.
Google-Extended — отдельный токен robots.txt без собственной строки user-agent: обход выполняют обычные агенты Google. Токен управляет использованием уже обойдённого контента для обучения будущих моделей Gemini и для подкрепления ответов (grounding) в Gemini Apps и в Grounding with Google Search на Vertex AI. На включение сайта в Google Поиск и ранжирование он не влияет.
По данным Cloudflare за период до июля 2025 года, на обучение приходится почти 80% активности ИИ-ботов, годом ранее было 72%. Доли отдельных ботов Cloudflare считает от всего трафика ИИ-краулеров и поисковых ботов: доля GPTBot выросла с 4,7% до 11,7%, ClaudeBot — с 6% до почти 10%. Регион России отдельно не выделен.
Критерии лучше применять к разделам сайта, а не к сайту целиком. От обучающих ботов стоит закрывать уникальные исследования и данные, платные и экспертные материалы и тексты, на которые у компании особые права. Типовой справочный контент и страницы, которые должны попадать в ответы нейросетей, оставляйте открытыми: защита работает там, где она нужна.
Боты для RAG-поиска как источник нового AEO-трафика
RAG (retrieval-augmented generation) — это подход, при котором нейросеть перед ответом находит и читает актуальные страницы, а не опирается только на обучение. Боты поиска формируют индекс таких страниц и дают на них ссылки в ответах. AEO (answer engine optimization) — это работа над тем, чтобы сайт попадал в такие ответы и приводил из них посетителей.
Что теряет сайт без доступа поисковых ботов
Блокировка OAI-SearchBot лишает трафика из ChatGPT: закрытый для него сайт не показывается в поисковых ответах ChatGPT, хотя может остаться навигационной ссылкой. OpenAI рекомендует разрешить бота в robots.txt и пропускать запросы с опубликованных диапазонов IP.
Отключение Claude-SearchBot не даёт Anthropic индексировать контент для поиска Claude и может снизить видимость сайта. PerplexityBot показывает сайты и ссылки в результатах Perplexity и, по словам самой компании, не собирает контент для базовых моделей; ему тоже нужны разрешение и пропуск IP-диапазонов. У Google отдельного бота для AI Overviews документация не называет. Страница может стать поддерживающей ссылкой в AI Overviews и AI Mode, если проиндексирована и может показываться в Поиске со сниппетом.
По данным Cloudflare за июль 2025 года, у Anthropic приходится около 38 000 обходов на одного пришедшего посетителя, у Perplexity — 194. Метрика считает все обходы платформы, а не долю переходов из Claude. Переходов пока мало относительно обходов, но без доступа для поисковых ботов сайт не попадёт в ответы с такими ссылками. Открытый доступ — только первое условие, дальше страница должна попасть в сами ответы. Эту работу ведут в рамках продвижения сайта в нейросетях, а об оформлении страниц мы писали в разборе оптимизации под AI-сниппеты Google и Яндекса.
Стратегия гибридного доступа (Allow/Disallow)
Общее правило такое: пускать ботов поиска и ответов на публичные страницы, ботов обучения закрывать целиком или по разделам, а платный и персональный контент защищать авторизацией и серверными правилами, а не одним robots.txt. Конкретные Allow и Disallow зависят от того, что сайт считает активом. Блогу или сайту услуг, которым важна видимость в ответах, достаточно открыть поисковых ботов и решить по разделам, кого из обучающих закрыть. Сайту с платным или уникальным контентом обучающих ботов закрывают по разделам, а платное прячут за авторизацией.
Пример robots.txt, где поиск открыт, а обучение закрыто
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

Sitemap: https://example.com/sitemap.xml
Боты, не названные в файле, этими правилами не затронуты, потому что общей группы со звёздочкой здесь нет. Учтите, что запрет Google-Extended отключает и подкрепление ответов в приложении Gemini: если сайту нужна видимость в Gemini, эту группу не добавляйте. Для частичного закрытия вместо «/» указывают путь раздела, например Disallow: /research/.
Файл остаётся просьбой для добросовестных ботов: Google пишет, что инструкции в robots.txt не принуждают краулер и что некоторые краулеры им не следуют. Жёсткое ограничение строят на уровне сервера, по IP-диапазонам из документации операторов и правилами WAF (межсетевого экрана веб-приложений), а платные материалы защищают паролем. После правки проверьте три вещи: файл открывается по адресу сайта без ошибок, сервер и CDN не режут поисковых ботов, которых он разрешает, а в логах видны их реальные запросы.
Строка user-agent сама по себе не доказывает, что запрос пришёл от бота оператора: сверяйте IP с опубликованными диапазонами OpenAI и Perplexity, а для Googlebot используйте обратный DNS.
Кейсы и последствия блокировки всех ИИ-ботов
Общий запрет всех ИИ-ботов закрывает сайт и для обучения, и для ответов: он перестаёт быть источником в поисковых ответах ChatGPT и возможно теряет видимость в поиске Claude и в Perplexity. Обычный Google Поиск при этом зависит от Googlebot, а не от Google-Extended. Если запрет записан для User-agent со звёздочкой, он затрагивает и поисковых ботов без своей группы, поэтому безопаснее прописывать Disallow для обучающих ботов по именам.
Часто закрывают GPTBot и считают сайт скрытым от ChatGPT или оставляют шаблонный Disallow от прежних задач. Ещё одна ошибка — закрыть поисковых ботов на уровне WAF или CDN при разрешающем robots.txt, хотя OpenAI и Perplexity просят пропускать опубликованные IP-адреса. По данным Hostinger в пересказе Search Engine Journal от 20 января 2026 года, средний охват OAI-SearchBot по сайтам выборки составил 55,67%, а охват GPTBot упал с 84% до 12%: это динамика охвата, а не объём трафика.
| Конфигурация | Что происходит |
|---|---|
| Закрыты по именам все поисковые боты | Сайт не показывается в поисковых ответах ChatGPT, в Claude видимость может снизиться, у Perplexity нет индекса для ссылок |
| Открыт GPTBot, закрыт OAI-SearchBot | Сайт может использоваться для обучения, но не показывается в ответах ChatGPT |
Специалисты Kokoc.com в GEO-проекте для сервиса доставки еды с тремя брендами и 29 регионами начинали с аудита, куда входила проверка доступности сайта для ИИ-краулеров. По замерам из кейса доля топ-1 в ответах Алисы, Google AI и Perplexity выросла у первого бренда с 3,81 до 12%. У второго она поднялась с 1,43 до 7%, у третьего с 12,86 до 37%.
Результат дал весь комплекс работ, включая статьи на внешних площадках. Доступ ботов сам по себе его не обеспечил, а в топ-3 у первого бренда роста нет. Этапы и замеры описаны в кейсе о росте видимости бренда в ответах нейросетей.
Проверку доступности для ИИ-краулеров лучше делать до других правок, иначе работа над видимостью опирается на страницы, которые бот не видит. Чек-лист такой проверки есть в комплексном AI-аудите сайта.
FAQ по работе ИИ-крайлеров
Через сколько вступит в силу правка robots.txt?
У OpenAI на настройку систем для поиска после обновления файла может уйти около 24 часов. Запрет для YandexAdditional Яндекс учитывает по мере обновления поисковых данных, обычно за 2–14 дней. Результат правки в логах смотрите с учётом этих сроков.
Можно ли отключить AI Overviews в Google и сохранить поиск?
Показом управляют директивами для Googlebot и элементами управления сниппетом: nosnippet, data-nosnippet, max-snippet. Они ограничивают информацию со страницы, которую Google показывает в Поиске, включая AI-функции. Сама страница при nosnippet остаётся в выдаче, но отключить только AI Overviews этими элементами не получится. Google-Extended на Поиск не влияет.
Как закрыть контент от Алисы и нейросети Яндекса?
В robots.txt добавляют ограничение для YandexAdditional или YandexAdditionalBot, например отдельной группой User-agent: YandexAdditional и Disallow: /. Быстрые ответы на основе YandexGPT формируются только для региона Россия.
Где смотреть актуальный список ИИ-ботов?
OpenAI публикует список своих ботов и предлагает RSS-подписку на обновления, Google ведёт список общих краулеров, а у Anthropic данные есть в справочной статье о сборе контента. Номер версии в user-agent меняется.
Коротко о главном
Что нужно запомнить, когда решаете, кого пускать на сайт:
- Решение принимают по назначению бота: обучение, поиск и ответы или запрос пользователя.
- Закрытие поисковых ботов лишает сайт видимости и трафика из ответов нейросетей.
- Закрытие обучающих ботов защищает контент на будущее.
- Гибридный доступ собирается из отдельных групп для каждого бота.
- robots.txt остаётся просьбой, а жёсткую защиту строят на сервере.
- Доступность для ИИ-краулеров проверяют до других правок.
.png)
.png)


Комментарии (2)
Оставить комментарий