

Бренд в ответах нейросетей может быть назван, но подан так, что клиент уйдёт к конкуренту: с оговоркой «изучите отзывы», в конце списка или рядом с другим поставщиком. Факт упоминания не показывает, как нейросети говорят о бренде. Тональность упоминания измеряют серией повторяемых запросов, ответы на которые размечают по единому кодексу, то есть набору правил для позитива, нейтрала и негатива. Один ответ или одна позитивная публикация ничего не доказывают.
- Что такое Sentiment Analysis в контексте LLM
- Почему нейросети могут формировать негативный образ бренда
- Ручная разметка или автоматизация в оценке тональности
- Расчёт индекса лояльности ИИ (AI Sentiment Score)
- Влияние тональности ответов на доверие пользователей
- Что делать с негативом в ответах нейросетей
- Коротко о главном
Что такое Sentiment Analysis в контексте LLM
Анализ тональности (Sentiment Analysis) — это оценка эмоциональной окраски текста методами обработки естественного языка (NLP). Применительно к большим языковым моделям (LLM) это оценка того, как нейросеть говорит о компании в своём ответе.
Тональность упоминания бывает позитивной (рекомендация с аргументами), нейтральной (справка без оценки) или негативной (предупреждение, критика, жалоба). Упоминание с плюсами и оговорками размечают как смешанное. Размечают само упоминание бренда, а не весь ответ: если рынок хвалят, а бренд назван вскользь, позитива о бренде нет.
Видимость и тональность — разные показатели: бренд могут называть часто, но после конкурентов. Фиксируйте контекст: тип запроса (небрендовый, брендовый, сравнительный) и роль бренда (рекомендован, один из списка, вторая альтернатива). Ответ нейросети синтезирует модель, а не живой автор отзыва, поэтому мониторинг отзывов не покажет, что скажут ChatGPT, Google AI Overviews или Яндекс Нейро.
Почему нейросети могут формировать негативный образ бренда
В измеренных выборках негатив встречается редко. По данным Analyze AI (4 августа 2026), в частичной B2B-выборке, где бренд назван и оценён, позитивных или сильно позитивных ответов 58,3%, нейтральных 39,1%, негативных 0,9%. По данным BrightEdge (5 марта 2026), негатив составляет примерно 2,3% упоминаний в генеративных ответах Google и примерно 1,6% в ChatGPT; размер выборки не указан.
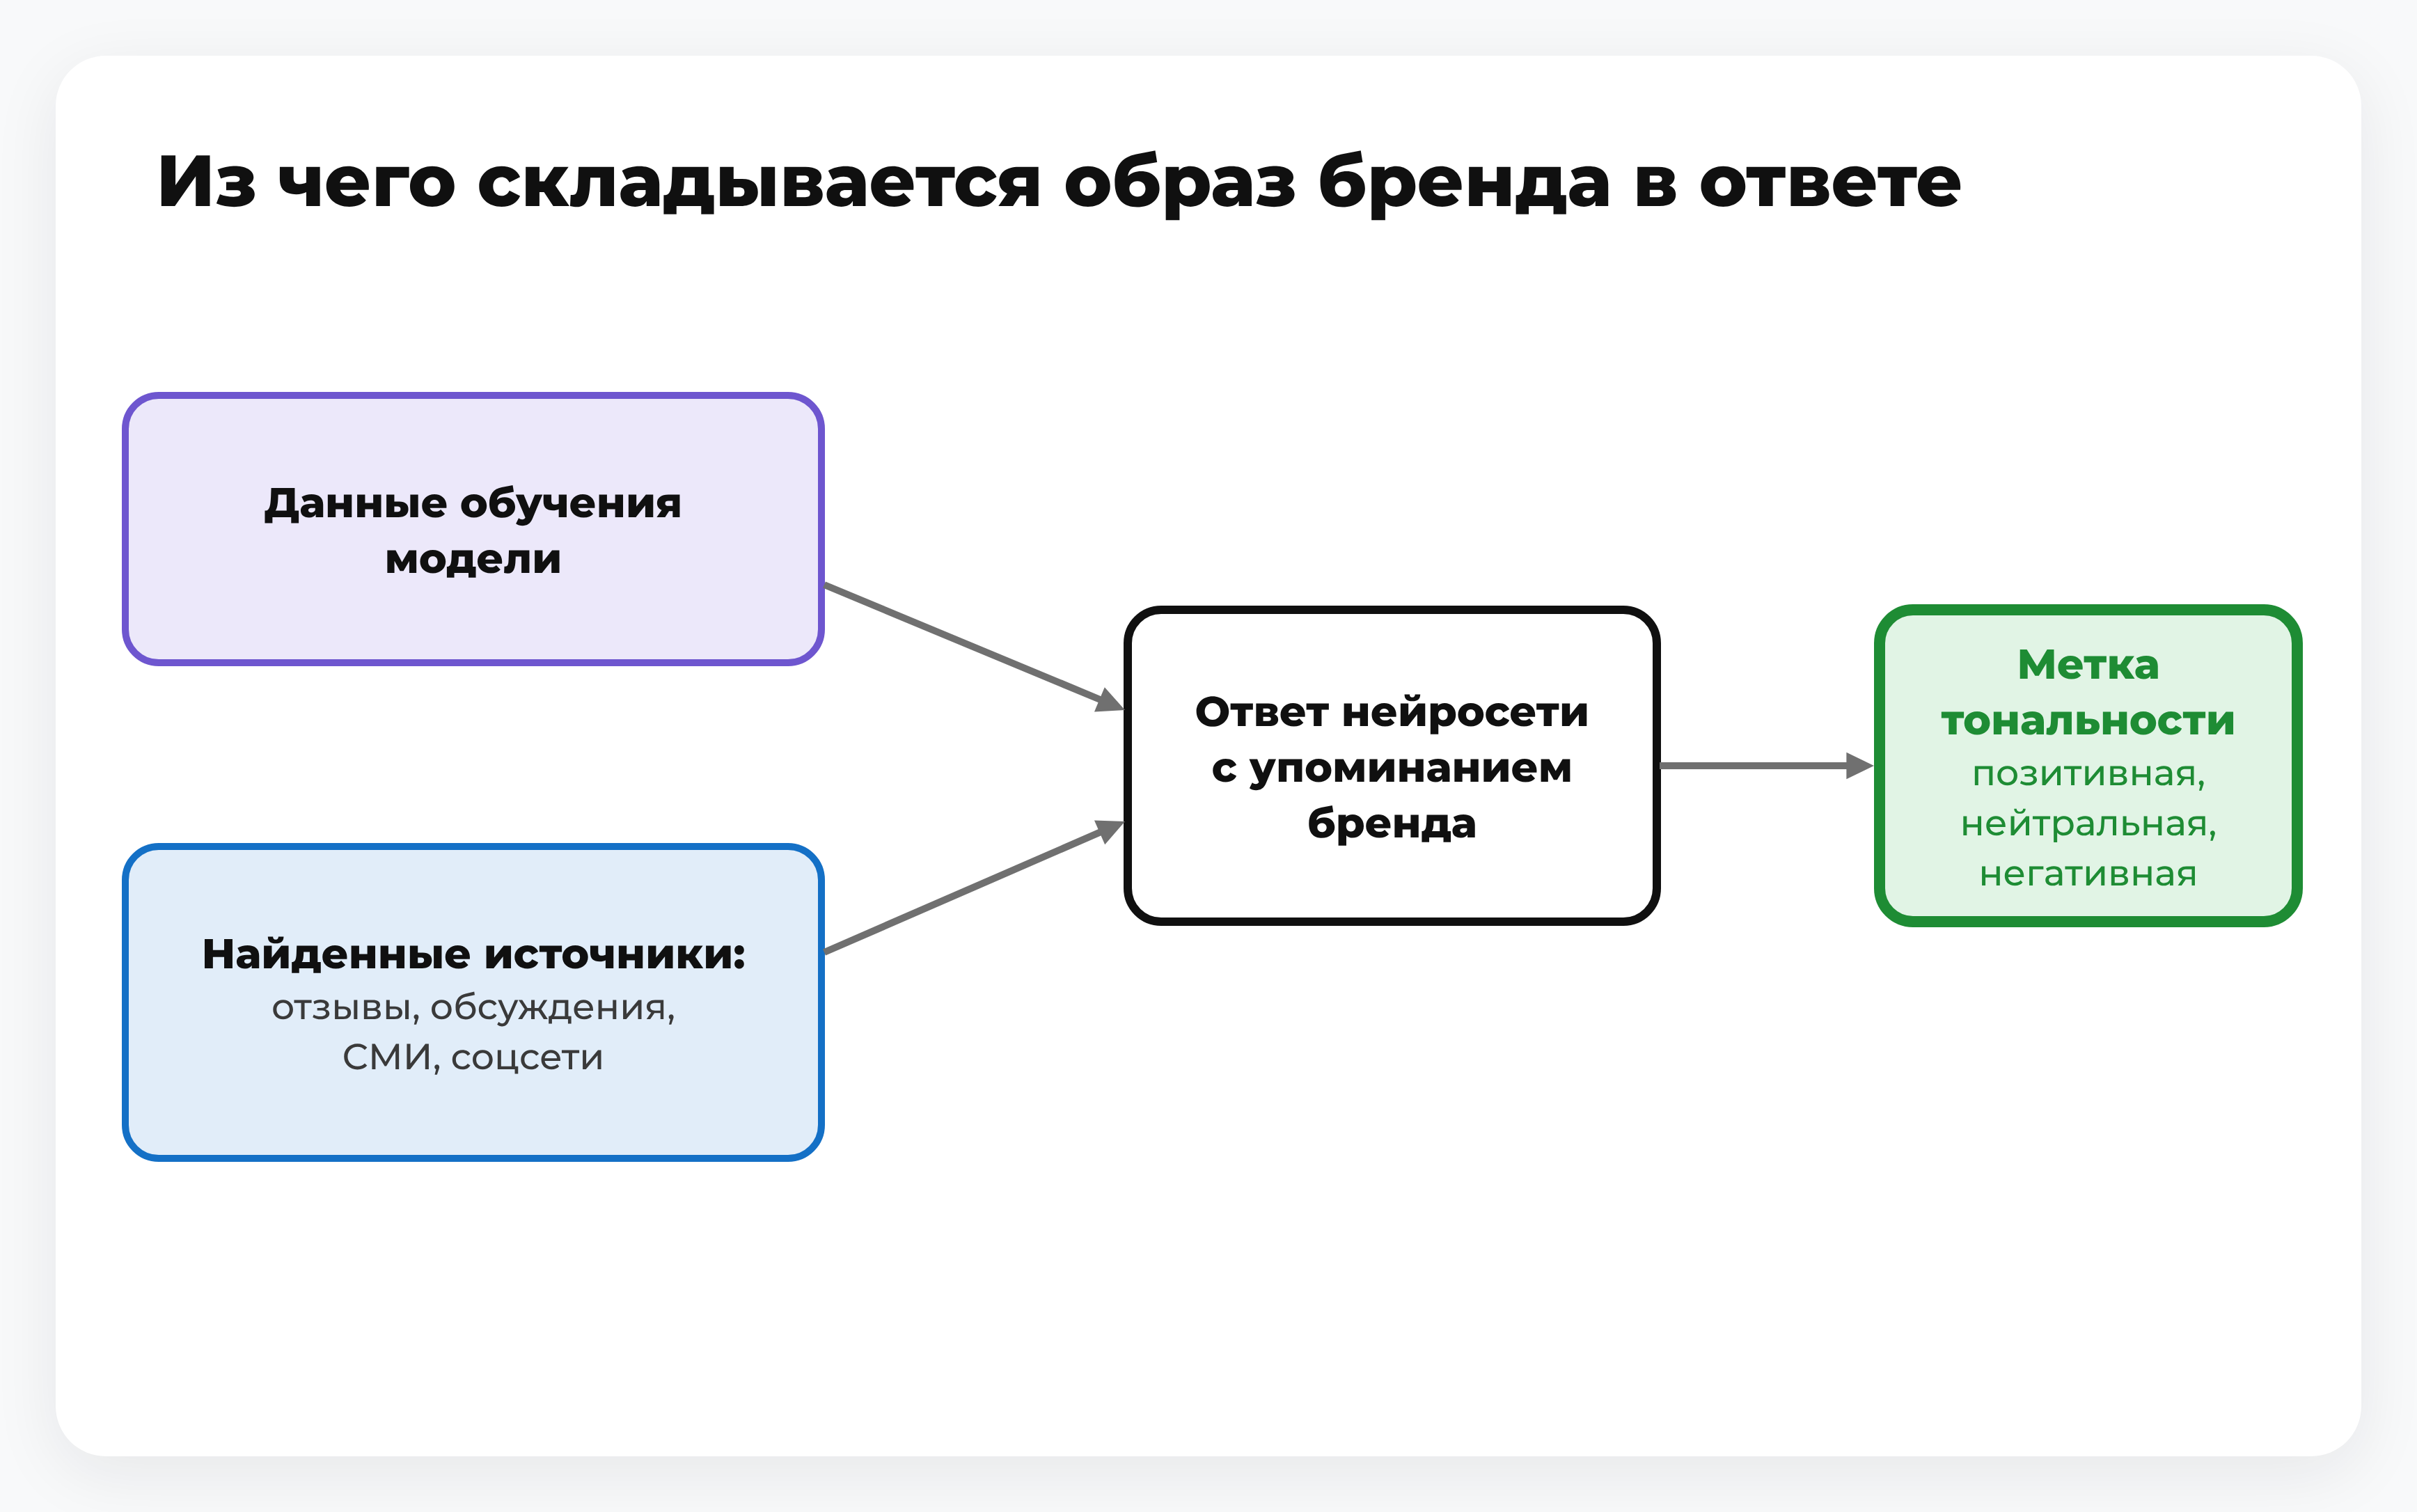
Образ складывается из данных обучения модели и найденных при ответе источников: отзывов, обсуждений, СМИ, соцсетей. Старые жалобы остаются в информационном поле и могут попасть в ответ. Тональность страницы в ответ не переносится: в измеренной когорте Analyze AI корреляция равна 0,00 на 985 парах.
По тем же данным BrightEdge, Google AI Overviews чаще поднимает спорные новости, а ChatGPT — оценку продукта. На одинаковых запросах, где негатив выдали обе системы, они критиковали разные бренды в 73% случаев. Поэтому каждую нейросеть измеряют отдельно.
Виды негативной и слабой тональности в ответах
Токсичные и негативные ассоциации в ответе бывают пяти видов:
- прямой негатив («клиенты жалуются на сроки»);
- осторожная оговорка («изучите отзывы перед заказом»);
- рекомендация конкурента вместо бренда;
- упоминание в конце списка;
- устаревшие или искажённые данные о компании.
Формулировка подсказывает тип, но не причину: источник проверяют отдельно.
Ручная разметка или автоматизация в оценке тональности
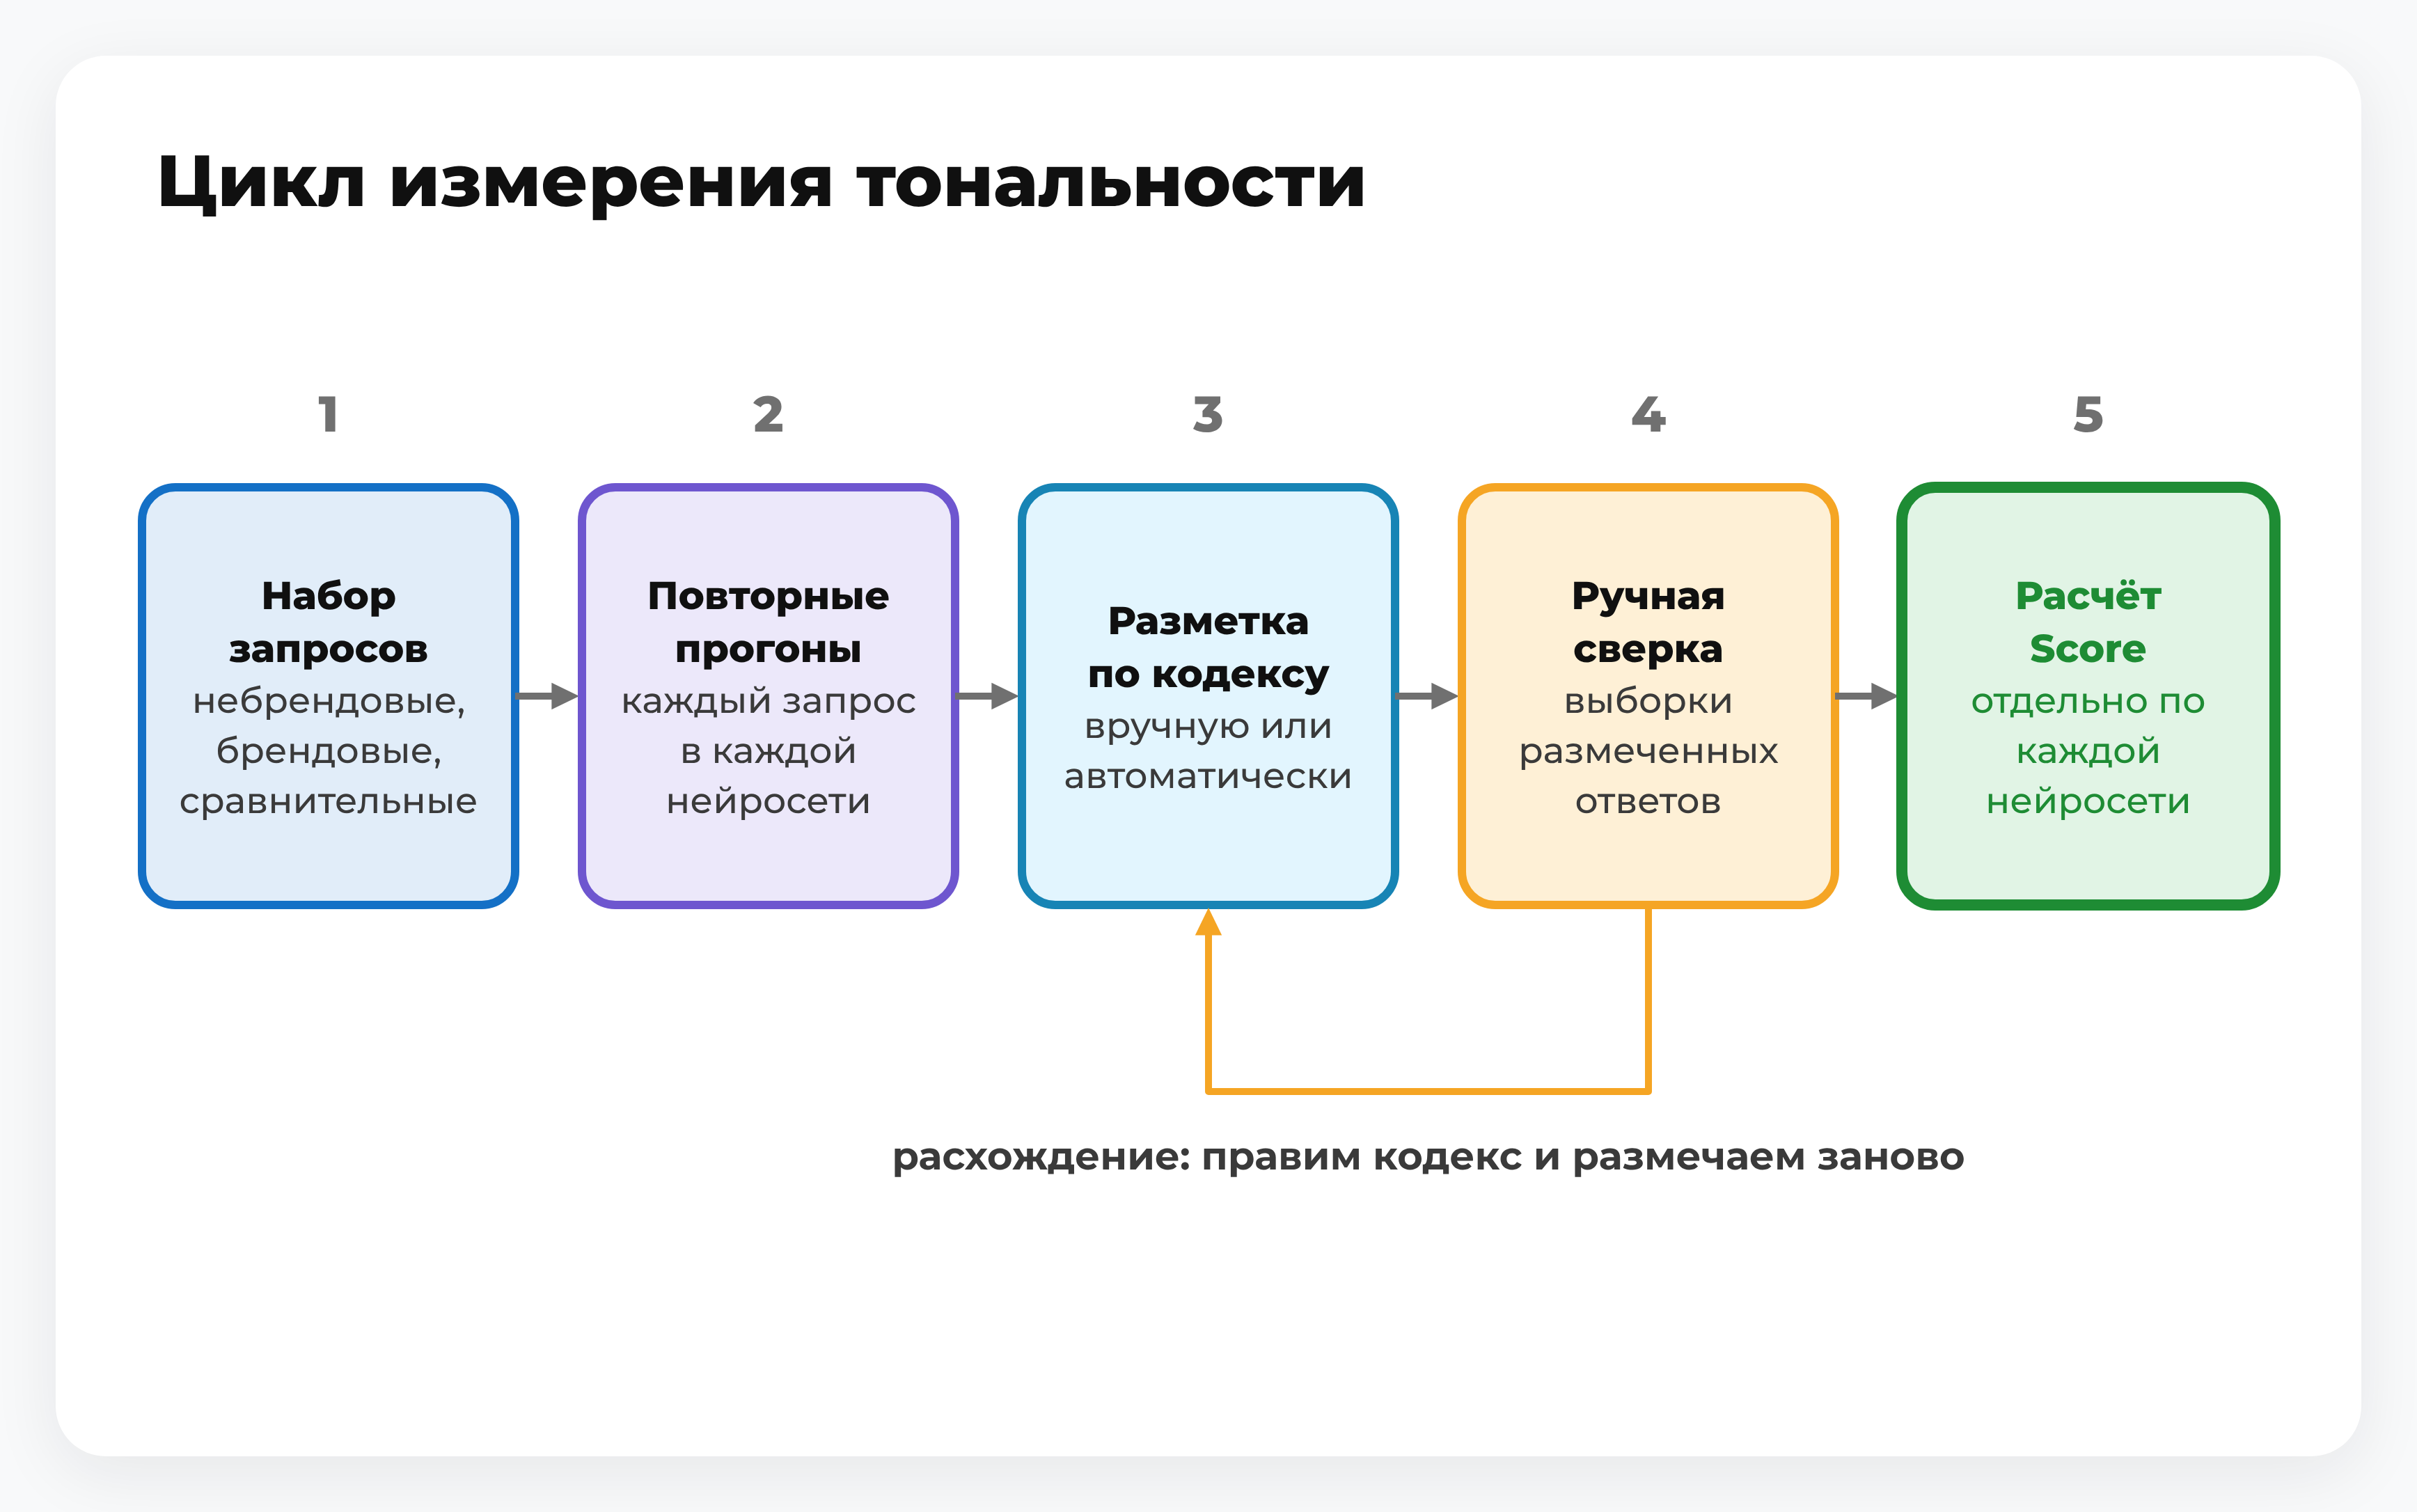
Ручная разметка начинается с кодекса: метка, примеры формулировок, роль бренда. В журнал вносят запрос, нейросеть, дату, цитату, метку, роль бренда и оговорку. Спорные ответы размечают двое; способ подходит для калибровки первой серии и смешанных ответов.
Автоматизация даёт масштаб: LLM-классификатор с тем же кодексом в промпте, NLP-модели или сервисы мониторинга размечают сотни ответов. Но автоматике нельзя верить на слово. В исследовании ACL GEM 2026 (семинар Ассоциации компьютерной лингвистики по генерации текста, её оценке и метрикам, июль 2026) три LLM-разметчика и два классификатора на текстах Википедии на пяти языках, включая русский, заметно расходились по меткам, согласию и стабильности. Это энциклопедический текст, а не ответы о брендах.
Сверяйте часть автоматической разметки с ручной, особенно «смешанные» и «негативные» ответы, повторяйте прогон и правьте кодекс по расхождениям. Автоматизацию оставляют для регулярного мониторинга.
Расчёт индекса лояльности ИИ (AI Sentiment Score)
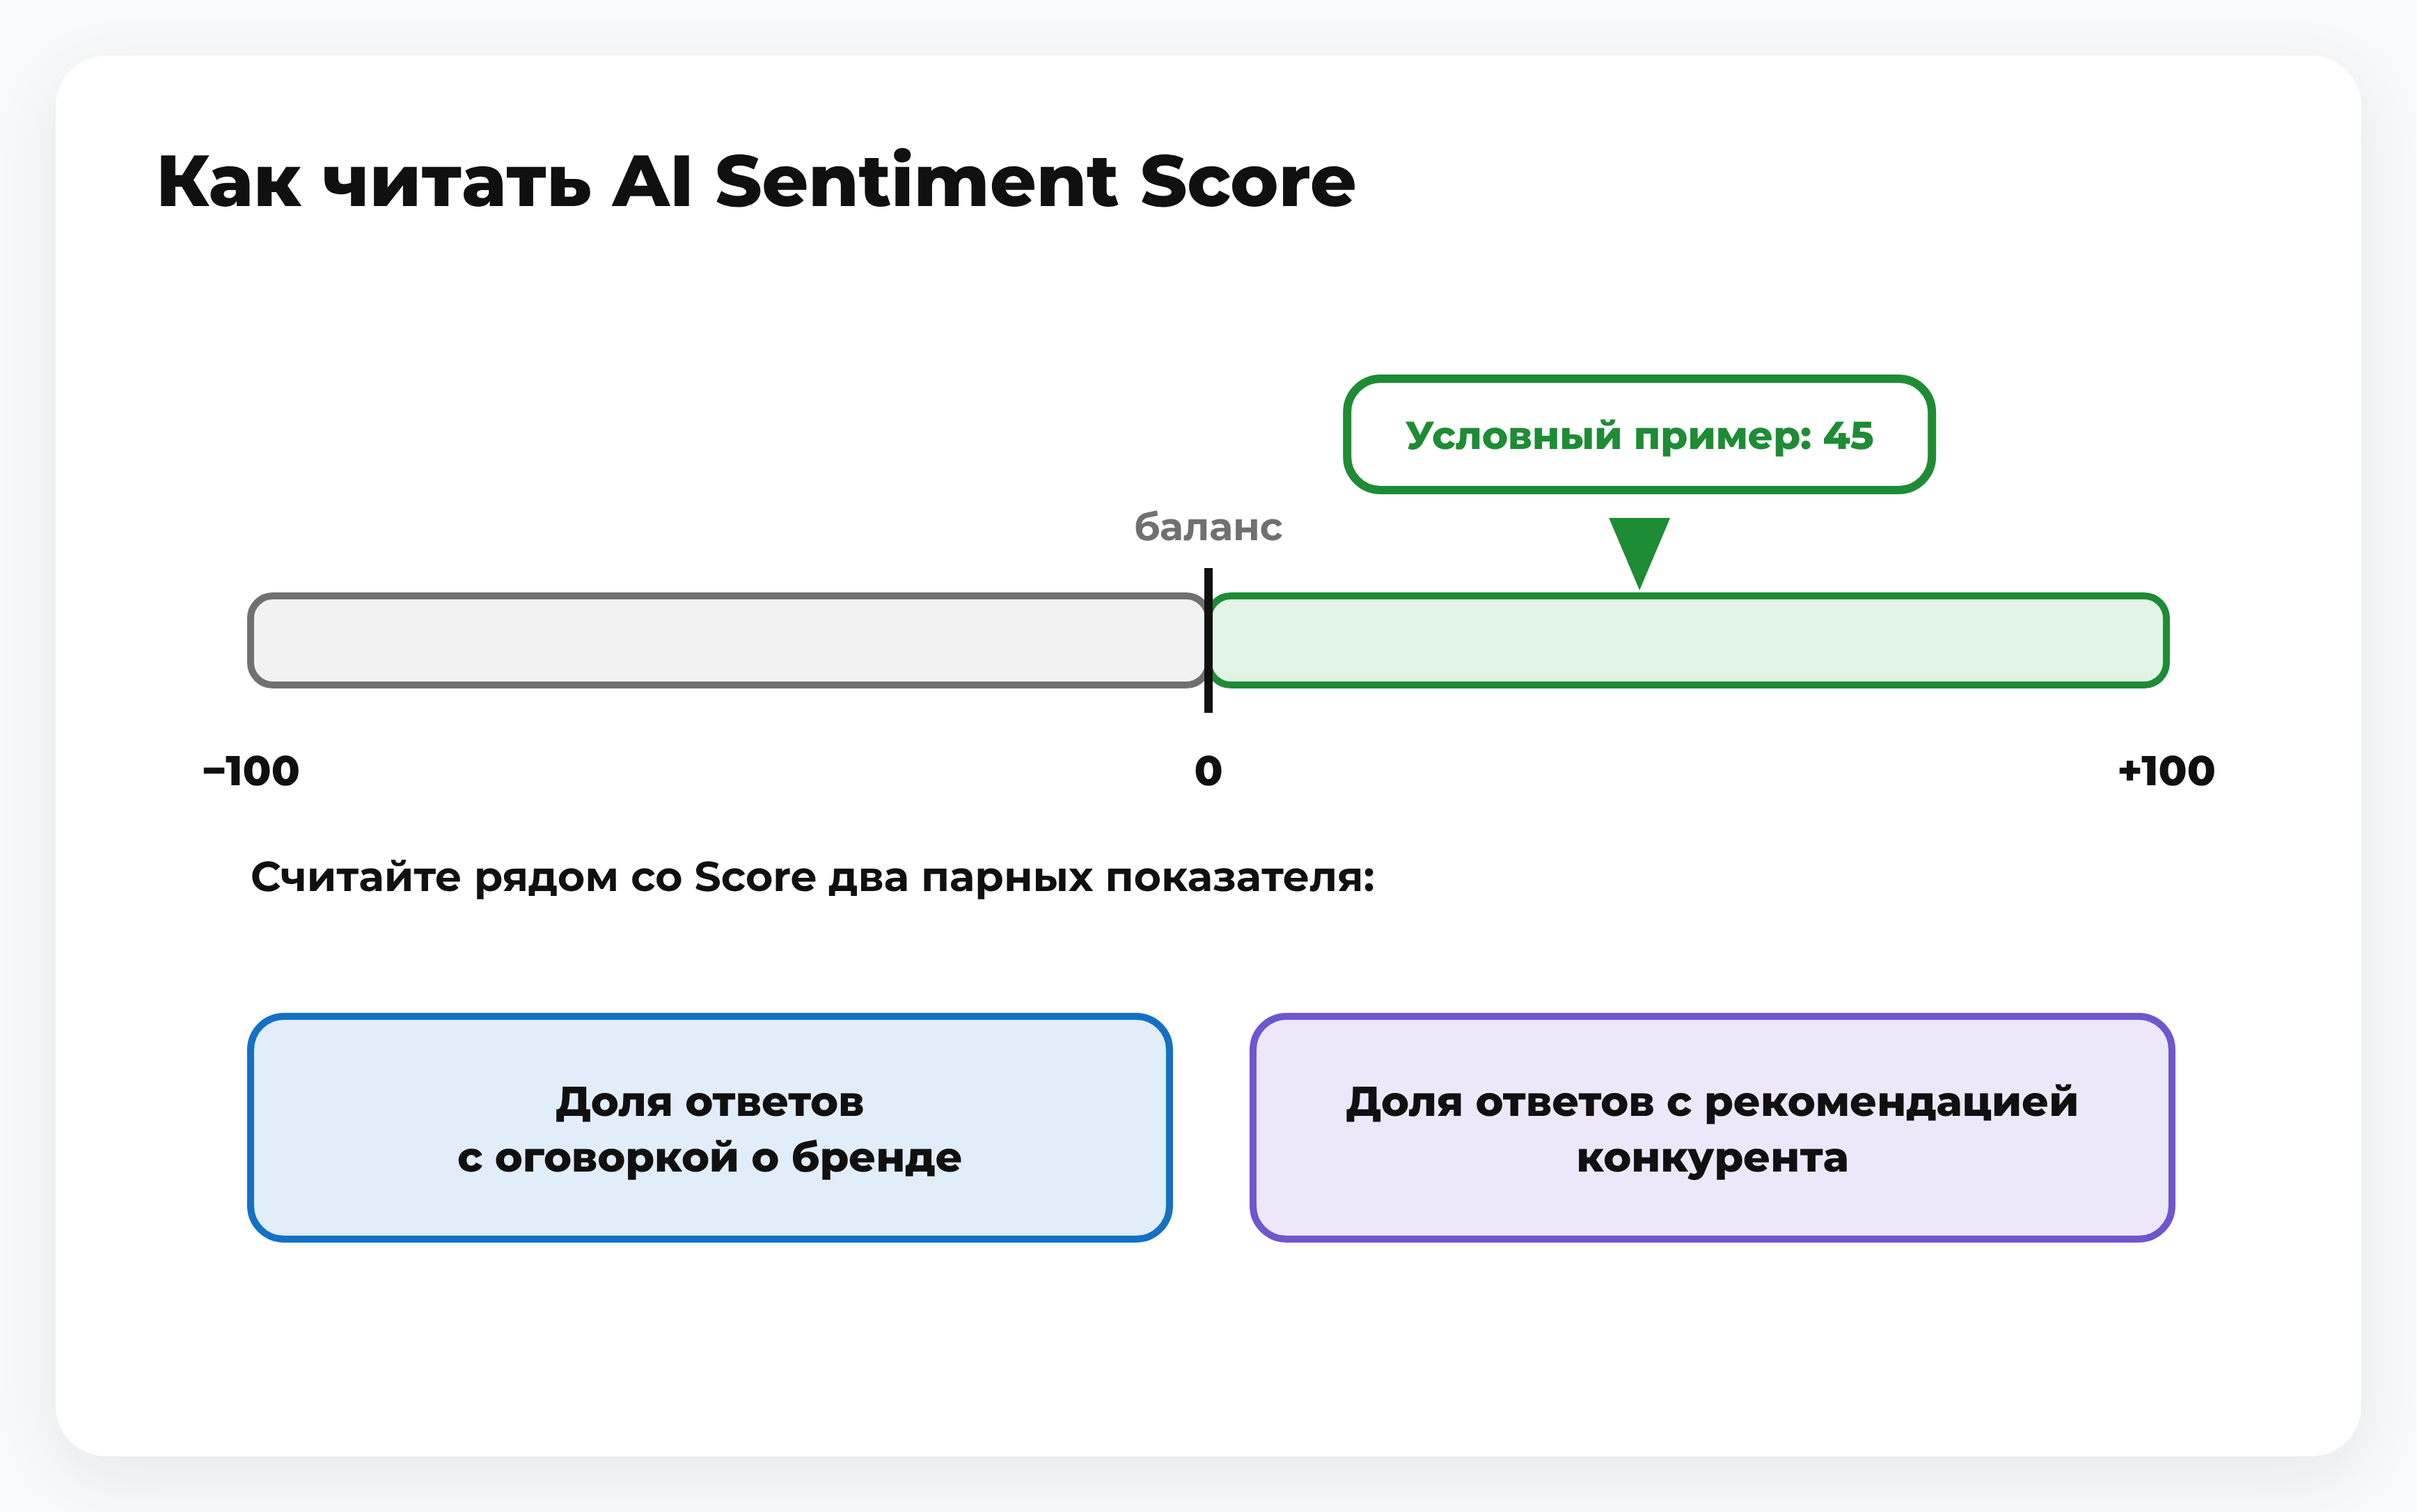
AI Sentiment Score — это индекс лояльности нейросети к бренду: доля позитивных упоминаний минус доля негативных в серии ответов. Предлагаем считать его по серии, а не по одному ответу.
Формула и условный пример расчёта
Формула учитывает ответы, где бренд упомянут и тональность определена:
Score = 100 × (P − N) / MЗдесь M — число таких ответов, P — позитивные, N — негативные; нейтральные и смешанные дают ноль. Шкала идёт от −100 до +100, ноль означает баланс. В условном примере из 40 ответов 22 позитивных, 14 нейтральных и 4 негативных, итог 100 × (22 − 4) / 40 = 45.
Одной доли негатива мало: негатив редок, а позитивная метка не гарантирует выбор бренда. Считайте рядом долю ответов с оговоркой о бренде и долю ответов с рекомендацией конкурента. С конкурентами сравнивайте по Score и доле голоса.
Перед сравнением с конкурентами проверьте, что у всех брендов один кодекс разметки и один набор запросов.
Как собрать выборку и сравнить нейросети
Соберите небрендовые, брендовые и сравнительные запросы и задавайте каждый несколько раз в новом чате без истории. Серия должна быть достаточно большой, чтобы доли не скакали: предлагаем брать не меньше нескольких десятков ответов на нейросеть. Динамику смотрите на том же наборе запросов, иначе изменение Score нельзя отнести к бренду. Как замерять упоминания, описано в статье про мониторинг бренда в нейросетях.

Влияние тональности ответов на доверие пользователей
Ответ нейросети — один из шагов проверки бренда. По опросу Anketolog.ru и Markway (2000 жителей городов-миллионников, сентябрь 2025) 35% используют нейропоиск в том числе для репутационных целей, 81% проверяют его источники, а 28% принимают ответ как окончательный. Ошибки в описании бренда подрывают доверие: по опросу Rithum (март 2026, 1046 онлайн-покупателей США и Великобритании) 58% теряют доверие или винят продавца, когда рекомендация нейросети содержит неверную информацию о продукте. Ошибка факта и негативная тональность — разные вещи.
По исследованию Burson The Credibility Paradox (2 июня 2026) ответы убедительнее, когда опираются на проверяемые факты и независимое подтверждение. Это оценка инструмента, а не опрос людей. Эти исследования описывают доверие и убедительность, а не продажи.
Добавьте замер тональности в регулярную отчётность по репутации рядом с выдачей и отзывами.
Что делать с негативом в ответах нейросетей
Определите тип проблемы по кодексу и откройте источники, на которые опирается ответ. Правьте подтверждённое: устаревшие факты на сайте и в профилях компании, ответы на отзывы, независимые публикации на нескольких площадках. Неверный ответ можно оценить в интерфейсе Google AI Overviews или Яндекс Нейро, но исправления это не гарантирует. После правок повторите тот же набор запросов.
В кейсе по продвижению сервиса доставки еды в ответах нейросетей (GEO) тональность замеряли вместе с видимостью брендов. С конца марта 2026 года агентство продвигает три бренда клиента в 29 регионах и отслеживает их позиции в ответах Алисы, Google AI и Perplexity. Тональность упоминаний на 98,55% положительная, негативных упоминаний нет, а доля первых позиций в ответах выросла у всех трёх брендов, у второго — с 1,43 до 7%. Это один проект, поэтому причинную связь работ с тональностью кейс не доказывает.
Если негатив системный, точечных правок мало: переходите к комплексному продвижению в нейросетях.

Коротко о главном
- Один ответ ничего не доказывает: тональность измеряют серией повторяемых запросов по единому кодексу.
- Тональность упоминания отличается от факта упоминания.
- AI Sentiment Score считают по формуле отдельно для каждой нейросети.
- Автоматическую разметку сверяют с ручной выборкой.
- С негативом работают от типа проблемы к источникам.
.png)
.png)


Комментарии (1)
Оставить комментарий