

ИИ-поиск Google (AI Overviews и AI Mode) может отвечать не на один запрос, а на набор связанных, которые модель формирует и отправляет параллельно. Большая языковая модель (LLM) собирает ответ из найденного, поэтому страница может попасть в ответ по подзапросу, которого никто не вводил. Для SEO это меняет единицу планирования: в работе оказывается набор задач за формулировкой.
Кластеризация семантического ядра по общим словам не подсказывает, какие вопросы стоит закрыть, а попытка закрыть каждую формулировку приводит к множеству похожих страниц. Помогает другой порядок: сначала осознанно расширить базовый запрос, затем сгруппировать подзапросы по задачам пользователя. Тогда каждый кластер получает один материал, что снижает риск страниц-двойников. Ниже метод разобран по шагам и показан на условном примере и на кейсе Kokoc.com по продвижению в нейросетях.

- Суть концепции query fan-out
- Этапы семантического расширения базового запроса
- Группировка запросов по смыслу и задачам пользователя
- Примеры применения метода на практике
- Отвечаем на вопросы об ИИ-поиске и fan-out
- Коротко о главном
Суть концепции query fan-out
Query fan-out — это набор параллельных связанных запросов, которые модель генерирует, чтобы получить больше информации и найти дополнительные релевантные результаты поиска для ответа на исходный запрос пользователя. Так определяет термин документация Google для ИИ-ответов в поиске, то есть для AI Overviews и AI Mode.
Google показывает приём на примере. Для запроса «how to fix a lawn that's full of weeds» (как исправить газон, заросший сорняками) подзапросы могут включать три направления. Это иллюстрация Google, а не фактический перечень подзапросов.
- «best herbicides for lawns» (лучшие гербициды);
- «remove weeds without chemicals» (удаление без химии);
- «how to prevent weeds in lawn» (профилактика).
О приёме query fan-out Google заявил при запуске AI Mode в 2025 году: система запускает несколько связанных поисков параллельно по подтемам и источникам данных и объединяет результаты в один ответ. По документации, приём могут использовать и AI Overviews, и AI Mode, поэтому набор поддерживающих ссылок шире, чем в классическом поиске. Наборы ответов и ссылок у двух функций различаются.
Чем fan-out отличается от длинного запроса
Расширение запроса и синонимы превращают одну формулировку в близкие формулировки той же задачи. Длинный запрос пользователь вводит сам. Query fan-out создаёт модель, и его подзапросы часто относятся к разным подтемам ответа.
Возьмём задачу выбрать кофемашину для офиса. Расширение даст «офисная кофемашина», длинный запрос пользователь запишет как «какую кофемашину купить для офиса». Модель может разложить задачу на запросы про сравнение моделей, обслуживание и отзывы.
Почему fan-out важен для SEO и контента
Страница может появиться в ответе по подзапросу, которого пользователь не вводил, поэтому покрывать нужно грани темы. Это расширяет охват: сайт видят в ответах и по смежным вопросам. Чтобы страница участвовала, она должна быть проиндексирована и допущена к показу в Google Search со сниппетом, то есть соответствовать техническим требованиям поиска.
Задачу за запросом описывает интент запроса, а оптимизацию сайта под ответы генеративных систем называют GEO (generative engine optimization) и AEO (answer engine optimization). Для планирования контента это значит выяснять, какие задачи читателя скрыты за базовой формулировкой.
Число подзапросов зависит от системы. В анализе Peec за 1–21 апреля 2026 года изучили 5 млн fan-out-запросов из ChatGPT, Perplexity и Grok, в основном из ChatGPT: на один промпт, то есть запрос к нейросети, в среднем приходилось 1,4 подзапроса у Perplexity, 2,1 у ChatGPT и 6,8 у Grok. Это наблюдения одного вендорского исследования за три недели. Поэтому фиксированное число подзапросов в планировании закладывать не стоит.
Этапы семантического расширения базового запроса
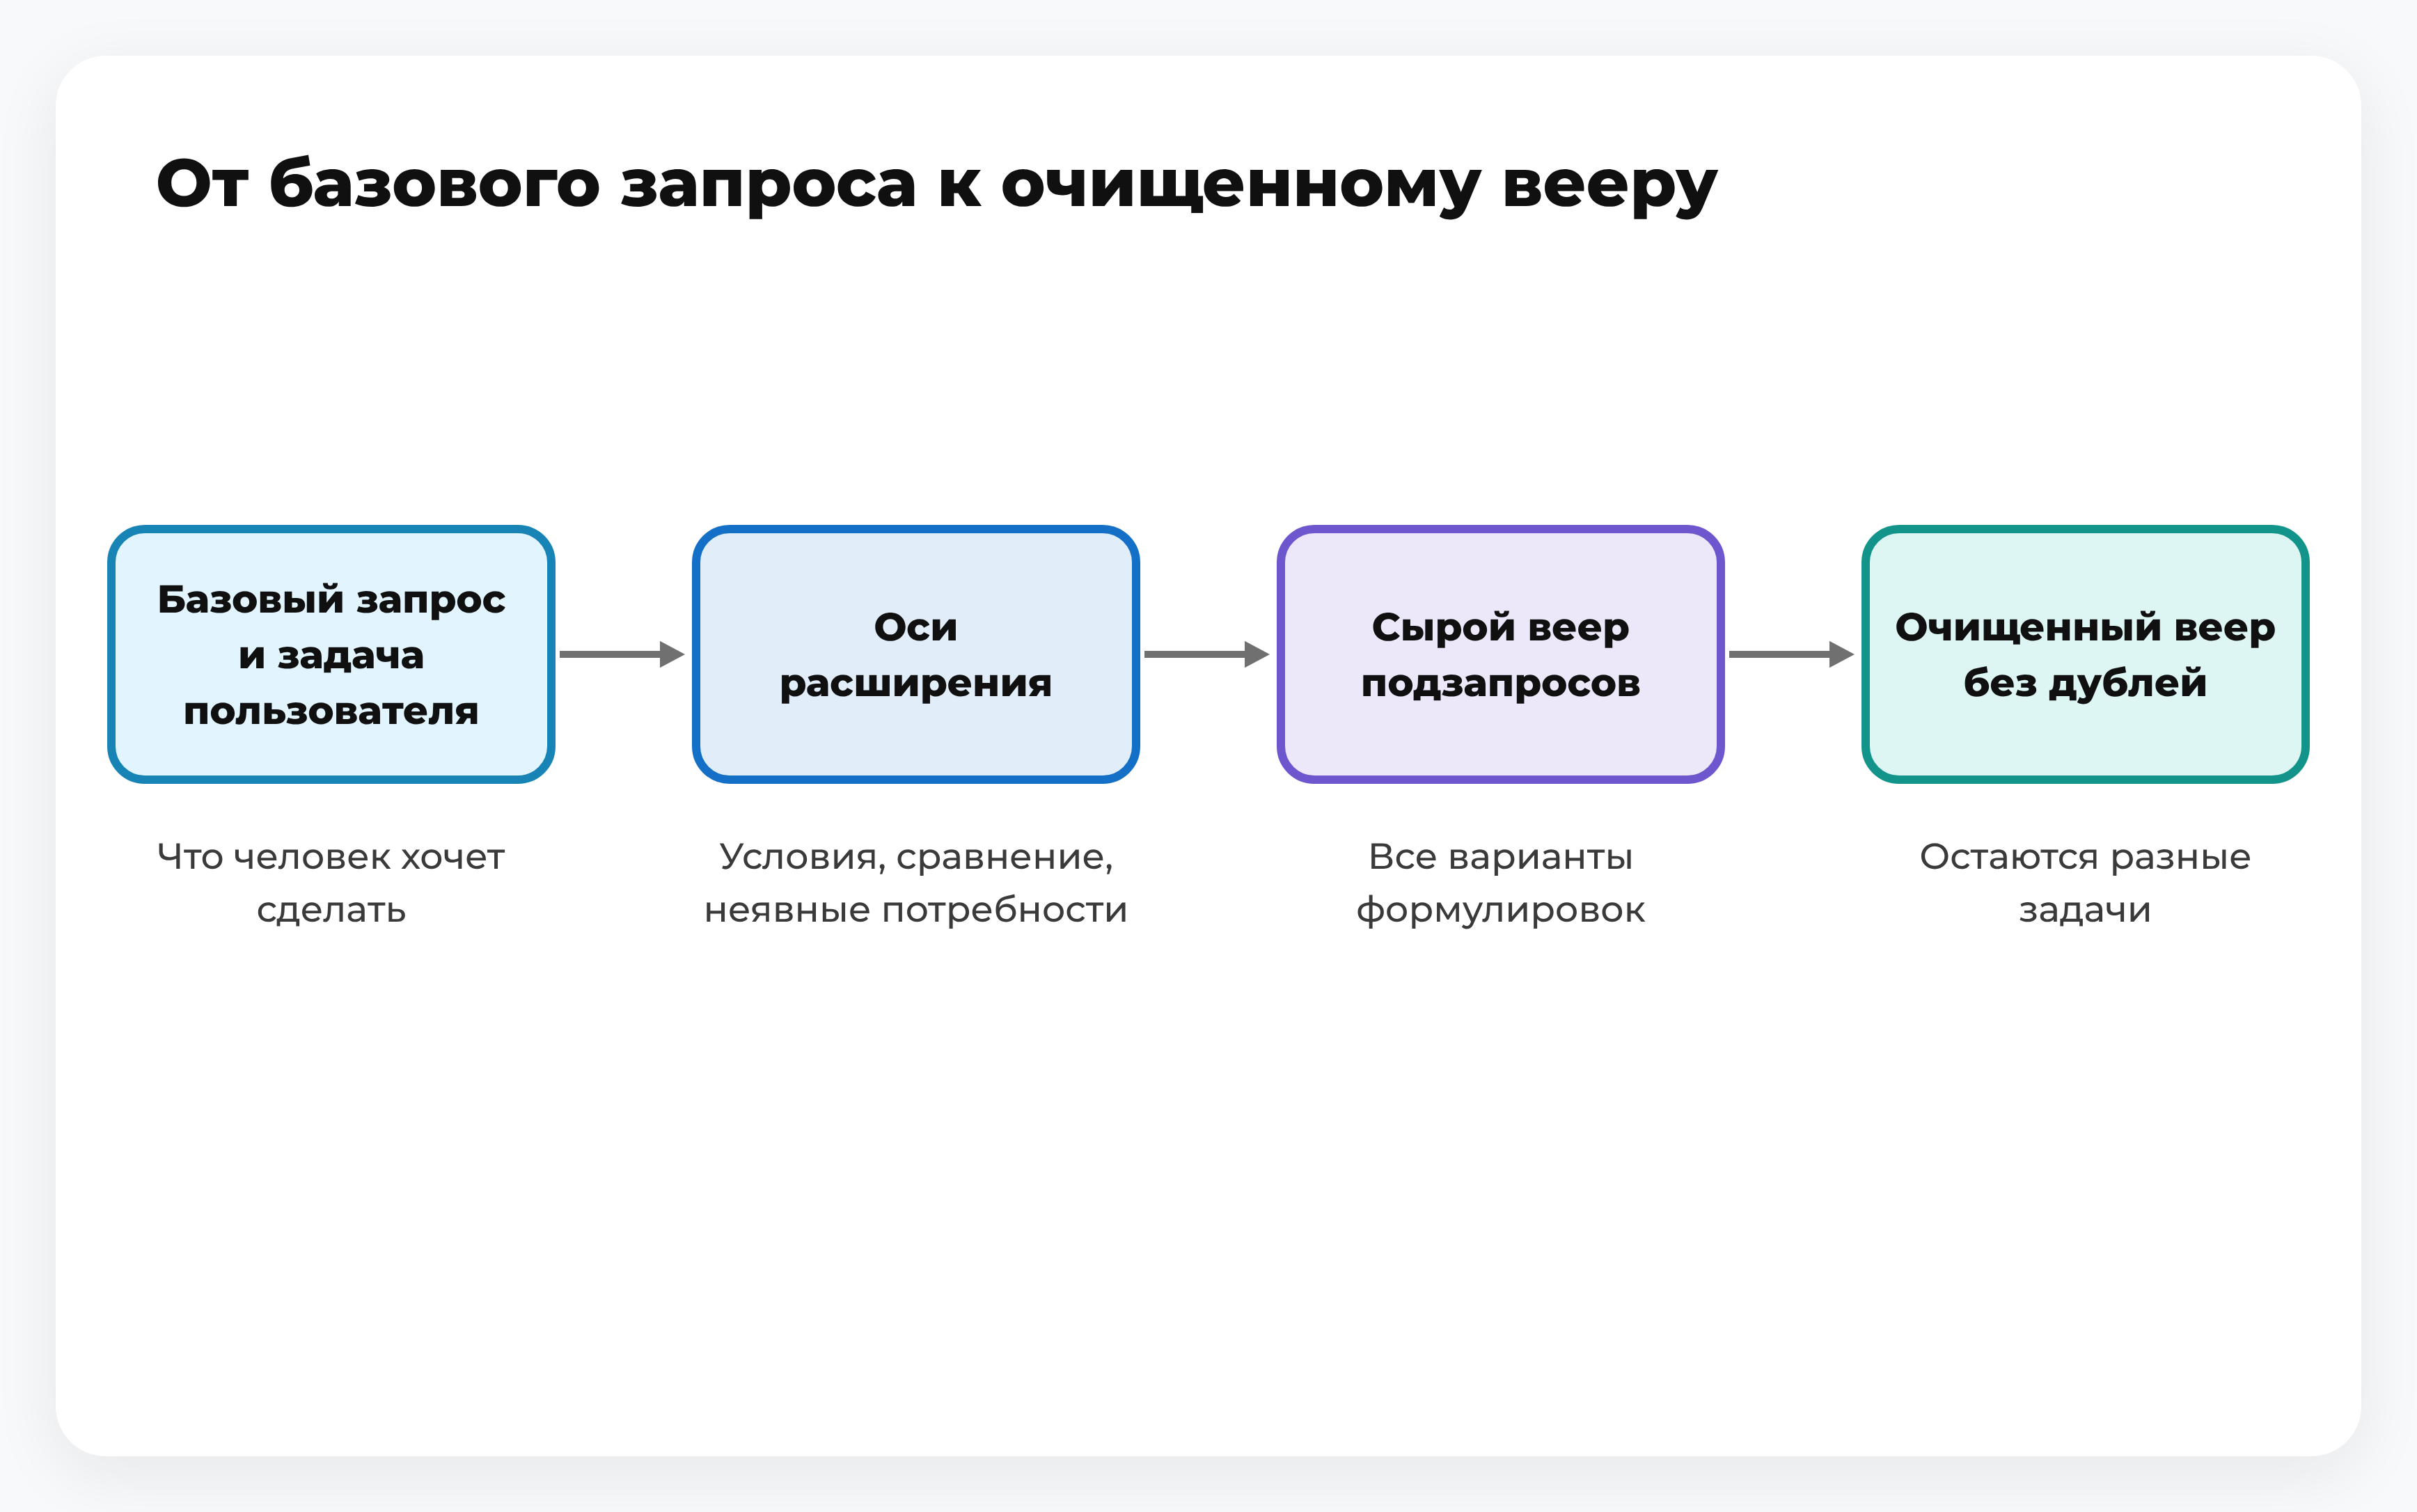
Шаг 1. Зафиксируйте базовый запрос и задачу пользователя за ним. Запишите формулировку, по которой хотите появляться в ответах, и одной фразой опишите, что человек хочет понять, сравнить, выбрать или сделать.
Шаг 2. Разверните запрос по осям расширения. Ось задаёт направление, в котором запрос растёт. Google в примере про газон добавляет уточнение условий и профилактику, а Peec показал, что ChatGPT чаще всего подмешивает слова best, top, comparison, reviews, tools, software и features и в 5,44% промптов добавляет текущий год. Эти данные получены на ChatGPT, поэтому для русскоязычных запросов оси стоит проверять на собственных промптах.
| Ось расширения | Что добавляет в веер | Пример |
|---|---|---|
| Уточнение условий | Ограничения и параметры исходной задачи | remove weeds without chemicals (Google) |
| Сравнение и альтернативы | Выбор среди вариантов, обзоры | «Which Samsung Galaxy should I get?» превращается в best Samsung Galaxy phones comparison 2026 (Peec) |
| Неявные потребности | То, что читатель спросит дальше | how to prevent weeds in lawn (Google) |
| Свежесть и регион | Актуальность и локальные условия | текущий год в подзапросах ChatGPT (Peec) |
| Сущности и форматы | Продукты, функции, форматы | Instagram story hashtags, Instagram reel hashtags (Surfer SEO) |
| Переформулировки | Та же задача другими словами | «офисная кофемашина» и «кофемашина для офиса» (условный пример) |
Шаг 3. Соберите веер и объедините дубли. Выпишите все подзапросы в одну таблицу и склейте формулировки с одним смыслом. Для этого шага достаточно очистить список от повторов, группировка идёт после него.
Материал для веера дают вопросы клиентов в продажах и поддержке, подсказки и связанные вопросы в выдаче, ответы нейросетей на базовый запрос и гипотезы ИИ. Гипотезы ИИ нужно сверять с выдачей, прежде чем включать их в веер. Для первого сбора пригодится сбор семантики через ChatGPT.
Закрывать веер целиком не нужно. В исследовании Surfer SEO, где провели 1600 прогонов на Gemini как заместителе AI Overviews и AI Mode, лишь около 27% ключей fan-out сохранялись от запуска к запуску, а 66% появились ровно один раз. Это замер на Gemini, а не на самих продуктах Google. Поэтому в работу берут темы и задачи, которые стоят за подзапросами.

Подзапросы при этом остаются близкими к исходному: по данным Surfer SEO, модель чаще расширяет введённое пользователем, чем уходит в посторонние углы. К запросу о хештегах в Instagram, например, относились подзапросы про Instagram story hashtags и Instagram reel hashtags. Поэтому веер строится вокруг исходной задачи.
Чтобы проверить, не ушёл ли подзапрос в сторону, сверьте его с задачей «выбрать подрядчика для ремонта ванной»: вопрос про приёмку работ в ней остаётся, а запрос про обои в коридоре уже за её пределами.
Группировка запросов по смыслу и задачам пользователя
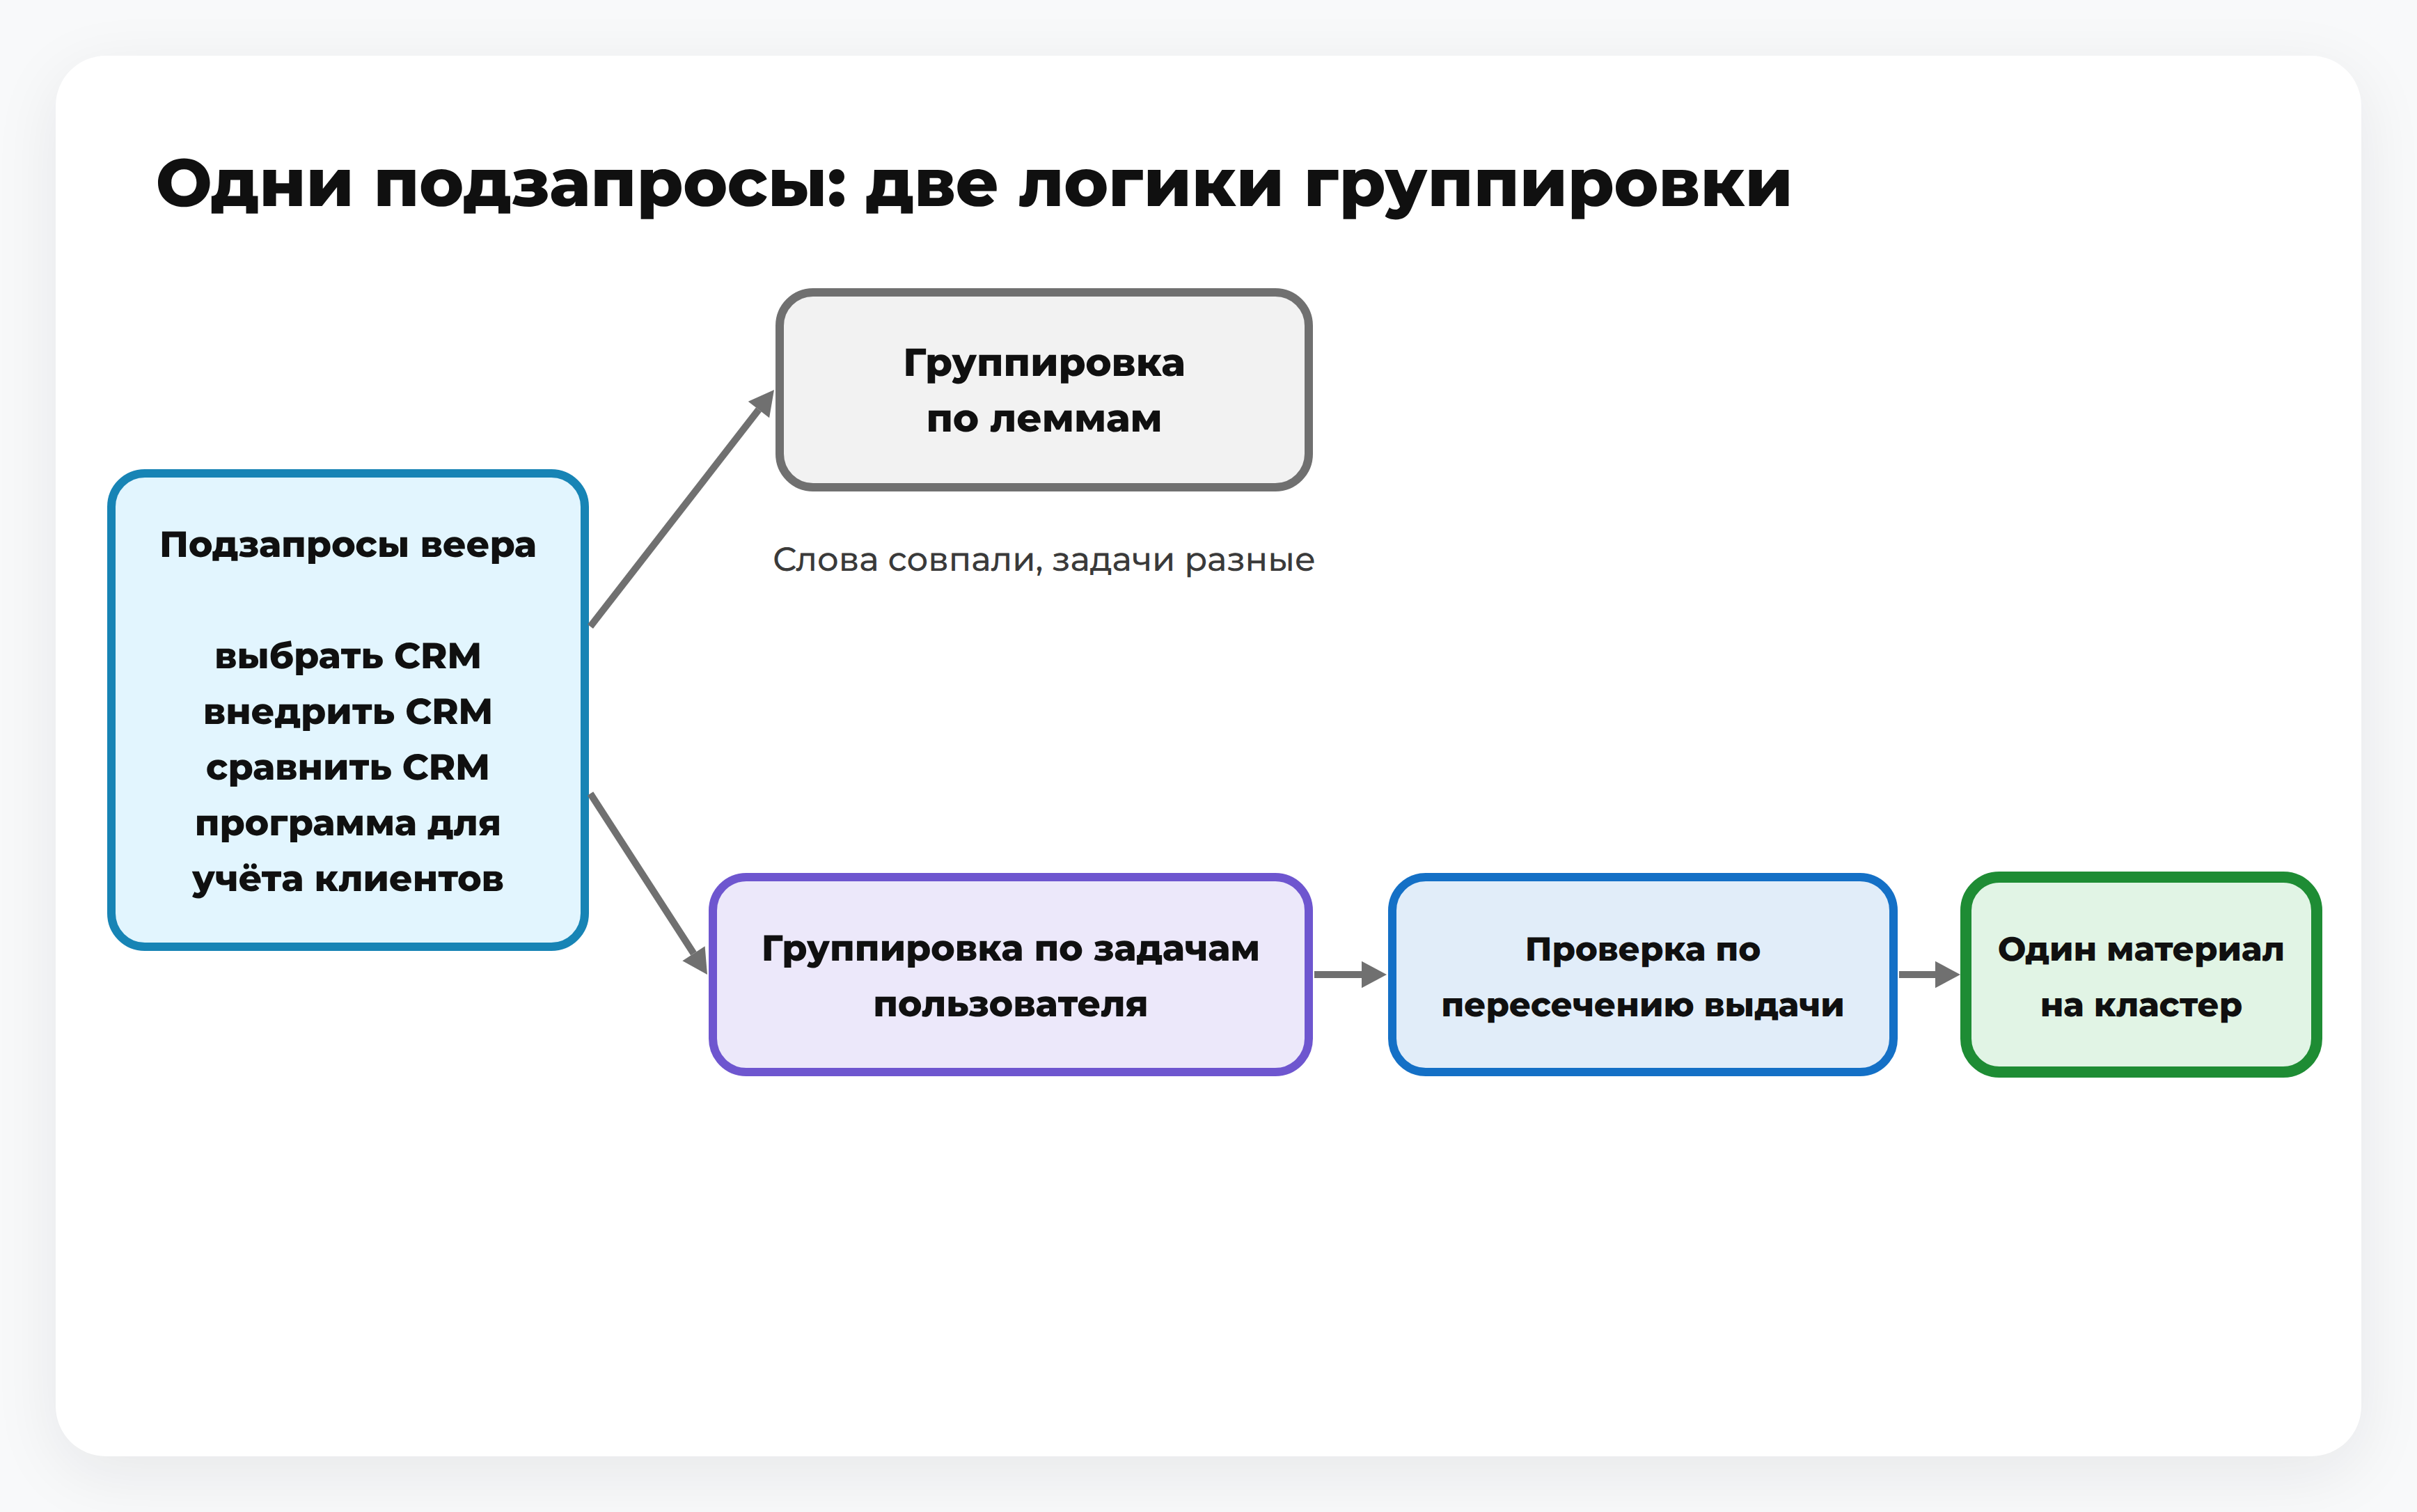
Запросы относятся к одной группе, если за ними стоит одна задача пользователя, будь то понять, сравнить, выбрать или сделать, и на неё отвечает один материал или один раздел. Общих слов и лемм для этого недостаточно: лемма — это начальная форма слова, и по совпадению лемм запросы склеивают при логической кластеризации. Разные слова при той же задаче объединяются в одну группу.
Почему леммы не подходят
Возьмём две пары запросов про CRM (систему учёта клиентов). «Выбрать CRM для отдела продаж» и «внедрить CRM для отдела продаж» делят леммы, но решают разные задачи: в первом случае человек сравнивает системы, во втором планирует запуск. «Сравнить CRM-системы» и «какая программа для учёта клиентов лучше» не делят ни одной леммы, но за обоими стоит выбор системы, и ответить на них может один обзор. Группировка по ключевым словам склеит первую пару и разведёт вторую, а группировка по задачам сделает наоборот.
Эту логику поддерживает документация Google: системы понимают синонимы и общий смысл запроса и могут связать пользователя с контентом без тех же слов, поэтому собирать все long-tail-вариации не нужно. Технику кластеризации ядра разбирает полный гайд по кластеризации семантического ядра.
Как проверить группы по выдаче
Проверка по выдаче показывает, правильно ли объединены запросы. Подзапросы, у которых в выдаче совпадают страницы, скорее относятся к одной группе: Surfer SEO называет такие запросы соседними. Если у двух запросов разные задачи и разные страницы в выдаче, их разносят по разным группам. Порог пересечения подбирают под нишу, универсального значения у него нет.
По данным Surfer SEO, 84% fan-out-запросов оказались соседними для исходного запроса, а около 90% удалось разделить максимум на 4 кластера. Исследователи советуют работать на уровне кластеров и больших тем. Число кластеров относится к выборке Surfer и нормой не служит.
Один кластер или страница на каждый подзапрос
Страница под каждый подзапрос ведёт к страницам-двойникам. По руководству Google по оптимизации под ИИ-функции, отдельный контент под каждую вариацию запроса, включая fan-out-запросы, ради манипуляции выдачей или ИИ-ответами нарушает политику против scaled content abuse, то есть массового создания страниц. Большое число страниц не делает сайт качественнее, а ограничитель «primarily to manipulate» оставляет место отдельной странице под самостоятельный вопрос аудитории.
На практике кластер раскрывается одним материалом с разделами под отдельные задачи. Для каждого кластера зафиксируйте задачу пользователя, существующий или новый материал и формат ответа: раздел, таблицу или отдельную статью. Так группы связываются с контентом сайта.
Сомневаетесь, нужна ли отдельная страница, задайте один вопрос: решает ли этот запрос самостоятельную задачу читателя? Если нет, он остаётся разделом внутри кластера.
Примеры применения метода на практике
Условный пример: компания предлагает ремонт ванных комнат под ключ, базовый запрос — «ремонт ванной комнаты под ключ», задача пользователя — «выбрать подрядчика и понять, из чего складывается ремонт». По осям запрос раскрывается в веер: условия («ремонт ванной в панельном доме»), сравнение («под ключ или по этапам»), неявные потребности («как принимать работы»), свежесть и регион («материалы и сроки в Москве») и сущности («сантехника, плитка, гидроизоляция»). После склейки дублей веер группируется по задачам: понять, из чего состоит ремонт; выбрать формат работы и подрядчика; подготовиться к приёмке. На каждую группу приходится свой материал.
| Что планируется | Как проверяется | |
|---|---|---|
| Было: формулировки как отдельные цели | Страница под каждую формулировку веера, в итоге несколько похожих материалов | По совпадению слов в заголовках и тексте |
| Стало: группы по задачам | Три материала: руководство по составу и этапам ремонта, сравнение форматов работы с критериями выбора подрядчика, чек-лист приёмки | По пересечению выдачи для спорных пар и по присутствию бренда в ответах нейросетей |
Кейс Kokoc с пулом промптов и кластерами
Группировку по задачам иллюстрирует GEO-кейс Kokoc.com для компании из сферы корпоративного обучения; имя клиента закрыто соглашением о неразглашении. Пул из 37 целевых промптов формировали из услуг и приоритетов клиента, вопросов при выборе корпоративного обучения, ответов нейросетей, коммерческой ценности сценария, спроса и вероятности, что запрос вызовет рекомендацию конкретных компаний. Промпты сгруппировали в шесть тематических кластеров по бизнес-задаче.
| Тематический кластер | Промптов |
|---|---|
| Корпоративное обучение и бизнес-тренинги | 10 |
| Переговоры | 7 |
| B2B-продажи, KAM (key account management, работа с ключевыми клиентами) и сложные сделки | 6 |
| Лидерство и управление | 6 |
| Стратегические сессии и фасилитация | 5 |
| Бизнес-тренеры и эксперты | 3 |
| Итого | 37 |
Видимость бренда в ответах нейросетей по этому пулу выросла с 0,83% (замер 17 апреля 2026 года) до 42,79% через два месяца активных работ с 4 июня по 5 августа 2026 года, то есть на 41,96 процентного пункта. Целевой показатель не менее 30% за три месяца был превышен через два месяца, а к 5 августа бренд занял второе место с отставанием от лидера на 0,49 процентного пункта. На каждый промпт приходилось по три публикации, по одной на VC.ru, «Дзене» и TenChat, всего 111.
Показатель относится к пулу из 37 промптов за два месяца. Связь с публикациями наблюдаемая: страница кейса называет внешний информационный контур основным реализованным фактором, с которым связана динамика. Видимость в генеративных системах нестатична и требует регулярного контроля. Для бизнеса это значит, что продвижение сайта в нейросетях опирается на пул промптов, сгруппированный в кластеры по бизнес-задаче клиента.
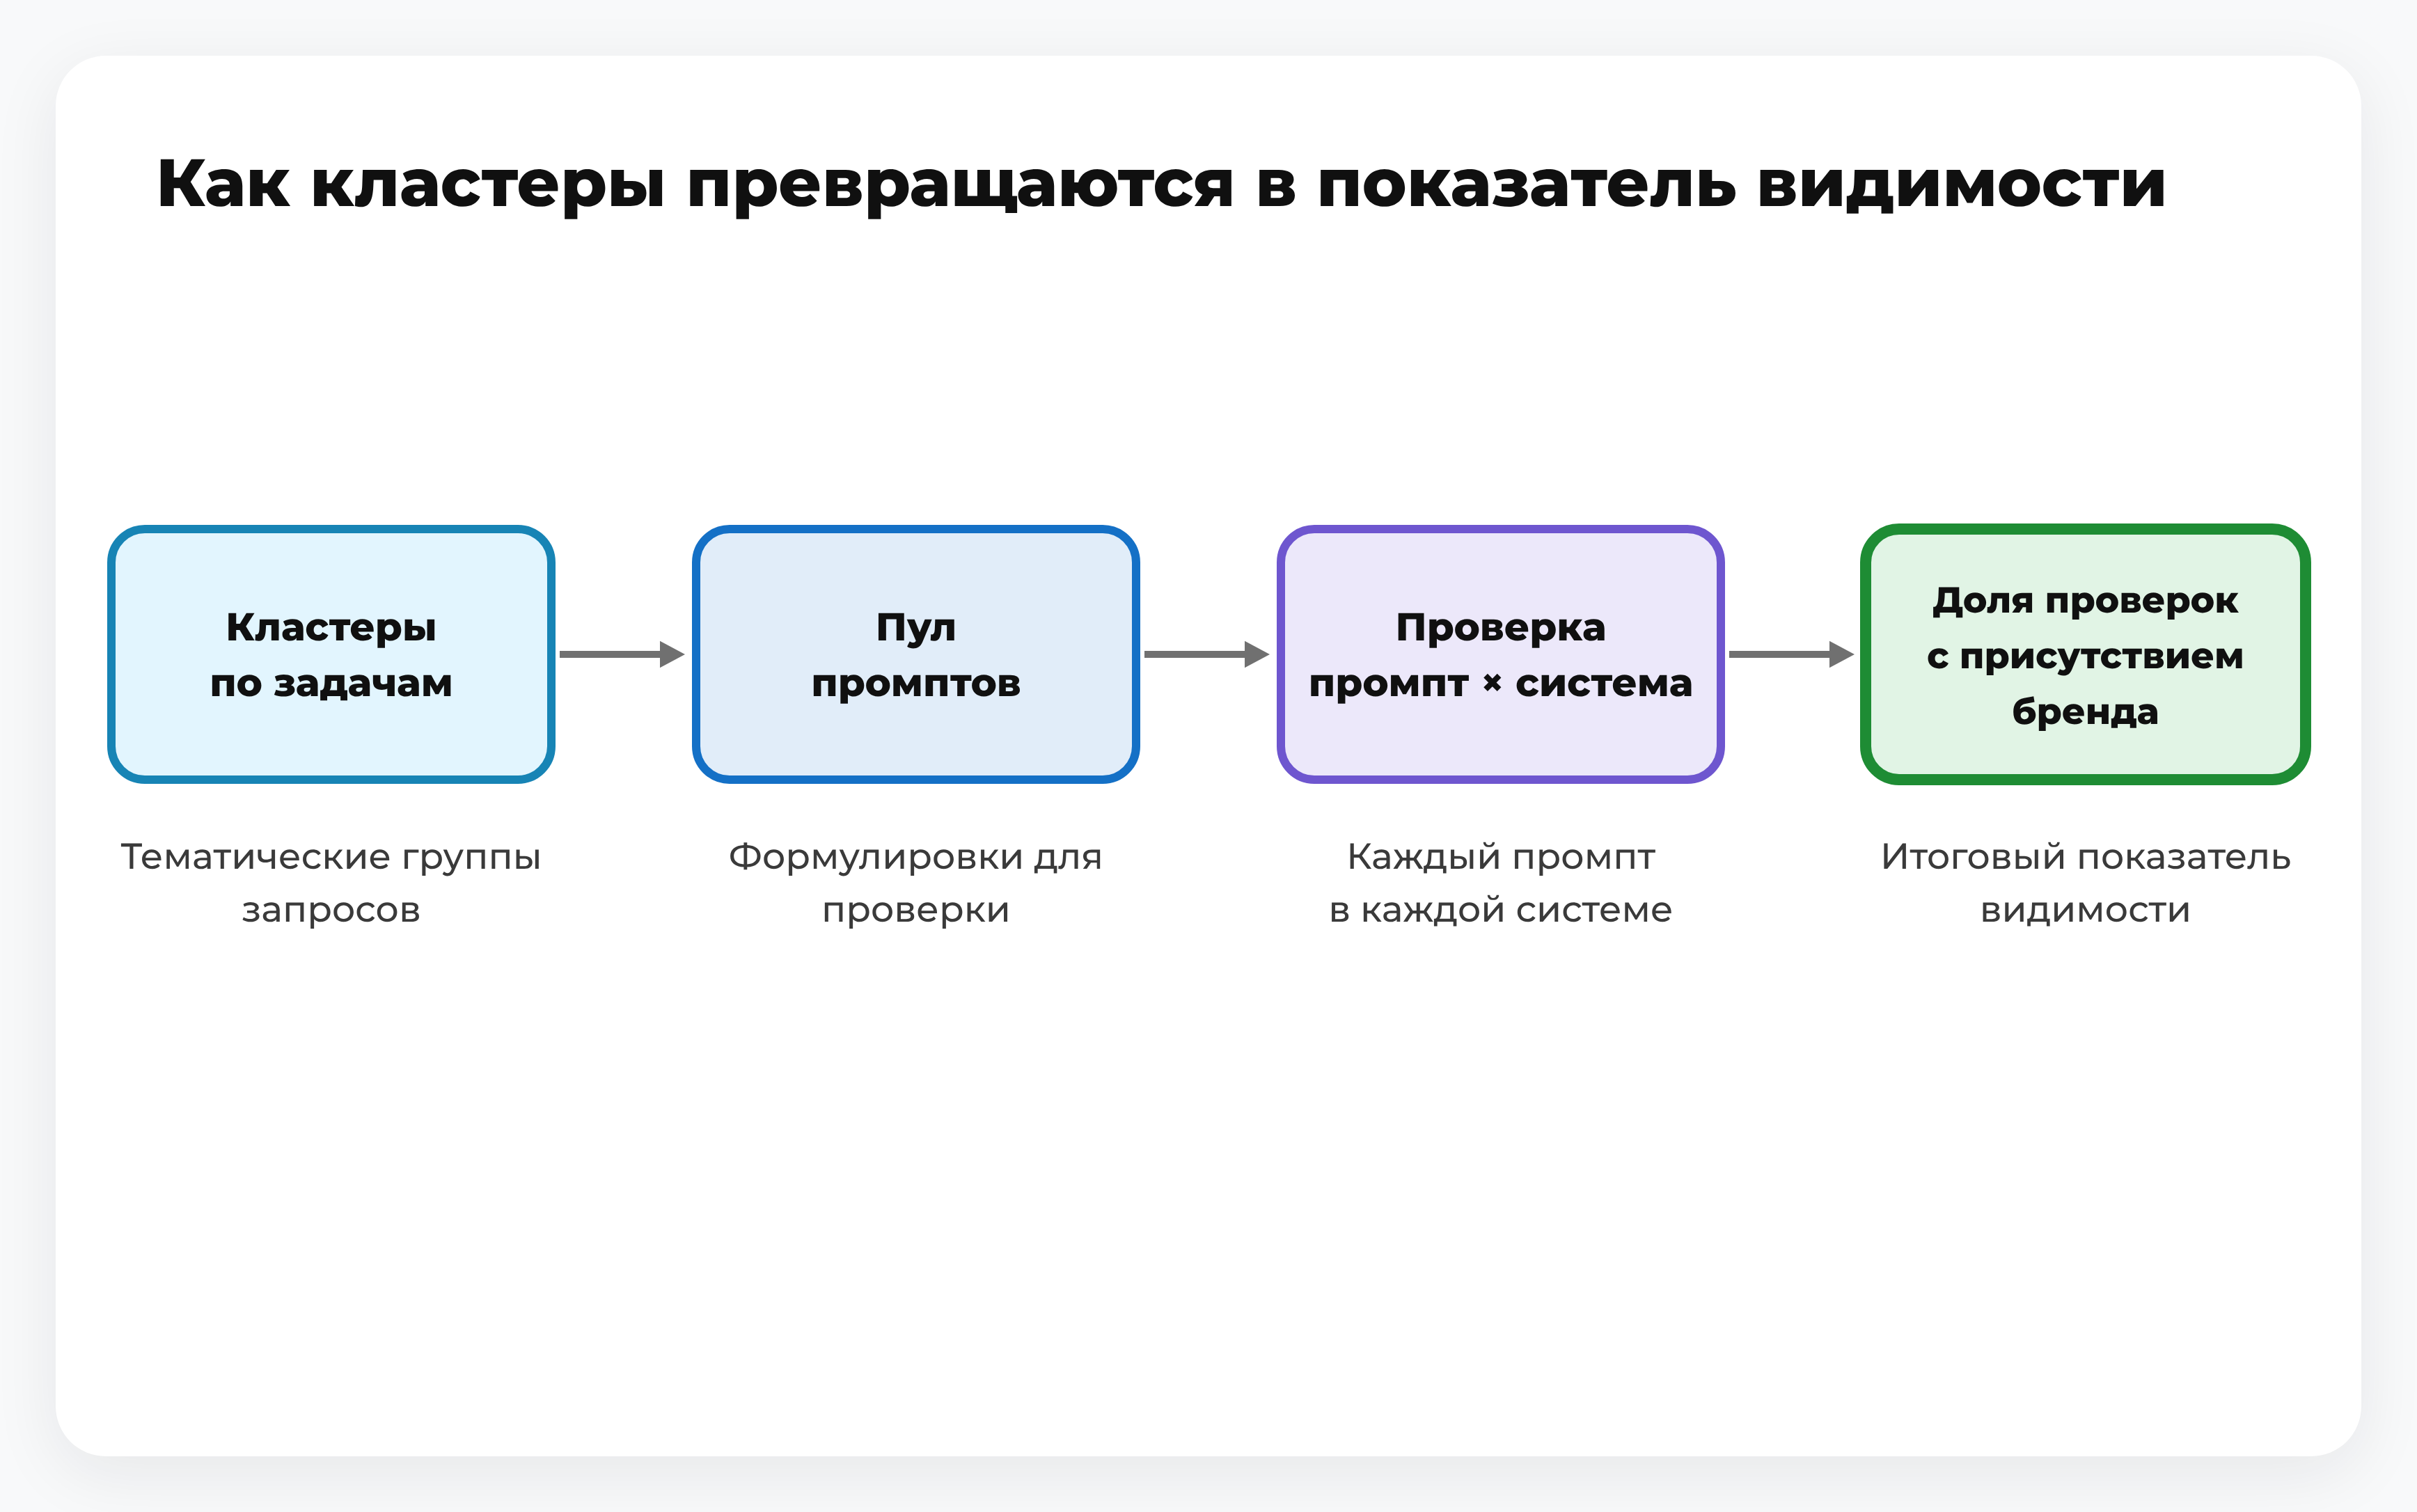
Измерение строится на проверках «промпт × система»: видимость — это доля проверок, в которых бренд присутствует в ответе. В кейсе 37 промптов проверяли в шести системах, среди которых Поиск с Алисой, Google AI Overviews, ChatGPT и Perplexity, поэтому база одного замера составила 222 проверки.
Отвечаем на вопросы об ИИ-поиске и fan-out
Нужно ли разбивать контент на фрагменты и вести llms.txt?
Для Google Search нет. По документации Google, требования разбивать контент на мелкие части не существует: системы понимают несколько тем на странице и показывают нужный фрагмент, а идеальной длины страницы нет. Файлы llms.txt и специальную разметку для ИИ поиск Google не использует, а переписывать текст специально для генеративного поиска не нужно.
Работает ли это так же в Яндексе?
В справке Яндекса «Алиса AI в Поиске» принцип описан так: Алиса AI анализирует запрос, изучает релевантные страницы из Поиска и готовит структурированный ответ со ссылками на источники. По справке Вебмастера, Алиса AI может разбить запрос на подвопросы и обращается с уточнёнными запросами к Поиску, но термин query fan-out не использует, а число и состав подзапросов не раскрывает. Поэтому выводы исследований по ChatGPT или Google не стоит переносить на Яндекс без проверки.
Где смотреть трафик из AI-ответов Google?
Трафик из AI Overviews и AI Mode входит в общий поисковый трафик Search Console и отражается в отчёте «Эффективность» по типу поиска «Веб». Для оценки присутствия в генеративных функциях Google рекомендует отдельный отчёт Generative AI performance в Search Console, который показывает работу контента в Google Search и Discover.
Коротко о главном
Метод query fan-out сводится к пяти положениям.
- Query fan-out — это набор связанных запросов, которые модель генерирует для ответа на исходный, поэтому страница может попасть в ответ по подзапросу, которого пользователь не вводил.
- Базовый запрос расширяют по осям от задачи пользователя и очищают веер от дублей, а работают с темами, потому что веер нестабилен.
- Подзапросы группируют по задаче и намерению пользователя, а не по общим леммам, и проверяют спорные пары по пересечению выдачи.
- Один кластер получает один материал: страницы под каждый подзапрос ведут к двойникам и рискам по политике Google.
- Присутствие в ответах нейросетей измеряют по пулу промптов как долю проверок «промпт × система» с брендом в ответе.
.png)
.png)


Комментарии (1)
Оставить комментарий