

В ответе нейросети нет позиции и клика: бренд либо назван, либо нет. Привычные метрики поиска это не показывают, поэтому присутствие в ИИ приходится считать иначе. Бизнесу нужен простой ответ: упоминают ли нас ChatGPT, Алиса или Google AI Overviews и как мы выглядим на фоне конкурентов.
В сервисах мониторинга встречаются Share of Voice (SoV) и Mention Rate, и разницу между ними объясняют не всегда. Позиция бренда в ответе ненадёжна, поэтому видимость считают долями ответов и упоминаний на фиксированном наборе промптов с повторными прогонами. Дальше разберём обе метрики, формулы и порядок замера, чтобы вы могли самостоятельно посчитать долю голоса своего бренда.
- Что такое Share of Voice и Mention Rate в эпоху ИИ
- Почему классический SEO-подход не работает для LLM
- Формула расчёта SoV и Mention Rate в ответах нейросетей
- Сбор семантики и промптов для оценки доли голоса
- Что считается хорошим показателем и как читать результат
- Замер видимости на реальном проекте
- Частые вопросы о доле голоса в ИИ
- Коротко о главном
Что такое Share of Voice и Mention Rate в эпоху ИИ
Share of Voice (SoV) в ответах нейросетей — это доля упоминаний бренда среди всех упоминаний брендов в категории; так формулирует метрику Semrush.
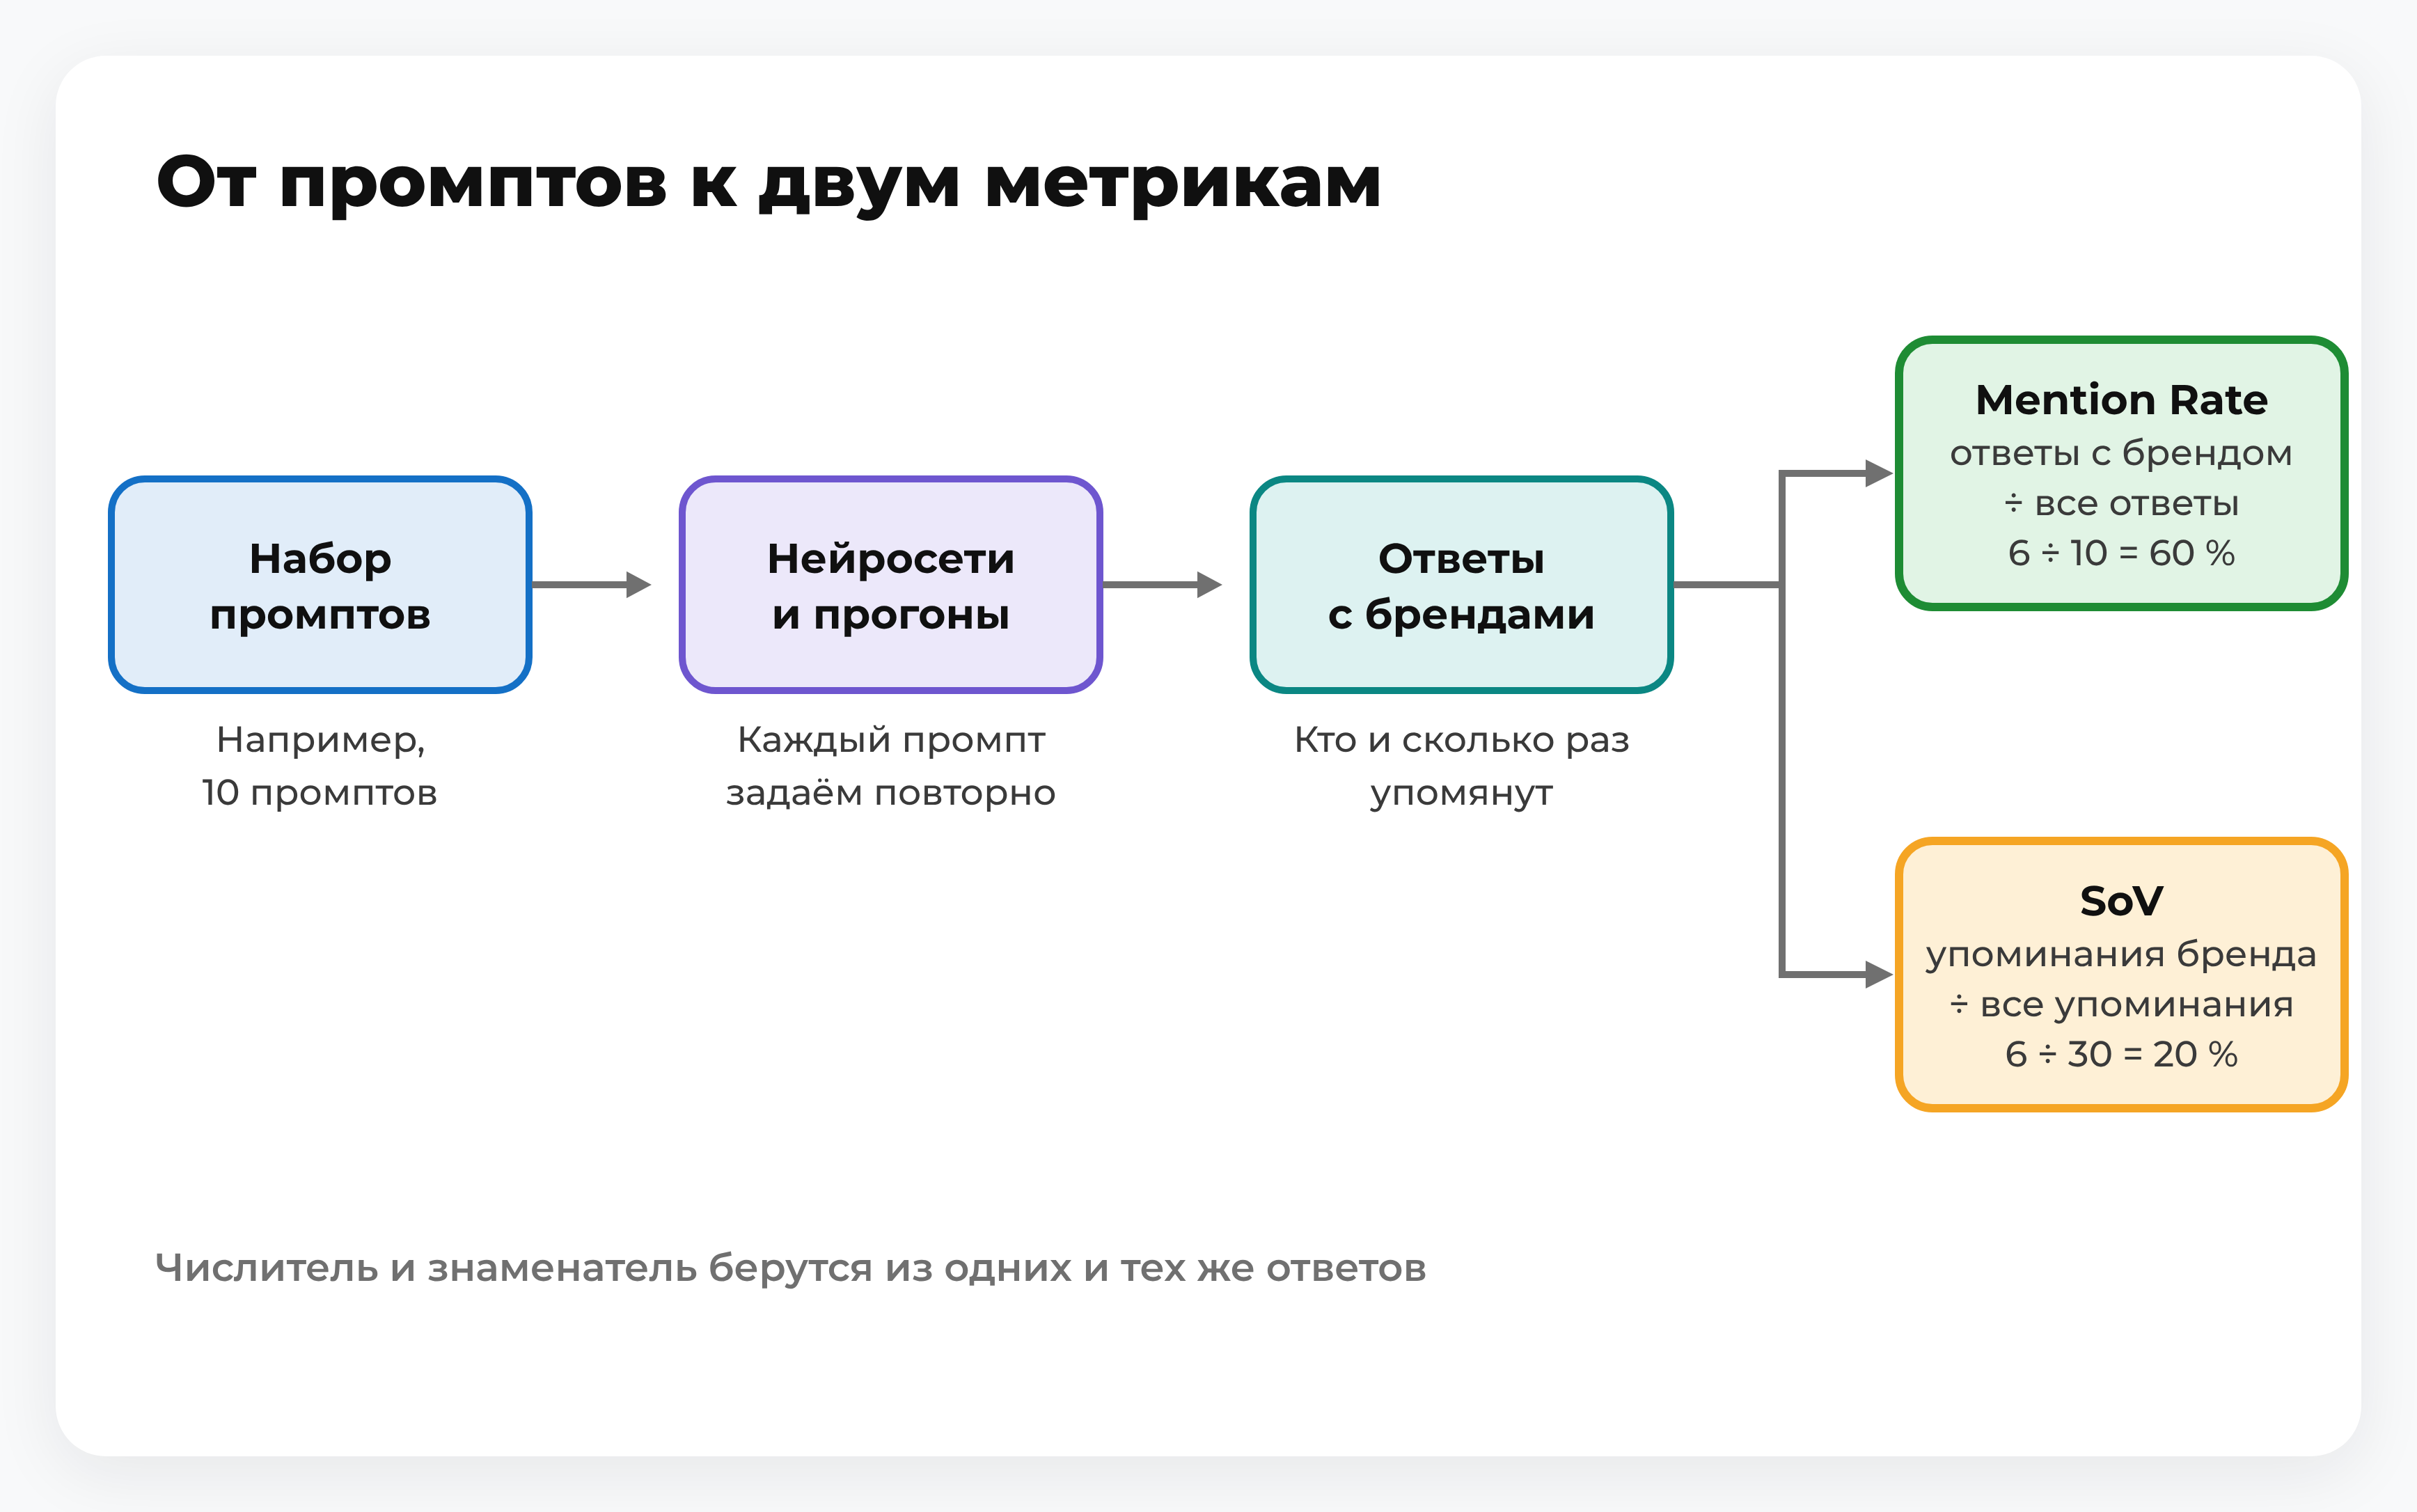
Mention Rate — это доля ответов нейросети, в которых бренд назван хотя бы раз. Единого отраслевого названия у такого подсчёта нет, мы используем Mention Rate.
SoV показывает, насколько бренд заметен на фоне конкурентов, а Mention Rate отвечает, попадает ли он в ответы вообще. Обе метрики считают на одном наборе ответов, и расхождение между ними подсказывает, где искать причину: например, высокий Mention Rate при скромном SoV.
Промпт — это вопрос или задача, которую пользователь вводит в нейросеть: ChatGPT, Алису, Perplexity или нейросеть в поиске Google, то есть AI Overviews. Показатель «видимость» (AI visibility) сервисы считают по-разному: в исследовании SparkToro и в кейсе ниже это доля ответов с брендом, то есть он ближе к Mention Rate. Для бизнеса метрики дают сравнение присутствия с конкурентами в сценариях, где клиент выбирает решение.
Почему классический SEO-подход не работает для LLM
LLM (large language model, большая языковая модель) — это нейросеть, которая формирует текстовый ответ на запрос пользователя. Классический SEO share of voice по Semrush — доля оценочного органического трафика по набору ключей: если по ним набирается 100 000 кликов в месяц, а сайт получает 6 000, его доля составляет 6 %. В рекламе SoV означает долю присутствия бренда среди конкурентов. У ИИ-SoV другие единицы и данные: вместо кликов и позиций считаются упоминания.
| Признак | Классический SoV | ИИ-SoV |
|---|---|---|
| Что измеряет | Долю оценочного органического трафика по набору ключей | Долю упоминаний бренда среди упоминаний всех брендов |
| Единица данных | Клик, позиция в выдаче | Ответ нейросети, названный бренд |
| Есть ли позиция | Да, сайт ранжируется | По умолчанию нет: бренд назван или не назван |
| Стабильность результата | Оценка трафика по заданным ключам не меняется от запуска к запуску, в отличие от списков брендов в ответах нейросети | Один и тот же промпт часто даёт разные списки брендов, нужны повторные прогоны |
В ответе нейросети по умолчанию нет ни позиции, ни ссылки, поэтому важен контекст упоминания: в каком сценарии, рядом с какими конкурентами и с какой оценкой назван бренд. Если пользователь получил ответ без перехода на сайт, клики тоже ничего не покажут.
Исследование SparkToro за январь 2026 года показало, насколько ответы нестабильны. 600 добровольцев прогнали 12 запросов через ChatGPT, Claude и Google AI, всего получилось 2 961 прогон. Один и тот же список брендов ChatGPT и Google AI выдавали менее чем в 1 случае из 100, а в том же порядке — менее чем в 1 из 1 000. Запросы были брендовыми рекомендациями на рынке США, русскоязычные нейросети не проверялись. Значит, разовая проверка и позиция бренда в ответе ничего не доказывают, а нужна доля по набору промптов.
Рядом с каждой цифрой указывайте набор промптов, нейросеть и число прогонов: без этого два замера нельзя сравнивать.
Формула расчёта SoV и Mention Rate в ответах нейросетей
Единого отраслевого стандарта расчёта нет, поэтому SoV считаем по описанию Semrush, а Mention Rate как долю ответов с брендом. Формулы для самостоятельного расчёта:
SoV = упоминания бренда / сумма упоминаний всех брендов × 100 %
Mention Rate = ответы с брендом / все проверенные ответы × 100 %
Замер проходит в пять шагов:
- Соберите пул промптов по целевым темам.
- Составьте список брендов и конкурентов с вариантами написания.
- Прогоните каждый промпт несколько раз в каждой нейросети.
- Отметьте бренды в каждом полученном ответе.
- Посчитайте обе метрики по каждой нейросети и группе промптов.
Каждую нейросеть и каждую группу промптов считают отдельно, а сводная цифра остаётся справочной. Системы по-разному опираются на веб-индекс и данные обучения, поэтому общая доля скрывает расхождения.
Что считать упоминанием бренда
Один ответ даёт бренду одно упоминание, сколько бы раз он ни был назван внутри: так повторы в длинном ответе не завышают долю. Повторный прогон того же промпта считается отдельным ответом.
Варианты названия, то есть транслитерацию, сокращения и название продукта вместо бренда, выпишите заранее вместе с конкурентами. Список фиксируется до замера. Бренды, которых вы не ждали, но которые назвала нейросеть, добавляйте в расчёт как новых участников. Тональность на подсчёт не влияет: её оценивают отдельно.

Пример расчёта на десяти ответах
Возьмём условный пример: 10 промптов, по одному ответу на каждый. Ваш бренд назван в 6 ответах, а всего в ответах названо 30 брендов, то есть в среднем по 3 на ответ. Эти цифры показывают метод, они не данные рынка и не норма.
| Бренд | Упоминания | Mention Rate | SoV |
|---|---|---|---|
| Ваш бренд | 6 | 60 % | 20 % |
| Конкурент А | 9 | 90 % | 30 % |
| Конкурент Б | 8 | 80 % | 26,7 % |
| Конкурент В | 7 | 70 % | 23,3 % |
| Всего | 30 | 100 % |
У одного бренда получилось 60 % и 20 %, потому что метрики делят одно и то же присутствие на разные величины. Mention Rate равен 6 / 10 × 100 = 60 % и не зависит от числа конкурентов в ответе. SoV равен 6 / 30 × 100 = 20 %: те же 6 упоминаний делятся на все 30. Поэтому бренд назван в большинстве ответов, но по доле остаётся последним в таблице.
Сбор семантики и промптов для оценки доли голоса
Промпты берите из реальных формулировок пользователей. Отправная точка — семантическое ядро сайта: ключевые запросы переписывают в вопросы, которые человек задал бы нейросети. Сырьё для формулировок дают отчёт «Мониторинг поисковых запросов» в Яндекс Вебмастере, отчёт об эффективности в Search Console, обращения в поддержку и вопросы отдела продаж. Это запросы классического поиска, поэтому они годятся как основа тем и формулировок, но не как готовый список промптов. Подход к сбору разобран в статье о сборе семантики через ChatGPT.
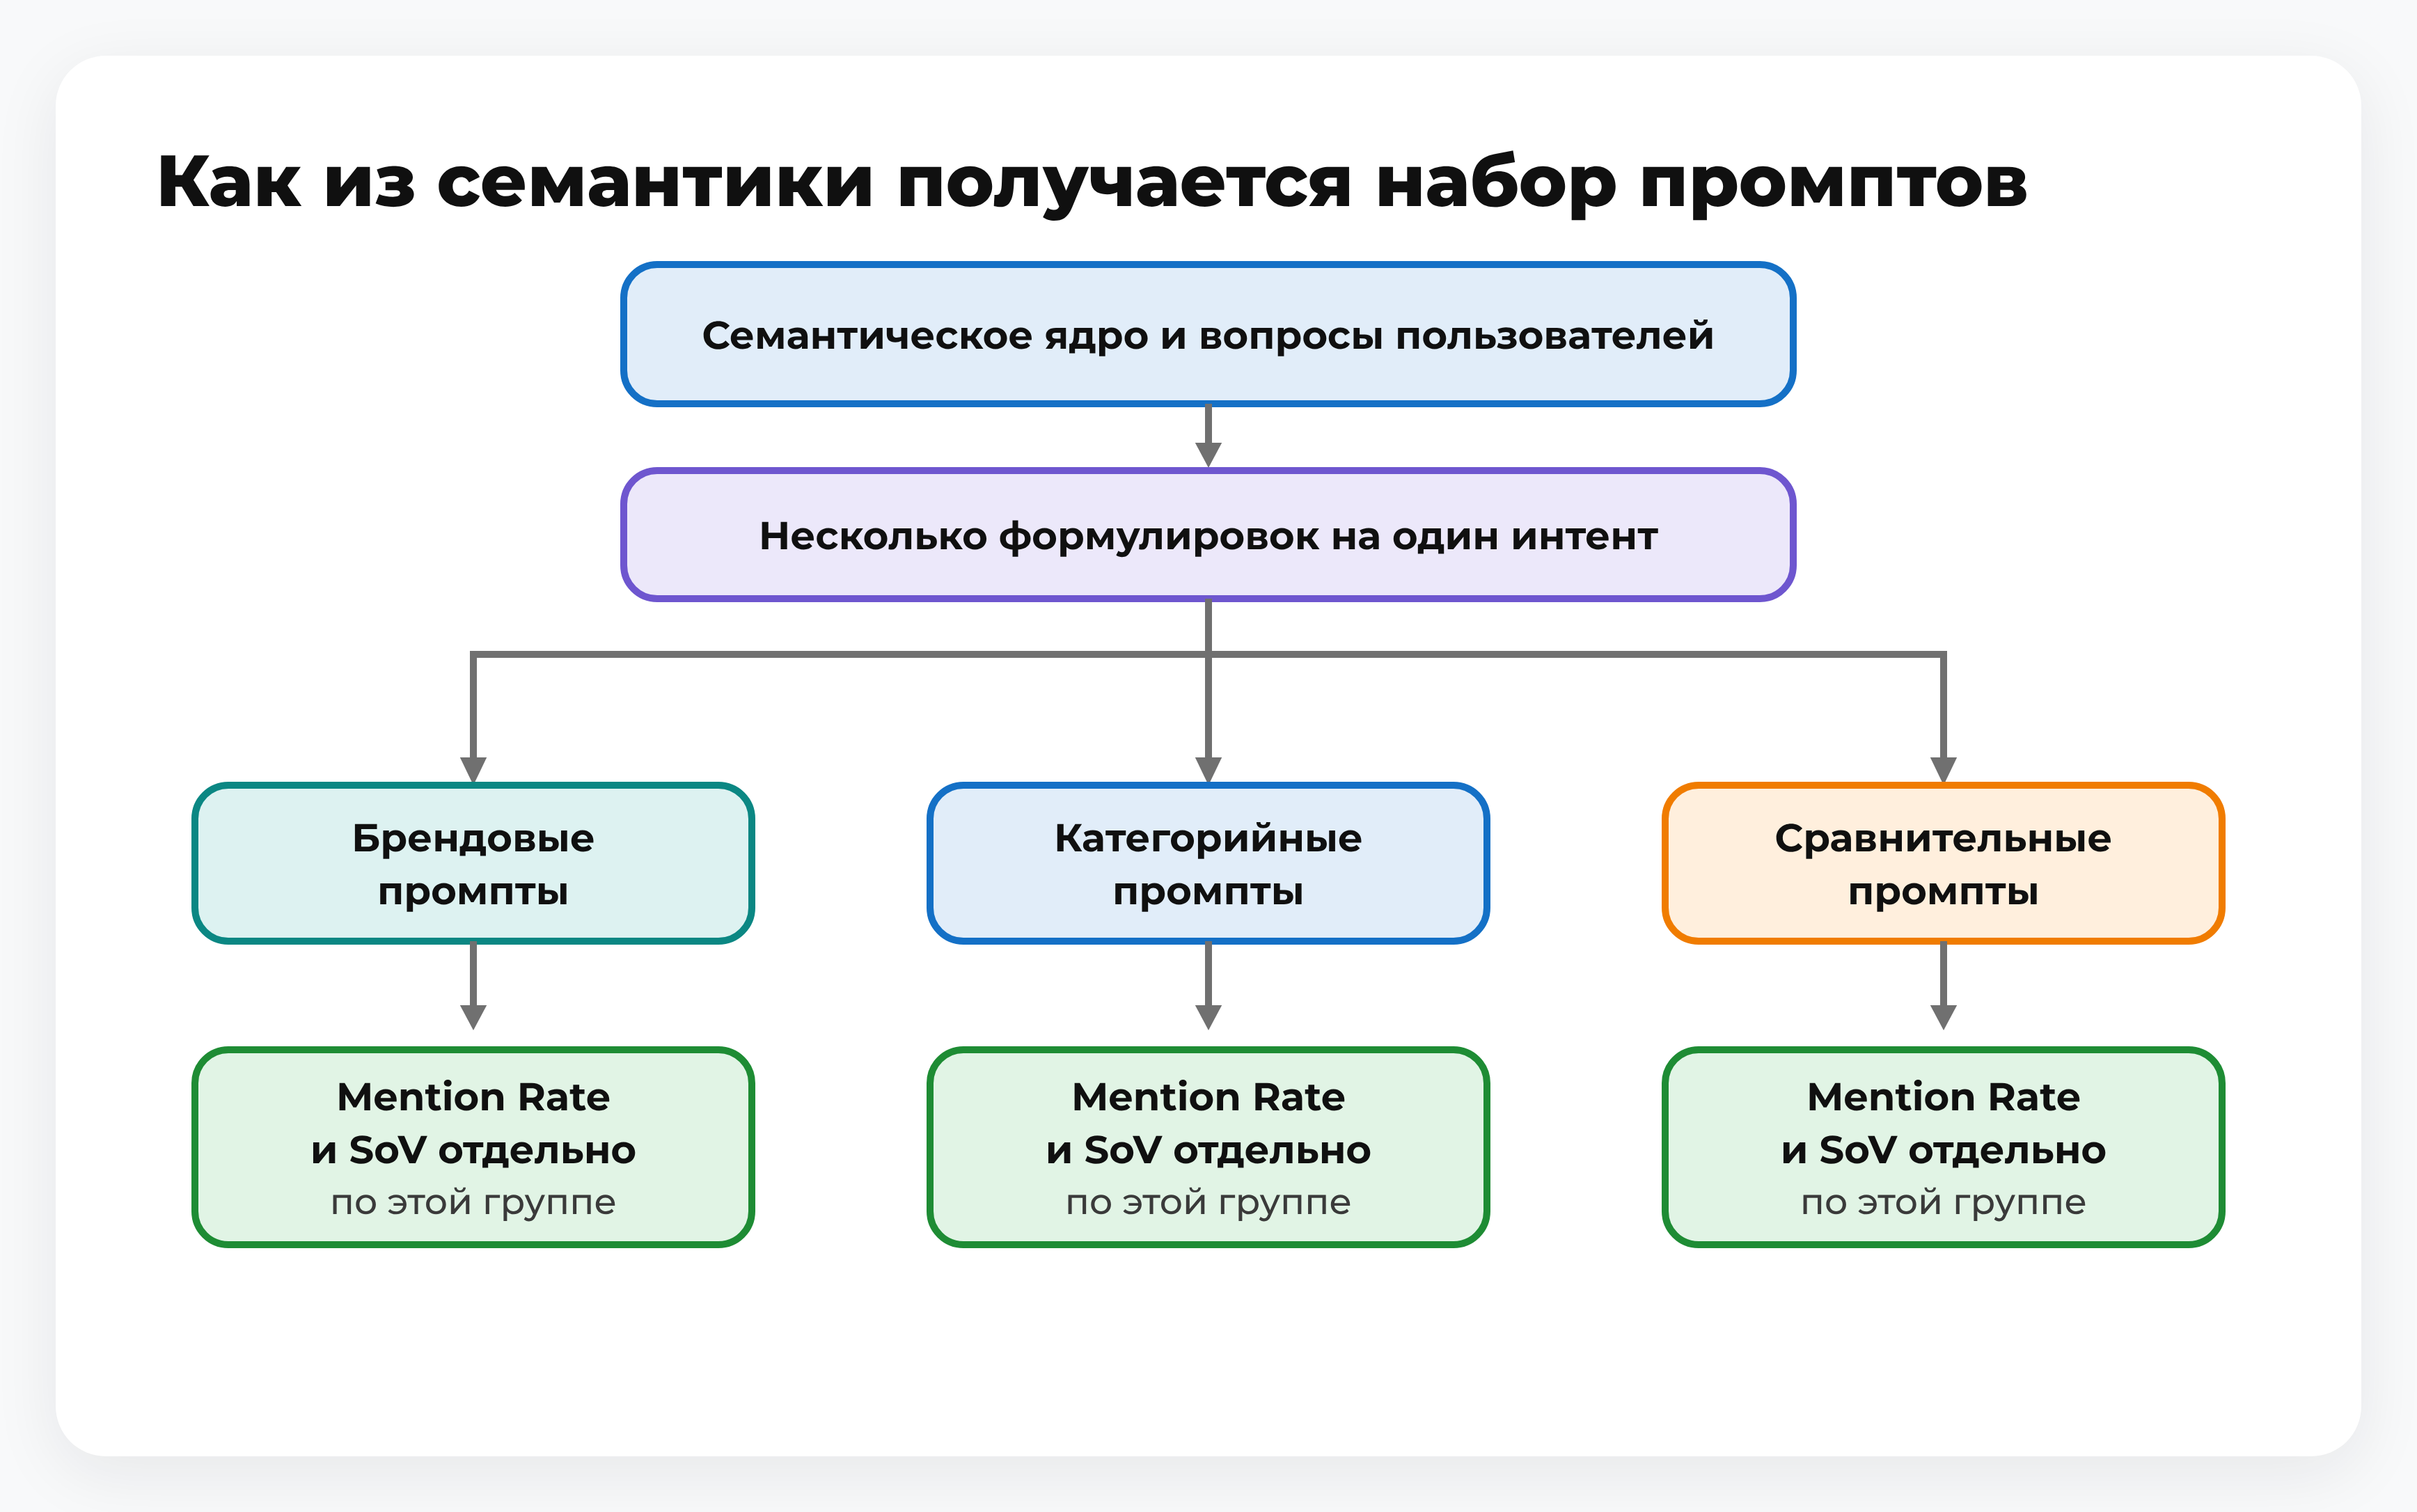
Один интент пользователи формулируют по-разному. В исследовании SparkToro семантическое сходство 142 промптов про наушники, которые написали участники опроса, составило 0,081, но Bose, Sony, Sennheiser и Apple встречались в 55–77 % из 994 ответов. Значит, на каждый интент нужно несколько формулировок. Промпты делят на группы: брендовые, категорийные (небрендовые) и сравнительные. Метрики считают по каждой группе отдельно, а небрендовые промпты показывают видимость там, где клиент бренд ещё не знает. Набор промптов и список конкурентов фиксируют на время замера: изменение набора создаёт новую точку отсчёта, и сравнивать её с прежней динамикой нельзя.
Сколько запросов и повторов нужно для замера
Рэнд Фишкин, сооснователь SparkToro, в январе 2026 года признал, что изменил первоначальную позицию и теперь считает видимость в процентах по десяткам и сотням промптов, прогнанных несколько раз, разумной метрикой. Для замера отсюда следует, что нужны десятки промптов, и каждый из них прогоняют несколько раз. Универсального минимума нет: объём выбирают под число конкурентов и нишу.
Что считается хорошим показателем и как читать результат
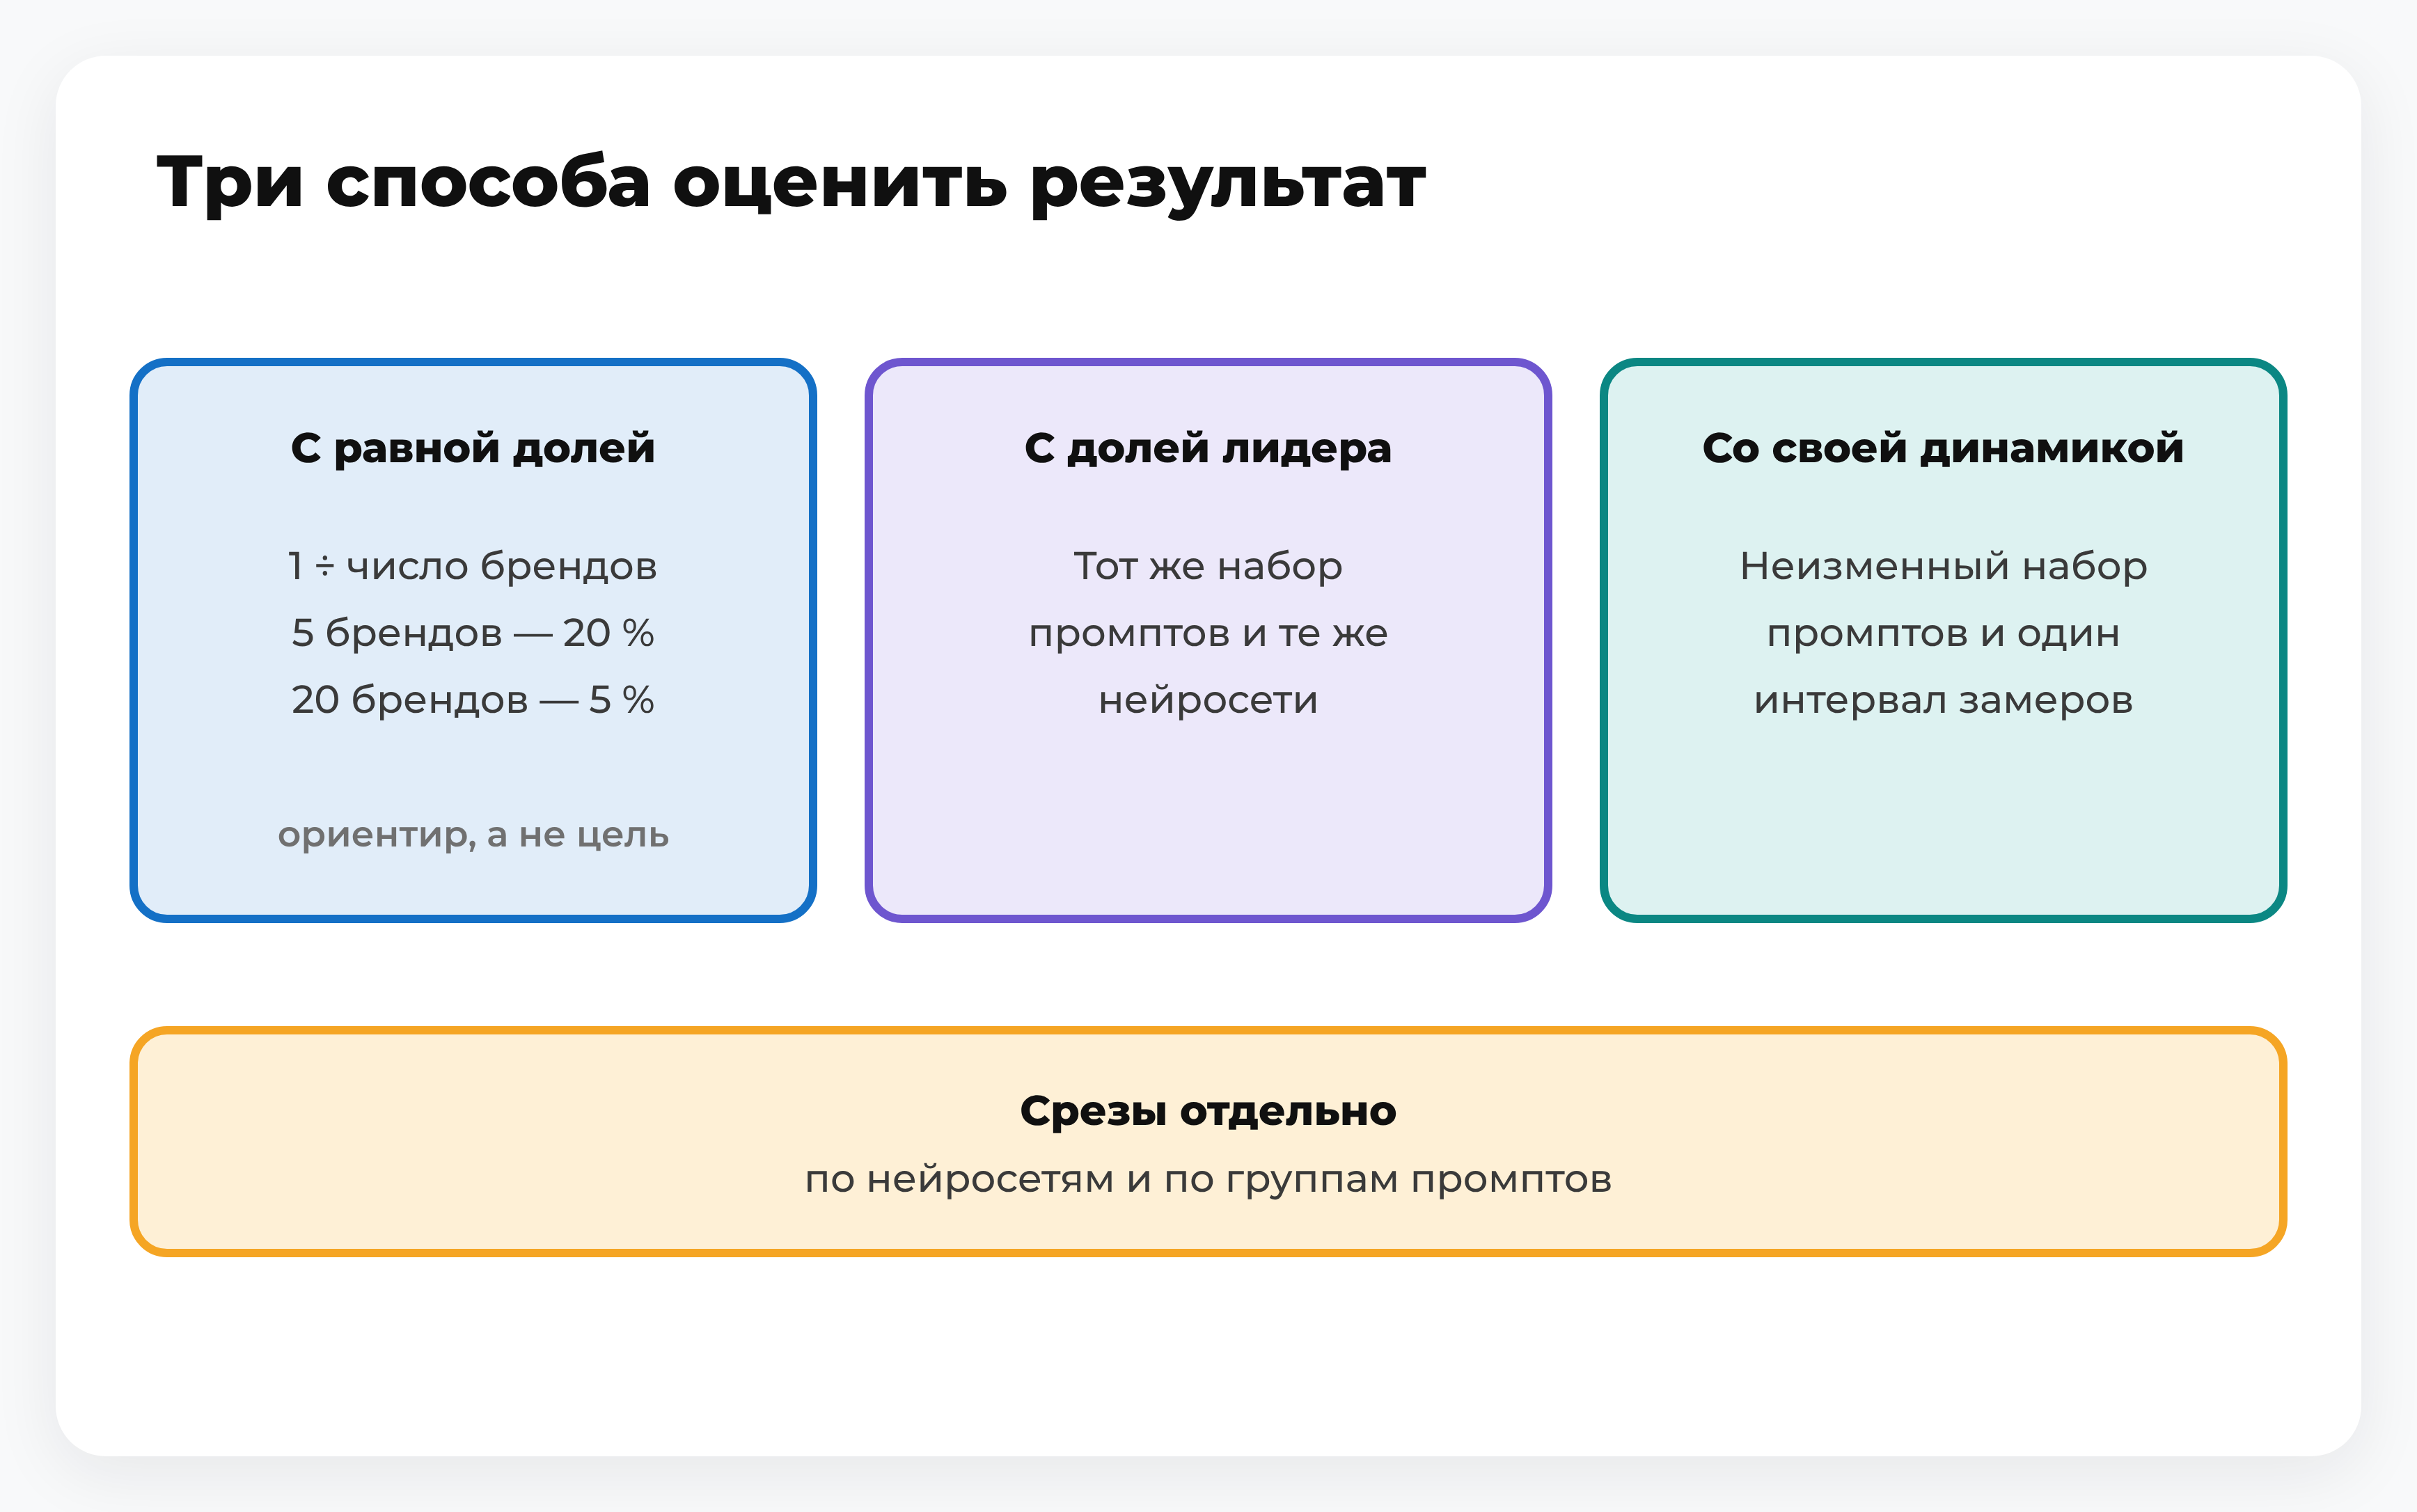
Универсального хорошего значения у этих метрик нет: оно зависит от числа брендов в ответах и от набора промптов, а шкалы без методики из блогов использовать не стоит. Mention Rate смотрят сначала по небрендовым промптам и по каждой нейросети, и только потом считают общую цифру. Результат оценивают тремя сравнениями. Первое — с равной долей, то есть 1 / число брендов в ответах: при 5 брендах это 20 %, при 20 брендах — 5 %, и это ориентир, а не цель. Второе — с долей лидера на том же наборе промптов. Третье — со своей динамикой при одном и том же интервале между замерами.
Тональность и контекст меняют смысл цифры. Упоминание бывает положительным, отрицательным или стоит в контексте «как делать не надо». Высокий Mention Rate при негативной тональности нельзя считать успехом. В Semrush, например, тональность вынесена в отдельный отчёт о восприятии бренда.
Промпты, где бренда нет вовсе, показывают, каких материалов и источников не хватает в стратегии контента. Закрывать такие пробелы и увеличивать долю голоса помогает продвижение сайта в нейросетях, при этом результат зависит от ниши и стартовой видимости.
Начинайте с промптов, где бренда нет вовсе: сильные позиции можно оставить на мониторинге.
Замер видимости на реальном проекте
В кейсе Kokoc для компании из сферы B2B-обучения (клиент под соглашением о неразглашении, NDA) мы собрали пул из 37 целевых небрендовых промптов вокруг услуг клиента. Базовый замер 17 апреля 2026 года показал видимость бренда 0,83 %. Подробности есть на странице кейса по GEO-продвижению (Generative Engine Optimization).
Работы начались 4 июня, и к 5 августа видимость выросла до 42,79 % (+41,96 п.п.) за два месяца. По системам результат различался в разы. Всего зафиксировано 95 упоминаний, все положительные. Такой разброс объясняет, зачем нейросети считают раздельно.
Клиент занял второе место среди отслеживаемых компаний, отстав от лидера на 0,49 п.п. Метрика кейса близка к Mention Rate, поэтому её значения нельзя читать как SoV, а разницу между брендами нужно считать в процентных пунктах. Цифры показывают представленность брендов в сегменте промптов, а не долю рынка. Для бизнеса это значит, что видимость по небрендовым промптам можно измерять и сравнивать с конкурентами, а результат относится к конкретному проекту и сроку.
Частые вопросы о доле голоса в ИИ
Как часто повторять замер?
Частоту выбирают под скорость изменений в нише. Внеплановый замер уместен после значимых публикаций и изменений на сайте. Semrush советует следить за показателем во времени: он меняется при действиях конкурентов и обновлениях моделей.
Чем взвешенный SoV отличается от простого счёта?
Semrush Enterprise AIO учитывает число упоминаний и позицию бренда в ответах, а для ChatGPT ещё и поисковый объём темы. Формула весов не раскрыта, поэтому пересчитать такой показатель вручную нельзя.
Что делать со ссылкой на сайт, если бренд не назван?
Ссылка на сайт и название бренда в тексте ответа — разные события, и считают их отдельно. В Mention Rate входит только названное упоминание. В Semrush, например, цитирования считают отдельно: это ответы со ссылкой на домен.
Связан ли SoV в ответах нейросетей с долей рынка?
В рекламе действует правило: бренды, у которых доля голоса выше доли рынка, при прочих равных растут. По данным IPA (Institute of Practitioners in Advertising) из публикации LinkedIn B2B Institute 2020 года, 10 % избыточной доли голоса (ESOV) соответствуют росту доли рынка на 0,7 % в год в B2B. Для ответов нейросетей такая связь не подтверждена, поэтому SoV в ИИ нельзя приравнивать к доле рынка.
Коротко о главном
- Share of Voice и Mention Rate — две доли, которые считают на одном наборе ответов нейросетей.
- SoV показывает долю упоминаний бренда среди всех упоминаний, Mention Rate — долю ответов, где бренд назван.
- Позиция в ответе ненадёжна, поэтому нужна доля по набору промптов с повторными прогонами.
- Один ответ даёт бренду одно упоминание, а список вариантов названия и конкурентов фиксируется до замера.
- Промпты берут из реальных формулировок пользователей и делят на брендовые, категорийные и сравнительные группы.
- Результат оценивают по равной доле, доле лидера и своей динамике; готовые шкалы без методики не используют.
- Каждую нейросеть считают отдельно, а число промптов и прогонов указывают рядом с цифрой.
.png)
.png)


Комментарии (2)
Оставить комментарий