


GEO-семантика — это набор разговорных запросов и вопросов к нейросетям и ИИ-ассистентам, сгруппированный по потребностям клиента, чтобы бизнес попадал в ответы ИИ, когда человек выбирает продукт или поставщика.
GEO (Generative Engine Optimization) — это подход, который помогает повысить видимость контента в ответах генеративных систем: так определяют термин авторы научной работы 2023 года, в которой он появился. Семантику для такого подхода собирают иначе, чем ядро для классического SEO. Список запросов строится от задач бизнеса и вопросов, из которых складывается выбор клиента, а не от частотности ключей, и проверяется на реальных ответах нейросетей. Как устроено продвижение в ответах ИИ в целом, разобрано в руководстве по продвижению в нейросетях.

- Чем запрос к нейросети отличается от поискового
- Какие интенты у запросов к нейросетям
- Источники запросов для GEO-семантики
- Как собрать запросы для нейросетей по шагам
- Приоритет запросов, важных бизнесу
- Как кластеризовать запросы для LLM
- Как проверить список запросов на ответах нейросетей
- Пример сбора запросов для B2B-клиента
- FAQ по GEO-семантике
- Коротко о главном
Чем запрос к нейросети отличается от поискового
В Google AI Mode запрос длиннее поискового (данные Semrush приведены ниже) и описывает ситуацию с условиями, поэтому единицей семантики становится вопрос или задача клиента, а не ключевая фраза. Вместо «crm для отдела продаж» (CRM — система учёта клиентов) человек, например, рассказывает, для какой команды, в каком городе и с каким бюджетом ему нужен продукт, и ждёт готовый ответ. Каждое такое уточнение сужает задачу и меняет то, что нейросеть сочтёт хорошим ответом.
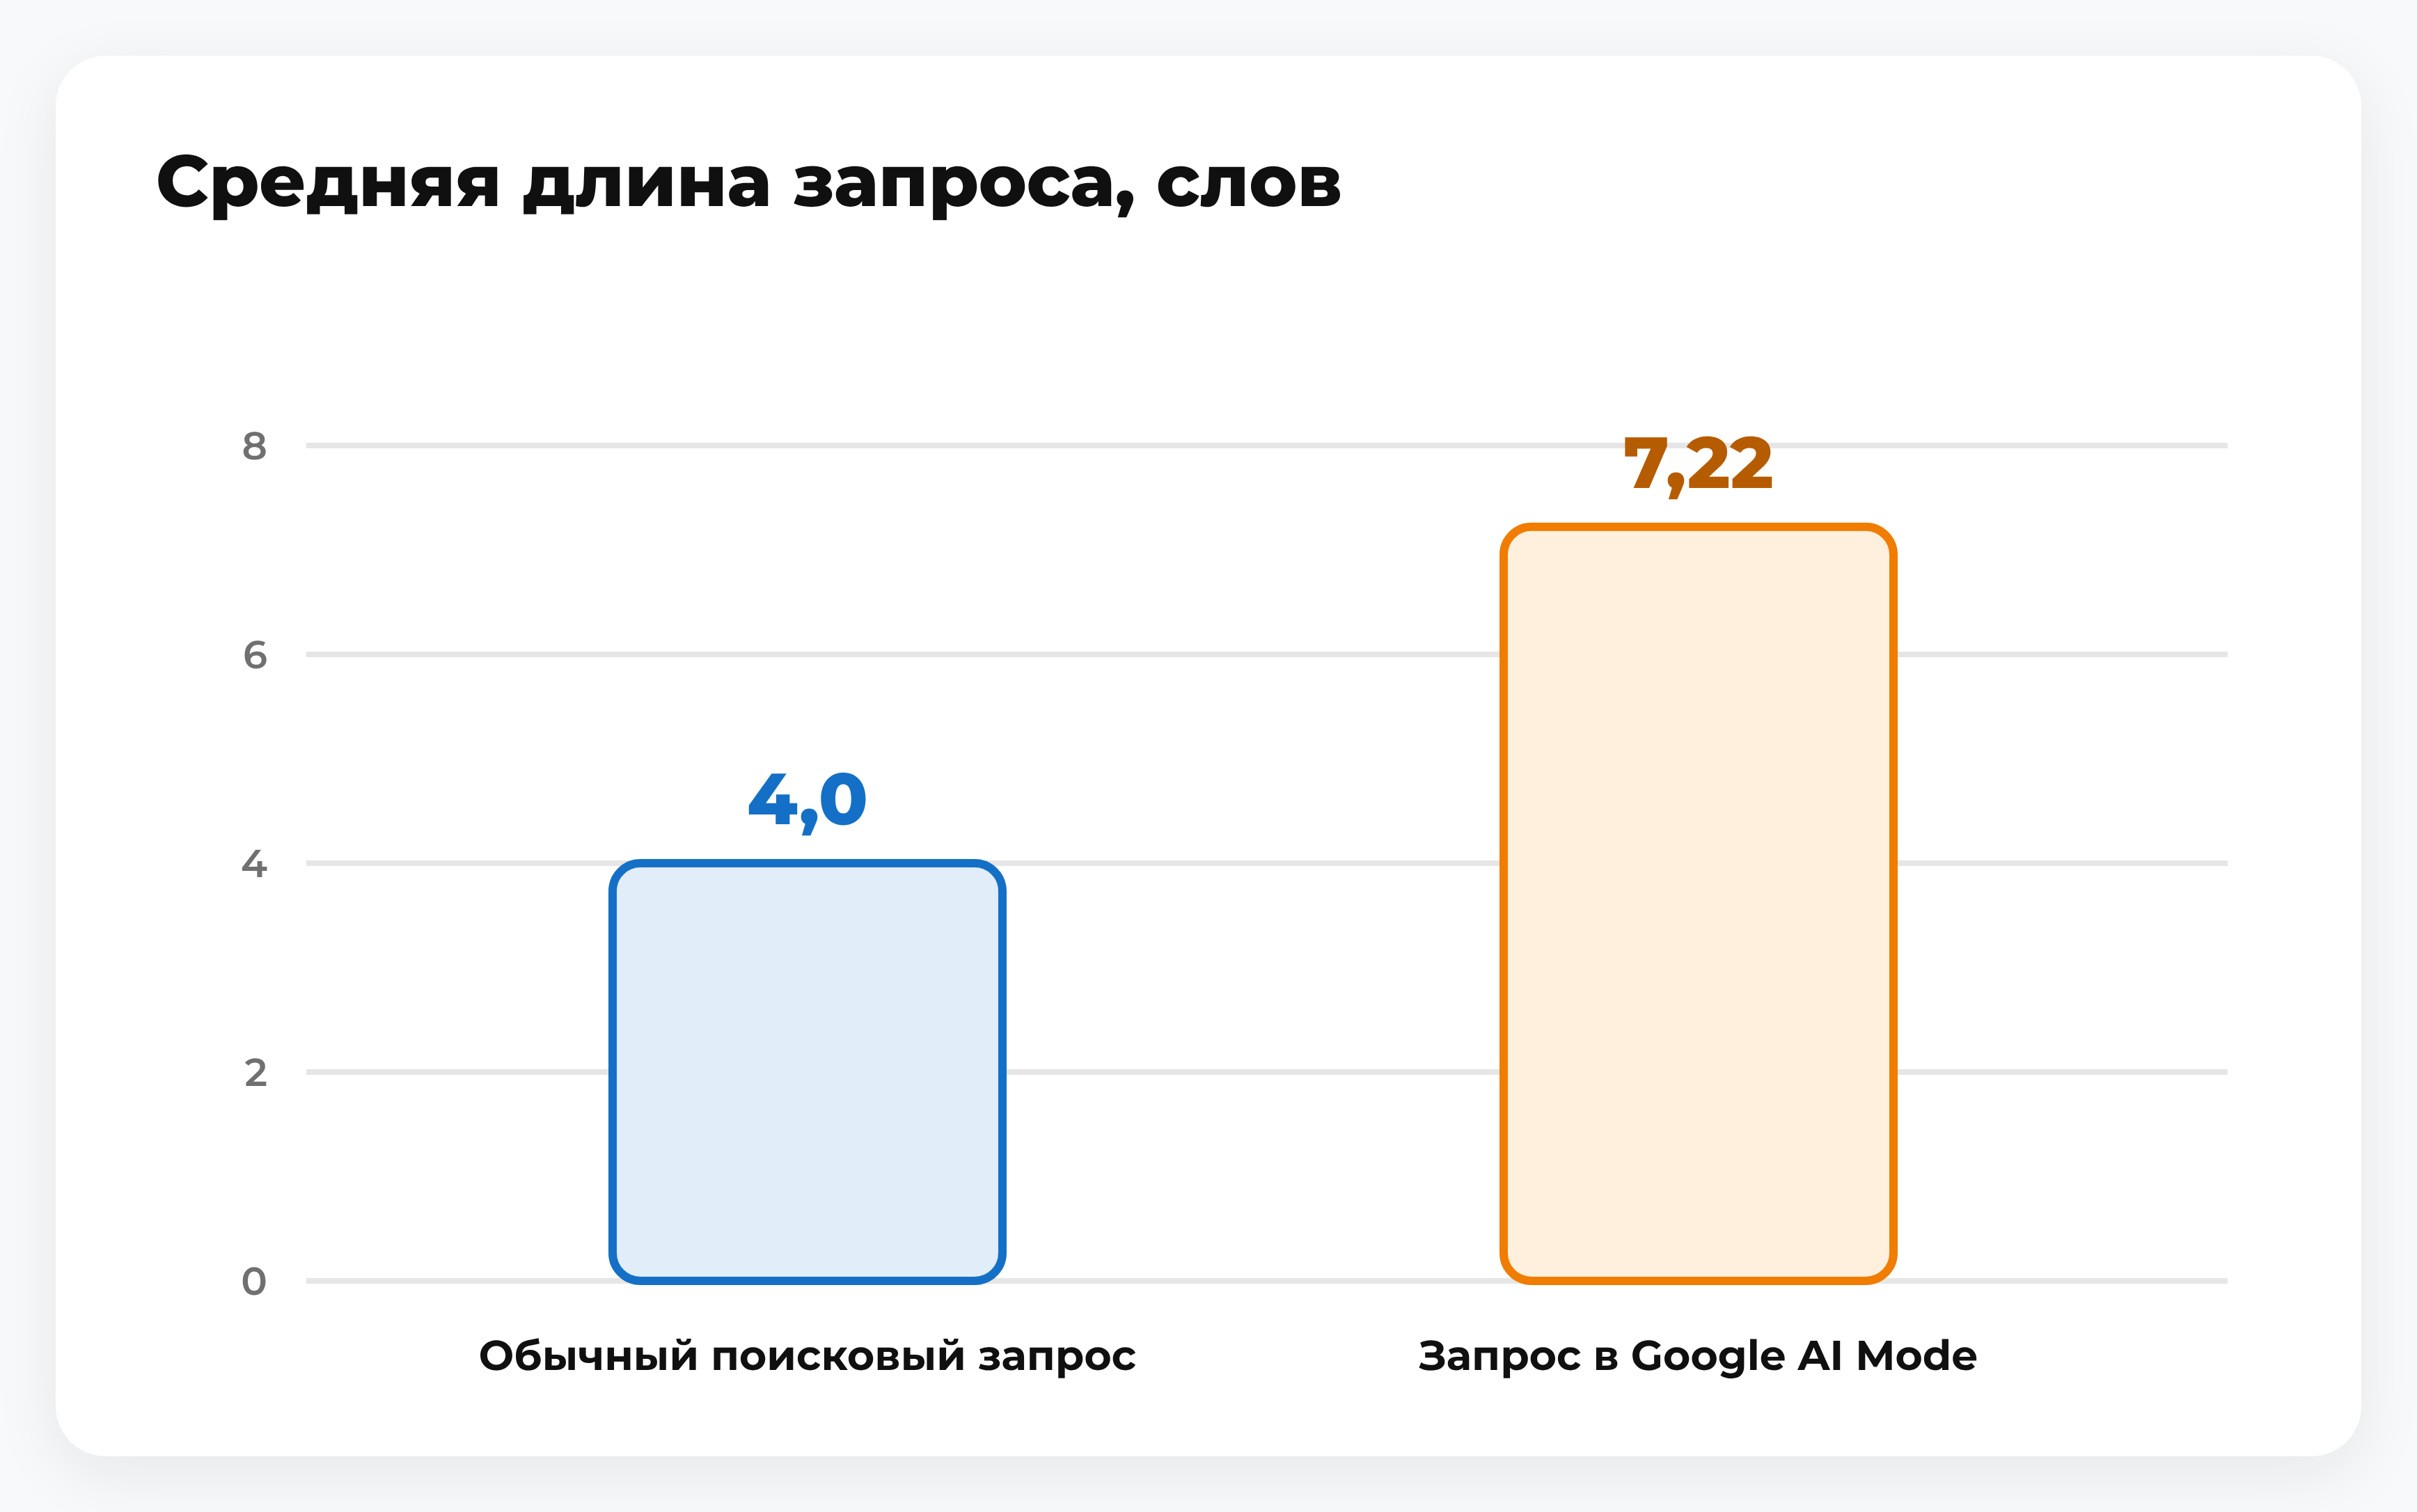
По данным Semrush (США, десктоп, 1 мая – 5 июля 2025 года), средний запрос в Google AI Mode, режиме поиска Google с развёрнутым ответом ИИ, составляет 7,22 слова против 4,0 у обычного поискового запроса. В том же отчёте отмечено, что в чате с ИИ вроде ChatGPT запросы длиннее, чем в интерфейсах поиска, где запрос составляет около четырёх слов.
От ключа к разговорному запросу
Одна и та же задача в ключе и в разговорном запросе выглядит по-разному: между ключевой фразой и запросом того же намерения добавляются роль покупателя, ситуация и ожидаемый тип ответа.
| Ключевая фраза (условная иллюстрация) | Запрос из проекта Kokoc | Что добавилось |
|---|---|---|
| тренинги для продаж b2b москва | Лучшие тренинги для отдела продаж B2B в Москве | Роль покупателя (отдел продаж) и просьба назвать лучших |
| обучение переговорам | Где обучить отдел продаж сложным переговорам | Ситуация и задача вместо темы |
| тренинговые компании москва | Какие тренинговые компании сейчас в топе в Москве | Просьба назвать лучших, то есть ожидаемый ответ списком компаний |
Третья строка самая ценная для бизнеса: такой вопрос ожидает перечень компаний, и попасть нужно именно в него. Запросы к голосовым помощникам, например к «Алисе» в «Яндекс Станции», собирают по тому же принципу, но записывают так, как человек произносит вопрос вслух: целой фразой, с ситуацией и условиями. Проверять такие формулировки стоит и в голосовом режиме ассистента, а не только в текстовом чате.
Почему список запросов описывает намерение, а не фразы
В исследовании SparkToro (по пересказу Search Engine Journal) 142 участника описали своими словами одну задачу, выбор наушников для путешествующего родственника, и почти ни один промпт, то есть текстовый запрос к нейросети, не повторил другой: семантическое сходство составило 0,081. При этом ответы нейросетей строились вокруг близкого набора брендов: Bose, Sony, Sennheiser и Apple встретились в 55–77 % из 994 ответов на эти промпты. В этом сценарии участники по-разному формулировали одну задачу, а ответы нейросетей при этом строились вокруг близкого набора брендов.
Классическое ядро при этом не выбрасывают. Часть запросов в чате остаётся близкой к ключам: в исследовании «Яндекса» по чату «Алисы AI» среди запросов о товарах и услугах приведён пример «кроссовки женские модные купить в спб». Ключи и данные о спросе дают тематическую основу и границы, а уточнения (город, бюджет, роль, условия) превращают тему в условия выбора. Просмотрите текущее ядро и допишите к каждой теме условия, при которых клиент выбирает вашу услугу.
Какие интенты у запросов к нейросетям
Запросы к нейросетям для сбора удобно делить на информационные («объясни, как устроены стратегические сессии»), практические («составь план обучения для отдела продаж») и рекомендательные («посоветуй, кого выбрать»). Информационные и практические показывают, о чём люди вообще спрашивают ИИ, а рекомендательные возникают, когда они выбирают, у кого купить. Для GEO ценнее последние: нейросеть отвечает на них перечнем компаний, программ или специалистов, и клиент выбирает из этого перечня. Структуру запросов измеряют по-разному, и классификации не совпадают. OpenAI в исследовании использования ChatGPT разделила сообщения на Asking (вопросы и просьбы о совете), Doing (поручения выполнить задачу) и Expressing (личные размышления, эксперименты и игра), а «Яндекс» описал поток чата «Алисы AI» по форме сообщения и по тематике.
| Срез | Что измерено | Данные |
|---|---|---|
| ChatGPT, потребительские тарифы, 1,5 млн разговоров, исследование OpenAI от 15 сентября 2025 года | Тип использования | Asking — 49 %, Doing — 40 %, Expressing — 11 %; три четверти разговоров — практические советы, поиск информации и письмо |
| Чат «Алисы AI», сентябрь 2025 – январь 2026 года | Форма сообщения | Больше половины — вопросы, просьбы — 27,3 %, высказывания — 18,3 % |
| Чат «Алисы AI», тот же период | Тематика | Информационные запросы — 32,7 %, товары и услуги — около 3 % |
Цифры из разных классификаций не складываются. Вместе они показывают, что основная часть потока — вопросы, советы и поручения, а запросы про товары и услуги в чате «Алисы AI» составляют около 3 %.
Описание интента для сбора
Пользователь нейросети описывает составную ситуацию: в одном запросе информационная часть («как выбрать») соседствует с коммерческой («в Москве, для отдела продаж»). Поэтому интент для GEO записывают как задачу и ожидаемый тип ответа: объяснение, сравнение или рекомендация списком.
Для каждого интента достаточно четырёх полей: проблема пользователя, кто спрашивает, какой ответ он ожидает и какое решение бизнеса подходит. Разберём запрос «Подскажи, как выбрать провайдера обучения для отдела продаж в Москве и сколько это стоит». Проблема пользователя — выбор исполнителя, спрашивает руководитель отдела продаж или специалист по обучению, ожидаемый ответ — сравнение вариантов с ценами, а решение бизнеса — услуга корпоративного обучения. Если последнее поле пустое, запрос пока не связан с услугой компании и в работу не идёт. Эти поля заодно показывают разные аудитории: руководитель отдела продаж и специалист по закупкам описывают одну услугу разными словами.
Типологии вендоров помогают с формулировками: Semrush в справке Prompt Research делит промпты на информационные, навигационные, коммерческие, транзакционные и task-based, то есть запросы на пошаговую инструкцию или выполнение задачи. Но в AI-чатах запрос пишут на естественном языке, как вопрос собеседнику, поэтому интент определяют по смыслу задачи, а не по набору слов.
Источники запросов для GEO-семантики
Основа списка — задачи бизнеса и ситуации, в которых клиент выбирает продукт или поставщика. Инструменты подбора ключей и сами нейросети расширяют уже найденные сценарии, но не заменяют знание о том, как покупают именно у вас. Поэтому источники используют в таком порядке: сначала внутренние данные, затем внешние.
Внутренние данные компании
Слова клиентов знают те, кто с ними разговаривает. Соберите вопросы из четырёх мест:
- менеджеры по продажам: вопросы, с которых начинается разговор, и возражения;
- поддержка: обращения после покупки и частые вопросы;
- руководители услуг: критерии, по которым клиент сравнивает исполнителей;
- аккаунт-менеджеры: просьбы клиентов, которые повторяются от проекта к проекту.
Эти данные первичны: они показывают ситуации выбора, которые не видны ни по ключам, ни по текущим ответам нейросетей. Из них же получаются запросы с реальными условиями клиента, которые не придумать за столом. Если в CRM ведутся комментарии к сделкам и записи разговоров, начните с них: попросите менеджеров отметить, что клиент спрашивал до выбора исполнителя, с чем сравнивал и какие возражения называл. Для каждой записи фиксируйте услугу, к которой она относится, чтобы потом не искать связь с продуктом заново.
Записывайте вопросы клиентов дословно, вместе с городом, бюджетом и ролью спрашивающего: пересказ менеджера стирает условия, из которых состоит разговорный запрос.
Внешние источники и сами нейросети
Классическое ядро и поисковые подсказки дают тематическую основу, а ответы нейросетей показывают, как системы раскрывают подтемы и каких компаний называют сейчас. Прогоните тематический вопрос через несколько систем и выпишите подтемы, формулировки с условиями и компании из ответов: так видна представленность конкурентов.
Российскому бизнесу список нужен на русском и с региональными условиями: в формулировках проекта, о котором речь ниже, город входит в сам запрос. Системы для проверки подбирают по аудитории: например, «Алиса AI» и Google. ChatGPT включают, если им пользуется ваша аудитория, в том числе на зарубежных рынках; Россия при этом не входит в список стран, где OpenAI официально поддерживает сервис. Различия по языкам и регионам лучше замерять, чем предполагать.
Спрос оценивают косвенно. Зарубежные платформы дают модельные оценки: Semrush (недоступен в России) в отчёте Prompt Research показывает оценку AI Volume по темам для Google AI Overviews (блок с ответом ИИ над результатами поиска), AI Mode, Gemini и ChatGPT, а Ahrefs в методологии Brand Radar называет свои метрики направленными индикаторами и не считает подтверждённой связь между объёмом поиска в Google и частотой запроса внутри ИИ-инструмента. Поэтому спрос служит дополнительным сигналом к вопросам клиентов и текущим ответам, а не главным критерием.
Как собрать запросы для нейросетей по шагам
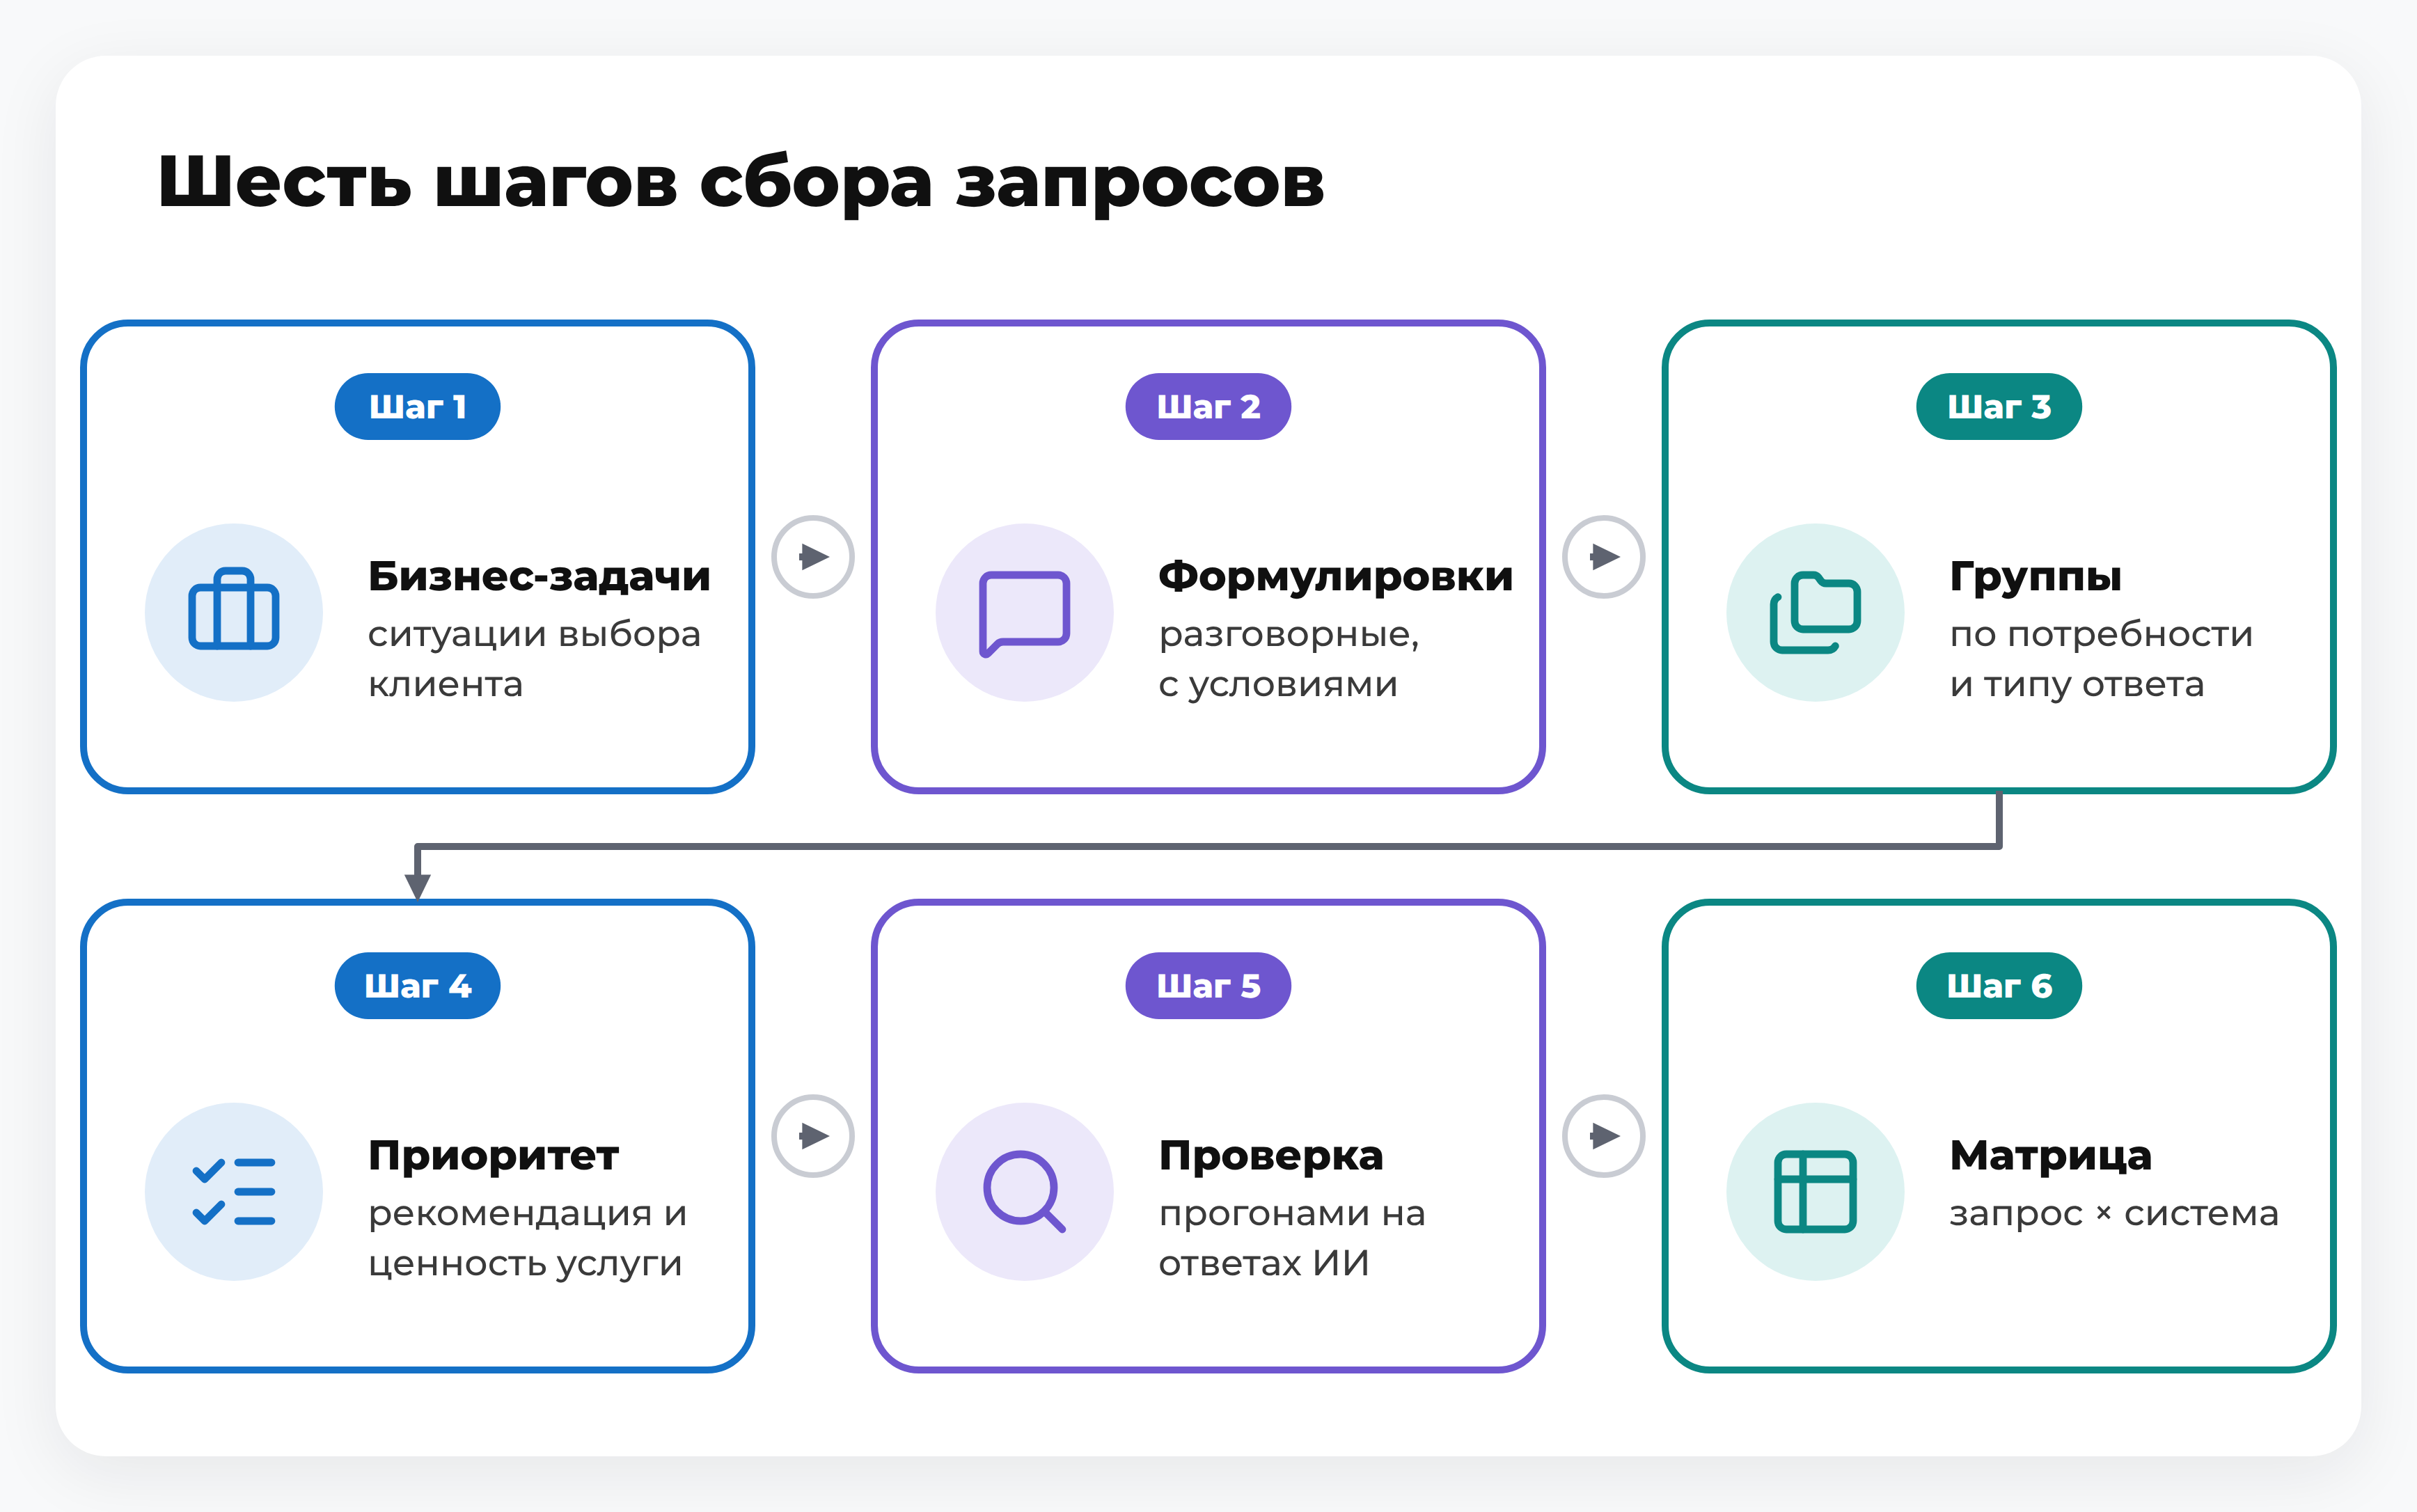
Мы предлагаем такой порядок: выписать бизнес-задачи, перевести их в разговорные формулировки, сгруппировать запросы по потребности, расставить приоритет, проверить прогонами в нейросетях и закрепить результат матрицей «запрос × система». Каждый следующий шаг опирается на предыдущий, поэтому пропуск любого из них ломает список дальше.
Шесть шагов от задач бизнеса до матрицы
Шаг 1. Выпишите бизнес-задачи и ситуации, в которых клиент выбирает продукт или поставщика. В этой работе участвуют маркетинг, продажи и руководители услуг: каждый знает свою часть вопросов. Например, для компании корпоративного обучения это ситуация, когда руководитель выбирает провайдера тренинга для отдела продаж, и ситуация, когда нужно понять, какой формат обучения вообще подходит. Результат шага — перечень услуг с ситуациями выбора, к которым потом привязываются запросы.
Шаг 2. Превратите ключ в запрос пользователя: добавьте город, бюджет, роль и ограничения. Для одного намерения нужно несколько вариантов, написанных разными словами: «Кого выбрать для обучения отдела продаж в Москве», «У кого заказать тренинг по продажам для B2B-команды», «Сравни тренинговые компании по продажам в Москве». Нейросеть помогает расширить варианты, а приоритет ей не поручают: ценность запроса для бизнеса знает только компания. Идеи для таких вариантов можно взять в материале о сборе семантики через ChatGPT.
Шаги 3–6 разобраны в разделах ниже: приоритет (шаг 4) — в разделе о запросах, важных бизнесу, группировка по потребности и типу ответа (шаг 3) — в разделе о кластеризации, проверка прогонами и матрица «запрос × система» (шаги 5 и 6) — в разделе о проверке. На выходе получается список, где у каждого запроса указаны кластер, услуга, ожидаемый тип ответа и приоритет. Такая строка годится и для замера, и для постановки задач на контент.
Приоритет запросов, важных бизнесу
Первыми берут запросы, на которые нейросеть отвечает перечнем компаний, программ или специалистов и где решение клиента зависит от этого перечня; информационные идут следом. Приоритет определяют два вопроса: ждёт ли пользователь рекомендацию и насколько ценна услуга, которой она касается. Остальные критерии уточняют очередь.

Чтобы не потерять бизнес-смысл, у каждого запроса указывают услугу или продукт и то, что хочет получить пользователь. Если менеджер или руководитель услуги не может ответить на такой запрос, его возвращают владельцу услуги на уточнение, а в матрицу вносят только согласованные формулировки. Попадание в ответ даёт упоминание компании или ссылку на её сайт, так формируется видимость бренда в нейросетях. Но она не гарантирует переходов и заявок: человек может получить ответ, не открывая страницу.
| Критерий | Вопрос к запросу | Влияние на приоритет |
|---|---|---|
| Рекомендательный интент | Ждёт ли пользователь перечень компаний, программ или специалистов | Высокий приоритет, если да |
| Ценность для бизнеса | Какую услугу продвигает запрос и насколько она важна | Выше у приоритетных услуг |
| Соответствие возможностям | Может ли компания выполнить обещание, которое даст ответ | Без соответствия запрос не берут в работу |
| Текущие ответы | Кого нейросети называют сейчас и есть ли среди них компания | Показывает разрыв, который нужно закрывать |
| Спрос и конкурентность | Насколько тема популярна и сколько компаний борются за ответ | Дополнительный сигнал, не главный критерий |
Возьмём два запроса для компании корпоративного обучения. «Какие тренинговые компании сейчас в топе в Москве» проходит по первым двум критериям: пользователь ждёт список, а услуга приоритетна. Дальше смотрят текущие ответы: если нейросети называют конкурентов, а компании в списке нет, запрос получает высокий приоритет. «Что такое фасилитация» остаётся информационным: он полезен для охвата темы, но в очереди стоит позже.
Как кластеризовать запросы для LLM
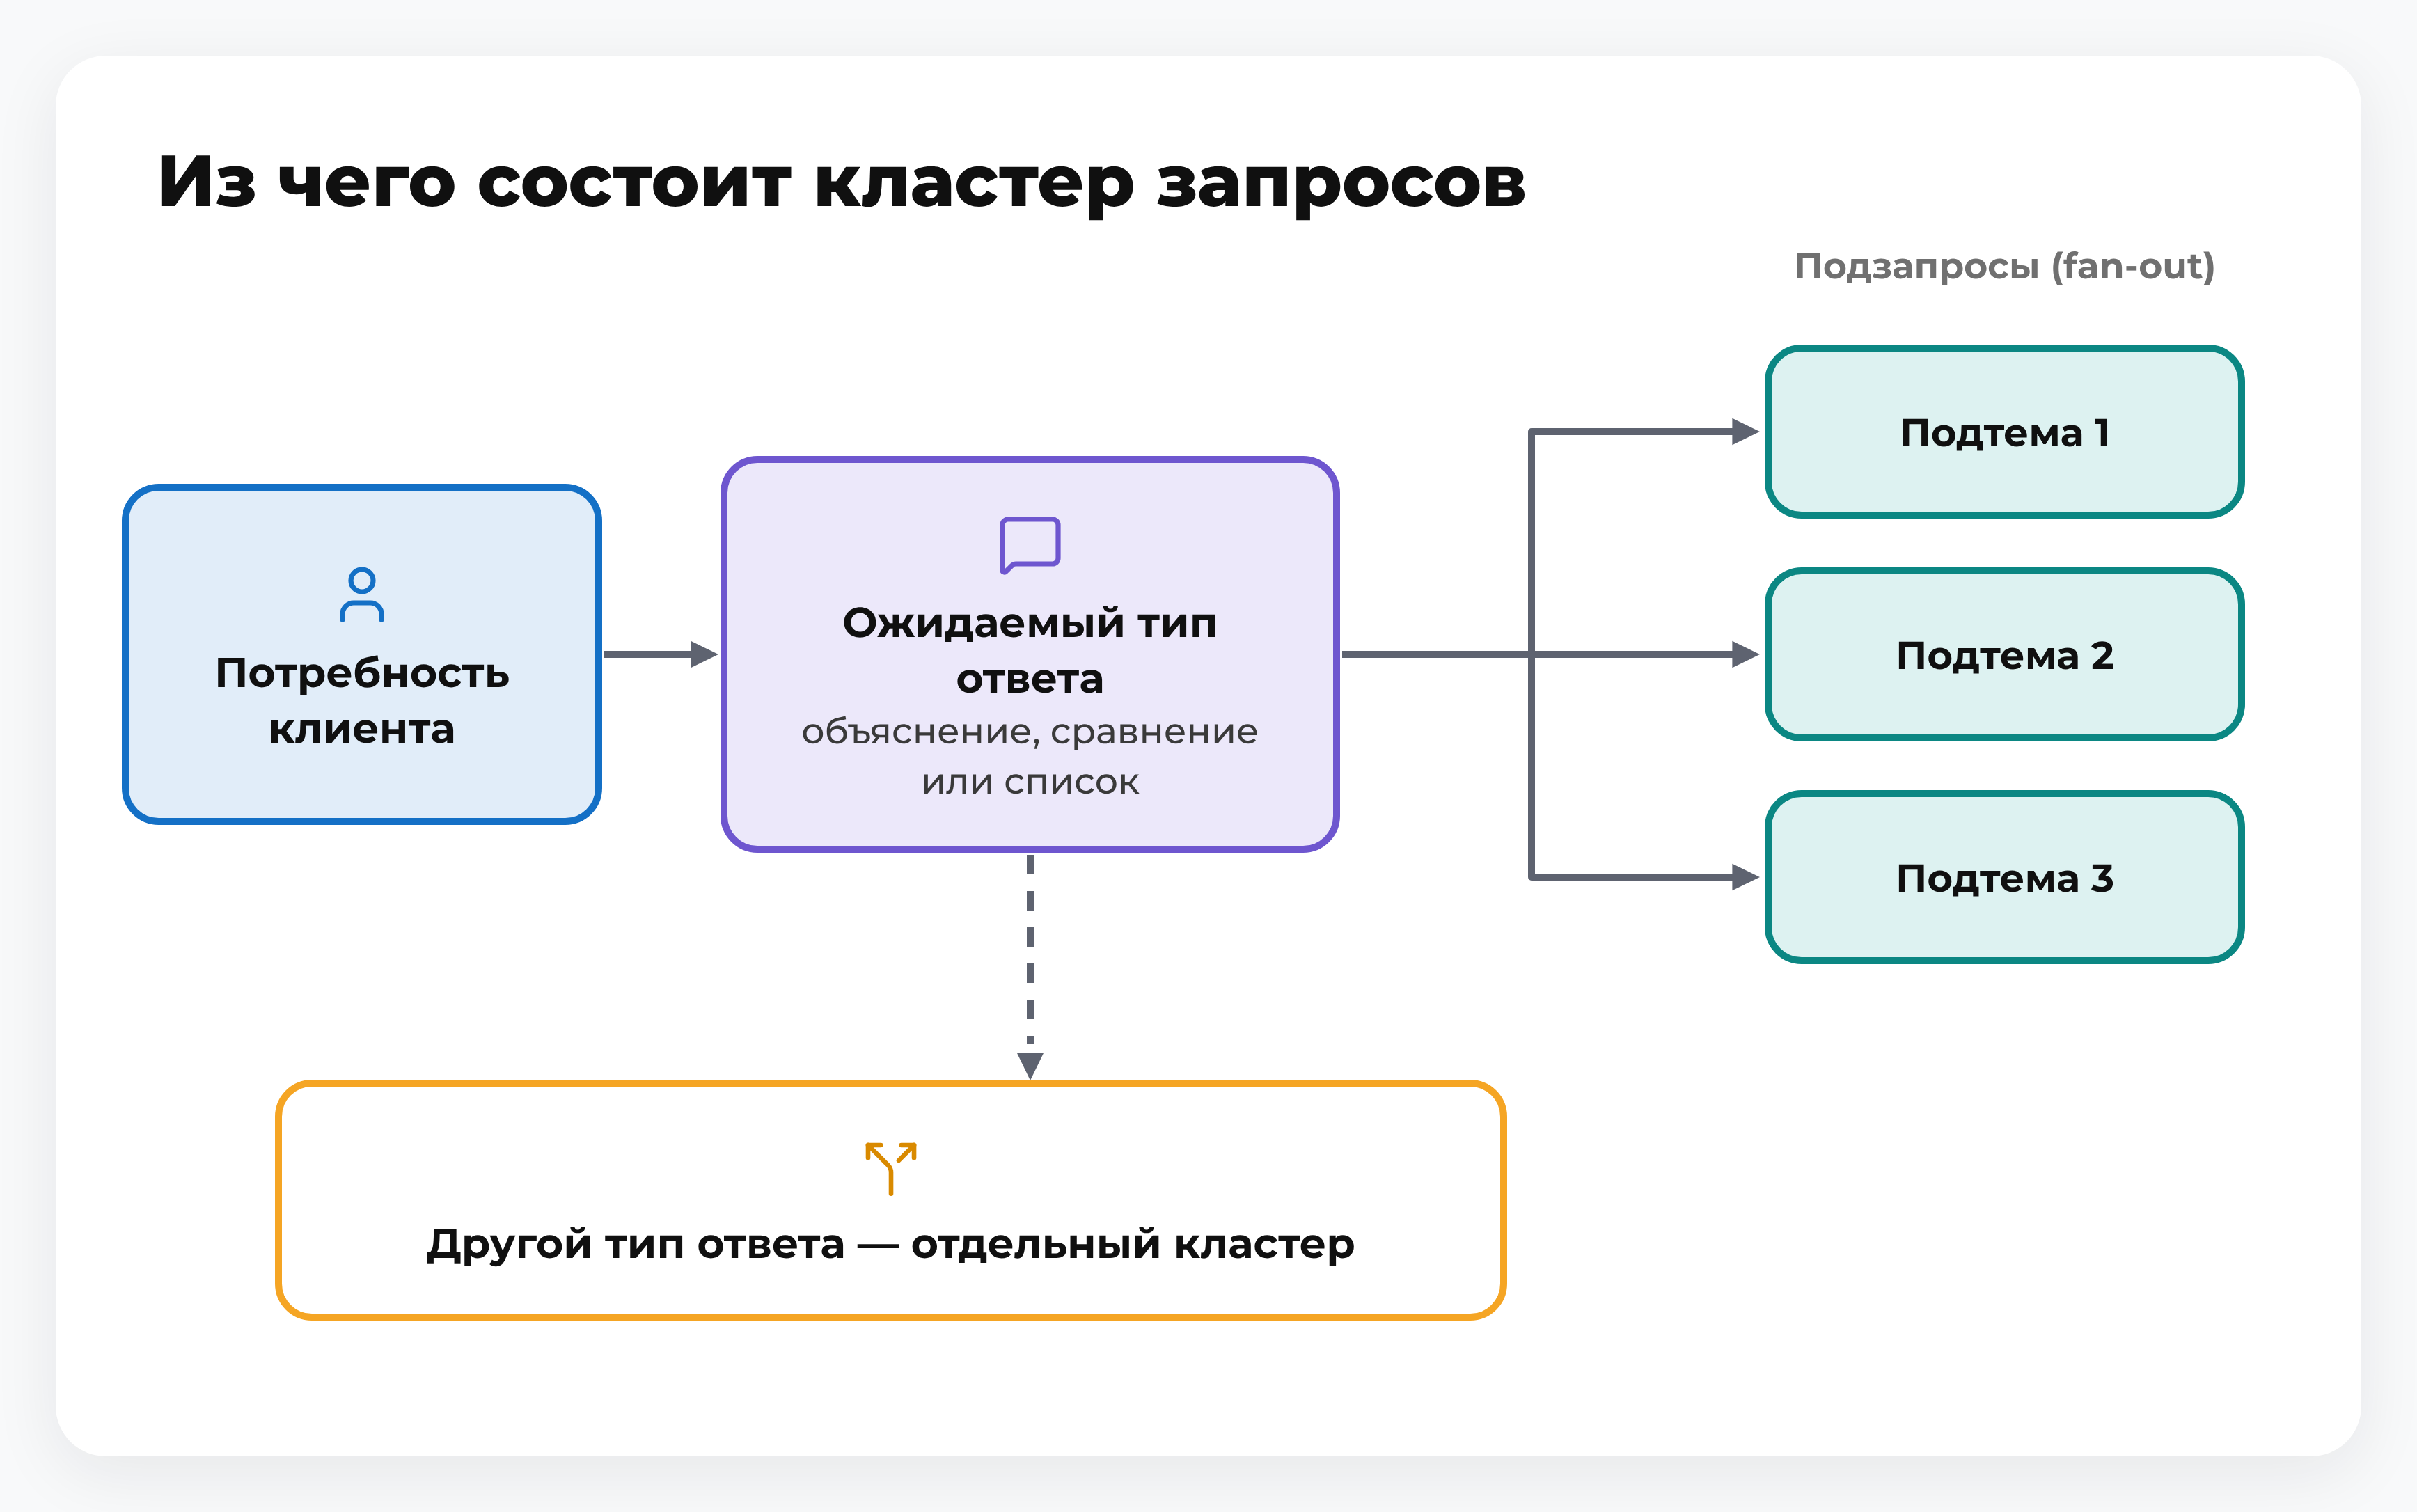
Кластер строится вокруг одной потребности пользователя и ожидаемого типа ответа, а не вокруг общих слов или частотности. LLM — это большая языковая модель, на которой работают ИИ-чаты. Например, запросы «лучшие тренинги по переговорам» и «как подготовиться к переговорам с закупщиком» содержат общее слово, но первый ждёт список компаний, а второй объяснение, поэтому кластеры у них разные. В один кластер попадают запросы с одним сценарием, одним типом ответа (объяснение, сравнение или рекомендация списком) и одним решением бизнеса, а название кластеру дают по задаче клиента, например «выбрать провайдера обучения для отдела продаж».

Query fan-out как логика кластера
Query fan-out — это набор одновременных связанных запросов, которые модель формирует к вопросу пользователя, чтобы получить дополнительную информацию и найти больше релевантных результатов. Google пишет, что AI Overviews и AI Mode могут использовать эту технику: несколько связанных поисков по подтемам и источникам данных. В примере из руководства Google для вопроса о том, как избавиться от сорняков на газоне, такими подзапросами могут быть «лучшие гербициды для газона», «как убрать сорняки без химии» и «как предотвратить сорняки на газоне».
Для кластера отсюда вывод: он строится вокруг вопроса и его подтем, а не вокруг одной фразы. Когда кластер собран, проверьте, раскрывают ли его запросы подтемы, которые нейросети добавляют к вопросу в своих ответах. Подробнее о логике подзапросов и группировке запросов для LLM — в статье о методологии query fan-out.
Чем это отличается от кластеризации по выдаче
В классической SERP-кластеризации запросы объединяют, когда Google ранжирует по ним одни и те же URL. Такое пересечение выдачи (SERP — страница результатов поиска) показывает, что один материал может закрыть оба запроса, и решает вопрос уровня страницы: какие ключи относятся к одной странице. Так описывает метод Semrush. Кластер для GEO объединяет намерения по сценарию и ожидаемому типу ответа и проверяется на ответах нейросетей. Основы классического подхода собраны в гайде по кластеризации семантического ядра.
Кластер подсказывает и тип материала: таблицы сравнения и страницы цен под запросы о выборе, экспертные статьи под информационные. Страницу под каждый подзапрос создавать не нужно. В руководстве для владельцев сайтов от 15 мая 2026 года Google указывает, что отдельный контент под каждый вариант запроса или fan-out-запрос, созданный главным образом ради манипуляции выдачей или ответами ИИ, нарушает политику против масштабированного спама, а большое число страниц не делает сайт качественнее.

Как проверить список запросов на ответах нейросетей
Проверка устроена просто: каждый запрос прогоняют в каждой системе несколько раз и записывают результат в матрицу «запрос × система». Единица измерения — доля проверок, в которых бренд присутствует в ответе. Одиночный прогон для этого не годится, потому что ответы нейросетей меняются от повтора к повтору.
В исследовании SparkToro и Gumshoe.ai, поставщика инструментов для мониторинга ИИ (работа не рецензировалась, пересказ Search Engine Journal), 12 промптов на подбор брендов запускали по 60–100 раз на каждой платформе: ChatGPT, Claude и Google AI в поиске (AI Overviews и AI Mode), в ноябре–декабре 2025 года. Вероятность получить одинаковый список брендов при повторе одного промпта для ChatGPT и Google AI оказалась меньше 1 из 100. Почти каждый ответ отличался составом списка, порядком и числом позиций, поэтому один замер ничего не доказывает.
Что сравнивать и как оформить матрицу
Частота появления бренда по многим прогонам похожих промптов устойчивее, чем его позиция в одном ответе. По тому же пересказу, в узких категориях вроде облачных провайдеров топовые бренды встречались в большинстве ответов, а в широких результаты были разбросаны. Поэтому бренды не ранжируют по месту в одном ответе, а сравнивают по доле прогонов, где бренд назван. О том, как считать видимость и вести мониторинг дальше, подробно рассказано в материале о видимости бренда в нейросетях.
В матрице запросы идут по строкам, системы по столбцам, а в каждой ячейке фиксируют дату замера и долю прогонов с брендом. Результат описывает пул запросов и набор систем, которые вошли в замер, и не переносится на рынок в целом. Замер повторяют после изменений на сайте и во внешних публикациях: так получается сравнение «до и после». Для каждого прогона записывают:
- систему и дату замера;
- формулировку запроса, как она была введена;
- назван ли бренд компании и в каком контексте;
- какие компании названы рядом, чтобы видеть конкурентов в ответе.
Заведите матрицу до первых изменений на сайте: замер «до» нельзя сделать задним числом, а без него не получится сравнение «до и после».
Пример сбора запросов для B2B-клиента
B2B-клиент, компания корпоративного обучения (работа ведётся под NDA, поэтому название не раскрываем), появлялся в ответах нейросетей по целевым небрендовым запросам лишь эпизодически: в них не было названия компании, но шёл выбор поставщика. Базовый замер сделали 17 апреля 2026 года, активные работы шли с 4 июня по 5 августа 2026 года.
Отбор промптов
Из пула промптов выбрали 37 по шести признакам:
- услуги и бизнес-приоритеты клиента;
- вопросы, которые возникают при выборе обучения;
- существующие ответы нейросетей и представленность конкурентов;
- коммерческая ценность сценария;
- поисковый спрос и конкурентность тематик;
- вероятность того, что запрос запустит рекомендацию компаний, программ или экспертов.
В работу вошли прежде всего запросы с условно-коммерческим интентом: на такой вопрос пользователь ожидает получить перечень подходящих провайдеров, программ или специалистов.
Кластеры промптов
Отобранные 37 промптов разложили на шесть тематических кластеров. План внешних публикаций по кластерам составили до начала размещений и не меняли по промежуточным результатам. Масштаб работ — 111 внешних публикаций на трёх площадках: VC.ru, «Дзене» и TenChat, в формате рейтингов, подборок и обзоров.
| Тематический кластер | Промптов | Публикаций |
|---|---|---|
| Корпоративное обучение и бизнес-тренинги | 10 | 30 |
| Переговоры | 7 | 21 |
| B2B-продажи, управление ключевыми клиентами и сложные сделки | 6 | 18 |
| Лидерство и управление | 6 | 18 |
| Стратегические сессии и фасилитация | 5 | 15 |
| Бизнес-тренеры и эксперты | 3 | 9 |
| Итого | 37 | 111 |
Замер и результат
Видимость считали как долю проверок «промпт × система», в которых компания присутствовала в ответе нейросети. При 37 промптах и шести системах (Поиск с Алисой, Google AI Overview, ChatGPT, Perplexity, DeepSeek и Claude) база одного замера составила 222 проверки.
За два месяца видимость выросла с приблизительно 0,83 % до 42,79 %, то есть на 41,96 процентного пункта. Это значение по пулу из 37 промптов клиента, а не доля рынка, и результат дала вся программа работ с внешними публикациями, а не сам список запросов; влияние на заявки не доказано. В Поиске с Алисой видимость на 5 августа составляла 75 %.
Для своего проекта берите порядок работы: отберите запросы по бизнес-критериям, сгруппируйте по потребностям клиента и до начала размещений зафиксируйте план внешних публикаций по кластерам. В проекте большинство отобранных промптов содержали рекомендательный интент, поэтому группы по потребности совпали с направлениями услуг клиента. Подробности — на странице кейса о GEO-продвижении B2B-бренда. Если нужен такой же путь для вашего продукта, поможет продвижение сайтов в нейросетях.
FAQ по GEO-семантике
Нужно ли собирать запросы отдельно для каждой нейросети?
Список собирают общий, по намерениям клиентов, а замеряют по каждой системе отдельно. Google пишет, что AI Mode и AI Overviews могут использовать разные модели и техники, поэтому наборы ответов и ссылок в них различаются даже внутри Google. Единый список позволяет сравнивать системы между собой по одним и тем же запросам.
Как часто пересматривать список запросов?
Пересматривайте список, когда меняется одно из трёх: услуги и продукты компании, вопросы клиентов в продажах и поддержке или результаты повторного замера. Поводом служит и новая нейросеть, которой пользуется ваша аудитория. Календарь пересмотра удобно привязать к повторным замерам: если они дают другие ответы, список проверяют.
Подходит ли метод малому и среднему бизнесу?
Да. Число запросов определяется числом сценариев, в которых клиент выбирает вас, поэтому у малого бизнеса и узкой ниши список короче, а устроен так же. Для старта достаточно одной приоритетной услуги: по ней собирают вопросы клиентов, группируют их и проверяют ответы в нескольких системах. Когда матрица заработает, список расширяют на следующие услуги.
Есть ли отчёт Google для оценки показа в ИИ-ответах?
Да, в Search Console есть отчёт Generative AI performance. Google предлагает с его помощью оценить, как люди находят контент через генеративные функции Search и Discover. Отчёт относится к показу вашего контента в Google, поэтому для остальных систем нужна своя матрица проверок.
Коротко о главном
- Запросы для GEO собирают от задач бизнеса и вопросов выбора клиента и проверяют на ответах нейросетей несколькими прогонами.
- Запросы к нейросетям в среднем длиннее поисковых и чаще описывают ситуацию, поэтому единица списка — намерение клиента с несколькими формулировками.
- Для GEO важнее всего интенты, на которые нейросеть отвечает перечнем компаний, программ или специалистов.
- Основа списка — внутренние данные компании; подсказки, ответы нейросетей и оценки спроса её дополняют.
- Порядок работы: бизнес-задачи, формулировки, группы, приоритет, проверка, матрица. Первыми берут запросы с рекомендацией, на которую компания может ответить услугой.
- Кластер строится вокруг одной потребности и типа ответа, а не вокруг слов; отдельная страница под каждый подзапрос не нужна.
- Ответы нейросетей меняются от прогона к прогону, поэтому решения принимают по матрице «запрос × система» и доле проверок с брендом.

.png)
.png)



Комментарии
Комментариев пока нет. Будьте первым!
Оставить комментарий