

Создание сайта — лишь первый шаг. Сразу после релиза бизнес сталкивается с необходимостью попасть в поисковую выдачу. В этом руководстве мы разберем технические нюансы краулинга с учетом актуальных алгоритмов. Материал построен как практический гайд: от базовых понятий до диагностики проблем через логи сервера и панели вебмастеров. Инструкция обязательна к изучению SEO-специалистам, маркетологам и владельцам e-commerce проектов.
- Что такое индексация сайта
- Как проходит процесс индексации
- Принципы индексации в Google и Яндексе
- Как настроить индексацию сайта
- Как ускорить индексацию сайта
- Как запретить индексирование
- Распространенные ошибки индексирования
- Как проверить индексацию сайта
- FAQ по индексации сайтов
- Коротко о главном
Что такое индексация сайта
Коротко: что такое индексация сайта
Индексация сайта — это процесс, при котором поисковая система сканирует страницу, при необходимости рендерит её JavaScript-контент, анализирует метаданные и добавляет сведения о странице в свой индекс, чтобы показывать её в результатах поиска. Пока URL не в базе — он не получает показов, кликов и органического трафика. Нет в индексе = нет трафика = нет продаж.
Алгоритмы не просто сохраняют ссылки, а детально парсят содержимое. Выявляются именованные сущности, оценивается структура документа и проверяется микроразметка. Без технической доступности ресурс невидим для целевой аудитории. Выпадение URL из базы приводит к обнулению PageRank, потере накопленных поведенческих факторов и резкому падению лидов.
Настройка сканирования — фундамент работы над проектом. Только после обеспечения беспрепятственного доступа ботам к контенту имеет смысл внедрять остальные элементы оптимизации. С развитием технологий краулинг усложнился: системы триангулируют факты, проверяют E-E-A-T сигналы и оценивают скорость отрисовки интерфейса.
Как проходит процесс индексации
- Обнаружение: краулер находит новый URL через карту сайта или внешние ссылки и ставит его в очередь.
- Сканирование: бот загружает HTML-код, очищает его от служебного мусора и формирует список лексем (совокупность грамматических форм слова).
- Рендеринг: при необходимости запускается движок Chromium для выполнения JS-скриптов и отрисовки динамических блоков.
- Анализ: система оценивает релевантность интенту, проверяет качество контента и распределяет данные по тематическим кластерам.
- Сохранение: формируется финальная индексная запись, которая добавляется в дата-центры для последующего ранжирования.
Это стандартный маршрут обработки документов. При этом у Яндекса и Google существуют отличия в распределении ресурсов на рендеринг.
А в чем помогает JS при индексации? Он помогает правильно понять вёрстку, расположение элементов, какие-то дополнительные блоки, которые работают только исключительно с JS. И тем самым позволяя давать поисковому роботу больше представления о странице.
Принципы индексации в Google и Яндексе
У разных поисковиков алгоритмы обработки контента различаются. Ниже разобраны основные технические особенности работы краулеров.
Краулинговый бюджет
Под краулинговым бюджетом понимают лимит страниц, которые бот просканирует за одно посещение. Показатель зависит от технических возможностей сервера (насколько быстро он отдает данные) и потребности ресурса в сканировании (частота обновления контента). Чем масштабнее проект, тем выше выделяемые лимиты.
У Яндекса работает динамический лимит. Он масштабируется в зависимости от размера структуры и отсутствия наложенных фильтров.
Исторически отечественный поисковик добавлял документы в базу медленнее, но сейчас разрыв сократился. При этом если Googlebot обрабатывает JS-фреймворки, Яндекс может их не сканировать, если отключен серверный рендеринг JS.
Два фактора, критично влияющих на расход краулингового бюджета:
- Скорость отклика сервера (TTFB): чем быстрее загружается HTML, тем больше URL робот успеет обойти за выделенную сессию. Медленный ответ приводит к снижению частоты визитов.
- Архитектура перелинковки: если до важного документа нужно сделать более трех кликов от главной, вероятность его быстрого обнаружения падает. Все значимые разделы должны присутствовать в Sitemap.xml.
Mobile-first indexing
С 2018 года Google использует мобильную версию как основную для оценки и ранжирования; переключения между мобильным и десктопным индексами нет.
Оценка адаптивности происходит через внутренний атрибут isSmartphoneOptimized. Алгоритм проверяет читаемость текста (шрифт не менее 12px), отсутствие горизонтального скролла и визуальную стабильность. Контент, скрытый в табах или подгружаемый скриптами без атрибута loading="lazy", часто теряется при мобильном сканировании. Потеря видимости текста на смартфонах каскадно снижает позиции во всех типах выдачи.
У Яндекса аналогичные функции выполняет алгоритм «Владивосток». Система учитывает удобство просмотра на малых экранах согласно официальным рекомендациям для вебмастеров.
Core Web Vitals
Метрики пользовательского опыта (Core Web Vitals) оценивают скорость отрисовки и интерактивность интерфейса. Для Google это первичные технические параметры доступности:
- LCP (Largest Contentful Paint): время отрисовки самого крупного элемента не должно превышать 2,5 секунды.
- INP (Interaction to Next Paint): задержка отклика на действия пользователя — строго до 200 мс.
- CLS (Cumulative Layout Shift): сдвиг макета при загрузке — не более 0,1.
Яндекс официально не заявляет CWV как фактор ранжирования, но алгоритмически пессимизирует ресурсы с долгой загрузкой и агрессивными рекламными блоками (кликандерами).
JavaScript SEO
Речь идет о проектах на React, Vue, Angular и сайтах, использующих JS для подгрузки товарных матриц или цен.
Важно: индексация JS-страниц у Google часто идёт в два этапа: сначала краулер получает HTML и ставит страницу в очередь, затем выполняет JS-рендеринг и дополняет данные. Это может занимать больше времени, чем индексация статичных страниц. Асинхронная очередь рендеринга бывает перегружена, что вызывает задержки в обновлении выдачи.
Яндекс обходит документы, открытые в robots.txt. Для управления процессом в панели вебмастера предусмотрен отдельный тумблер.
Здесь и далее скриншоты сделаны автором статьи в его аккаунтах.
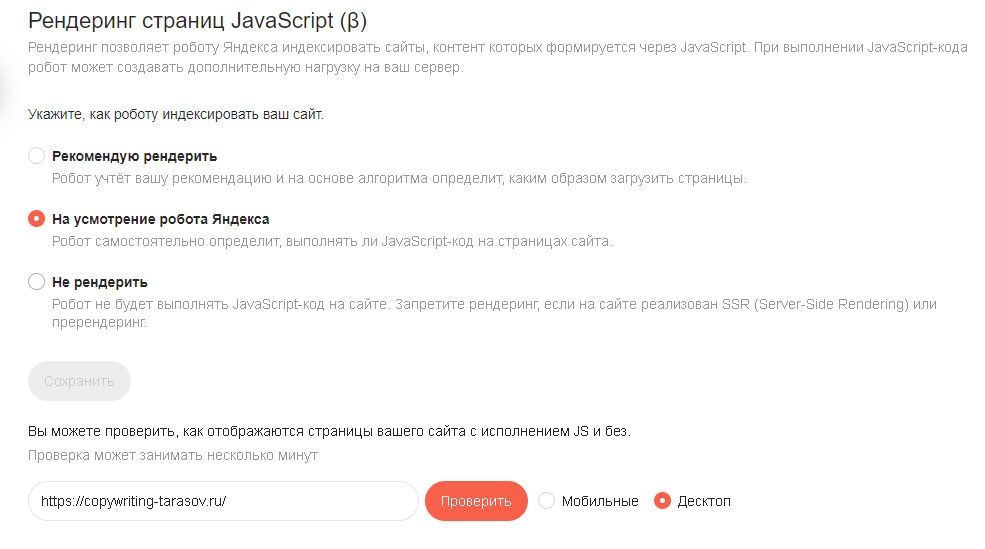
По умолчанию робот самостоятельно решает, запускать ли движок рендеринга. В настройках можно принудительно запретить или рекомендовать выполнение скриптов.
Принципы анализа контента
Системы используют разные сигналы для оценки текстовой релевантности. Google опирается на следующие принципы:
- оценка на уровне URL: каждый документ получает независимый скоринг.
- семантическая разметка: внедрение Schema.org (Article, FAQPage, DefinedTerm) ускоряет извлечение фактов.
- интент и контекст: нейросети анализируют Information Gain (уникальную ценность) и соответствие ожиданиям пользователя.
Яндекс первично ориентируется на мета-теги (Title, Description) и структуру заголовков H1-H6. При обнаружении дублей краулер склеивает их, оставляя в поиске наиболее авторитетный вариант.
Ранжирование и AI-ответы: индекс не равен позициям
Быть в индексе — необходимо, но недостаточно для трафика. Проиндексированные данные затем обрабатываются алгоритмами ранжирования и ИИ-модулями (Google SGE, «Яндекс Нейро»), формирующими контекстные ответы и расширенные сниппеты. Поэтому помимо технической доступности страницы важны качество и уникальность контента, E-E-A-T-сигналы и скорость мобильной версии — именно они повышают шанс попасть как в обычную выдачу, так и в AI-ответы. Вывод: критически важно добиваться быстрой переиндексации обновлений (цены, наличие, новости) и усиливать внутренние/внешние сигналы важности страницы.


Факторы E-E-A-T
Концепция E-E-A-T (Опыт, Экспертиза, Авторитетность, Достоверность) критична для YMYL-тематик (медицина, финансы, юриспруденция). Алгоритмы проверяют авторство, наличие ссылок на независимые исследования и отсутствие логических противоречий. Эти сигналы в первую очередь влияют на приоритет обхода и последующее ранжирование; на сам факт попадания в индекс первичны техническая доступность и качество контента.
Высокие оценки E-E-A-T генерируют позитивные поведенческие паттерны (goodClicks), что через систему NavBoost дает сигнал краулеру чаще переобходить домен.
Доверие, авторитетность — вот эти сигналы, которые аббревиатурой E-E-A-T обозначаются. «Яндекс» в этом соответствует и учитывает.
Выскажу субъективное мнение, так как замеров нет, но по всем докладам «Яндекса», по практике анализа выдачи, все-таки «Яндекс» смотрит на репутационное окружение бизнеса, причем в основном на своих сервисах.
Для Google тоже можно так сказать, поисковая система учитывает как представлен бизнес на ее площадках. Но, в Google все же уклон больше в траст доверия с точки зрения своей базы знаний об авторах, наличие трастовых ссылок.
Как настроить индексацию сайта
Современные веб-технологии часто создают барьеры для ботов. Для диагностики используйте инструменты «Проверка URL» в Google Search Console и «Анализ страниц» в Яндекс Вебмастере. Они показывают сырой HTML-код, который получает сервер поисковика.
Базовая настройка начинается с файла robots.txt. Большинство CMS генерируют его автоматически, но специалисту необходимо контролировать синтаксис.
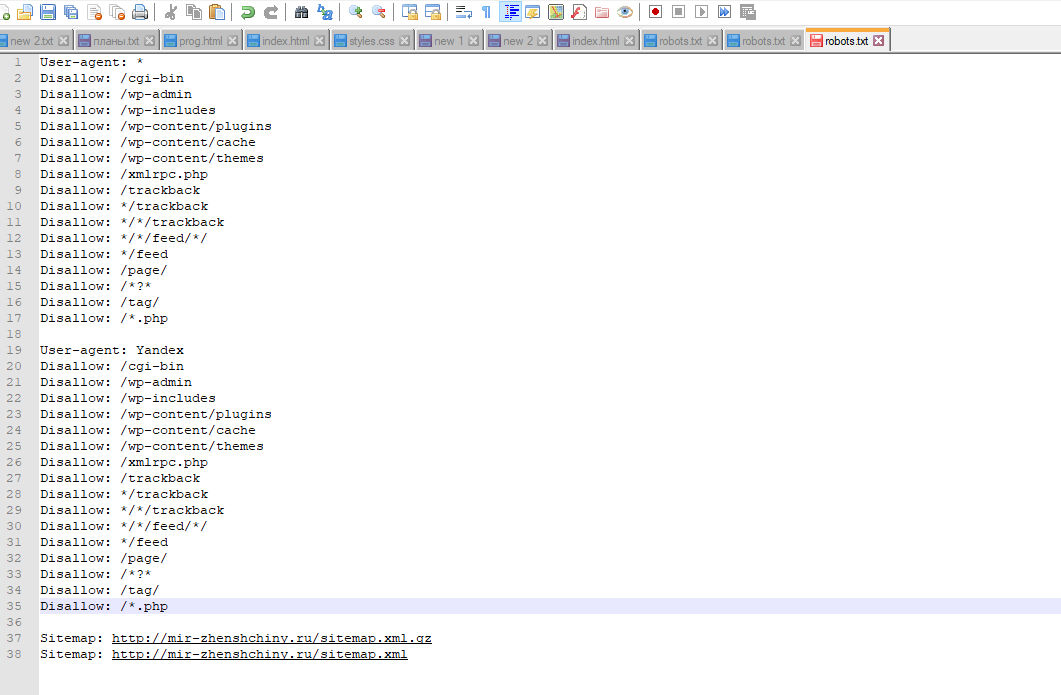
Директива Host устарела: Яндекс игнорирует ее с 2018 года, а Google никогда не учитывал. Ошибки в синтаксе (например, пробелы в начале строк) приводят к игнорированию всего файла.
|
Директива |
Зачем используется |
|
User-agent: |
указывает бота, для которого применяются правила ниже. |
|
Disallow: |
запрещает сканирование указанных разделов/страниц (не равно полному запрету индексации). |
|
Sitemap: |
содержит абсолютный путь к XML-карте. |
|
Clean-param: |
отсекает динамические параметры URL (UTM-метки, сортировки). |
|
Allow: |
открывает доступ к конкретным файлам внутри закрытой директории. |
|
Crawl-delay: |
задает таймаут между запросами (Google давно игнорирует эту команду). |
Ниже приведен базовый шаблон корректного robots.txt, с которого удобно начинать настройку нового проекта:
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Crawl-delay: 0
Примечание: Disallow: без путей ничего не блокирует; укажите реальный путь к вашей карте сайта.
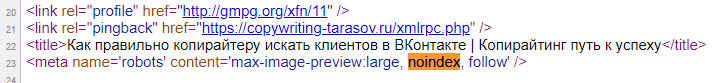
Чтобы запретить именно индексацию, используйте noindex в meta robots или X-Robots-Tag.
Более подробно о синтаксисе можно прочитать в справке Яндекса.
Следующий шаг — генерация sitemap.xml. Файл не должен превышать 50 Мб или содержать более 50 000 URL. При превышении лимитов создается индексный файл, объединяющий несколько карт.
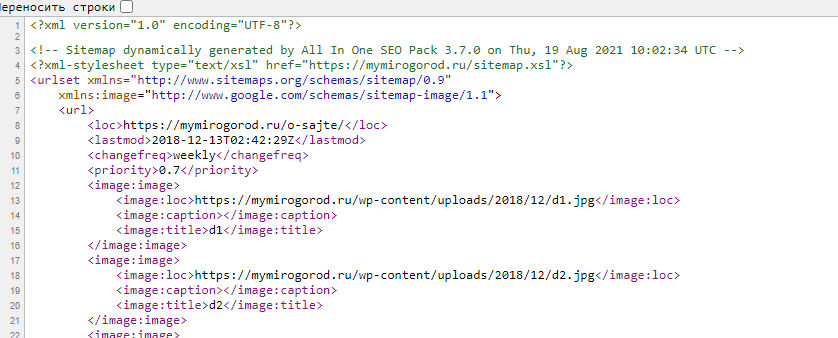
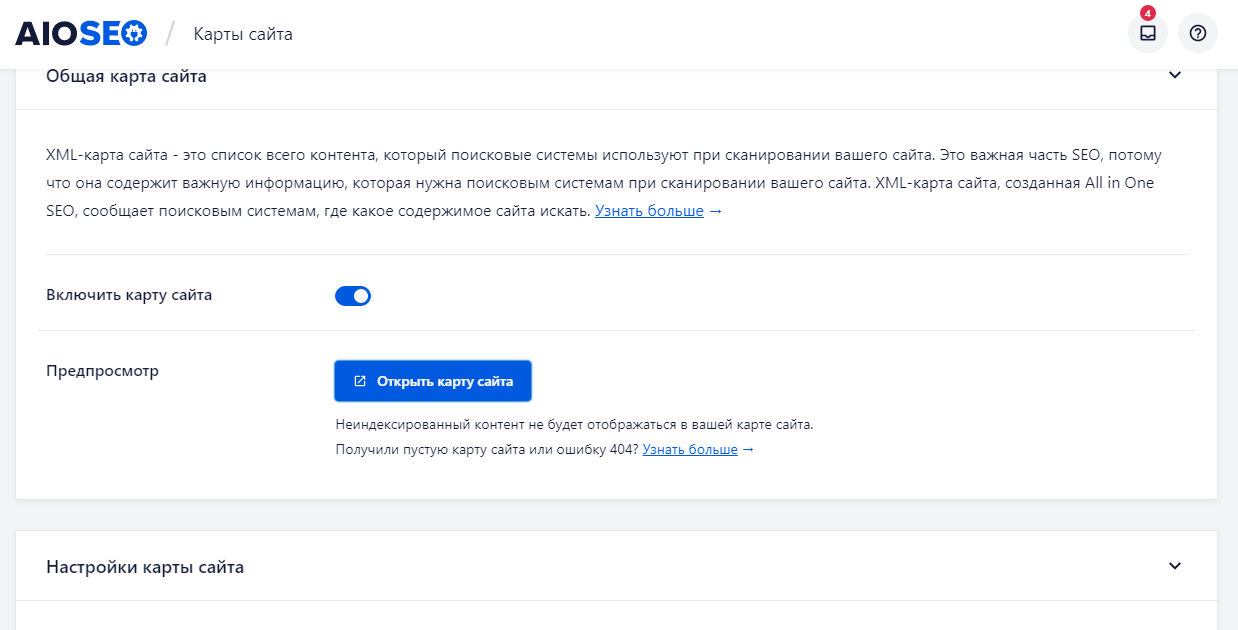
Для WordPress задача решается активацией соответствующей опции в SEO-плагинах (Yoast, AIOSEO).
Для управления на уровне HTML применяется тег <meta name="robots" content="index, follow">. Для файлов (PDF, DOC) или изображений настраивается HTTP-заголовок ответа сервера:
HTTP/1.1 200 OK
Date: Tue, 15 May 2025 21:32:43 GMT
X-Robots-Tag: noindex

Как ускорить индексацию сайта
Обычно новые URL появляются в выдаче через 20–40 минут. Однако при выходе из-под фильтров, запуске крупного e-commerce или низком трасте домена процесс затягивается. Для форсирования событий применяют следующие инструменты:
- Google Indexing API: позволяет программно отправлять пакеты URL напрямую в базу. Оптимально для сайтов вакансий и новостных порталов.
- IndexNow: протокол мгновенного оповещения поисковых систем об изменениях на сайте (поддерживается, в т.ч., «Яндексом»). Использование IndexNow помогает ускорить обнаружение и индексацию новых или обновлённых страниц.
- ручной переобход: отправка единичных адресов через консоли вебмастеров. Имеет жесткие суточные лимиты.
- оптимизация скорости: снижение веса DOM-дерева и сжатие изображений высвобождает ресурсы краулера.
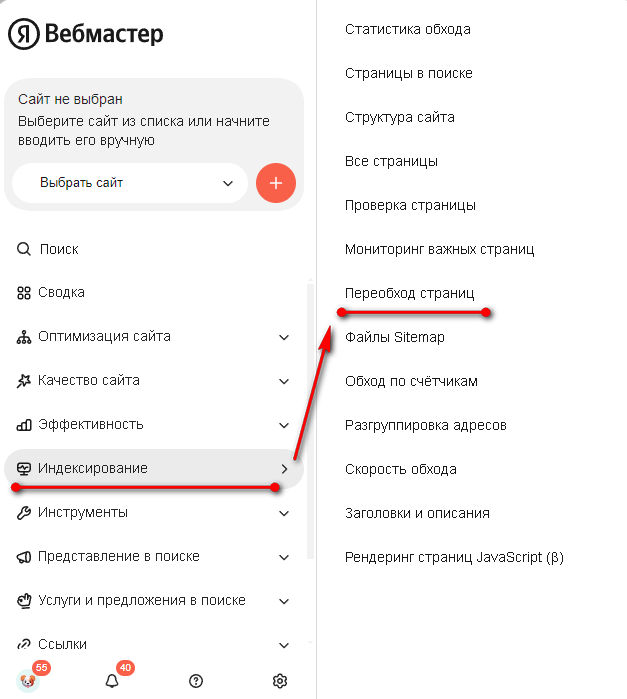
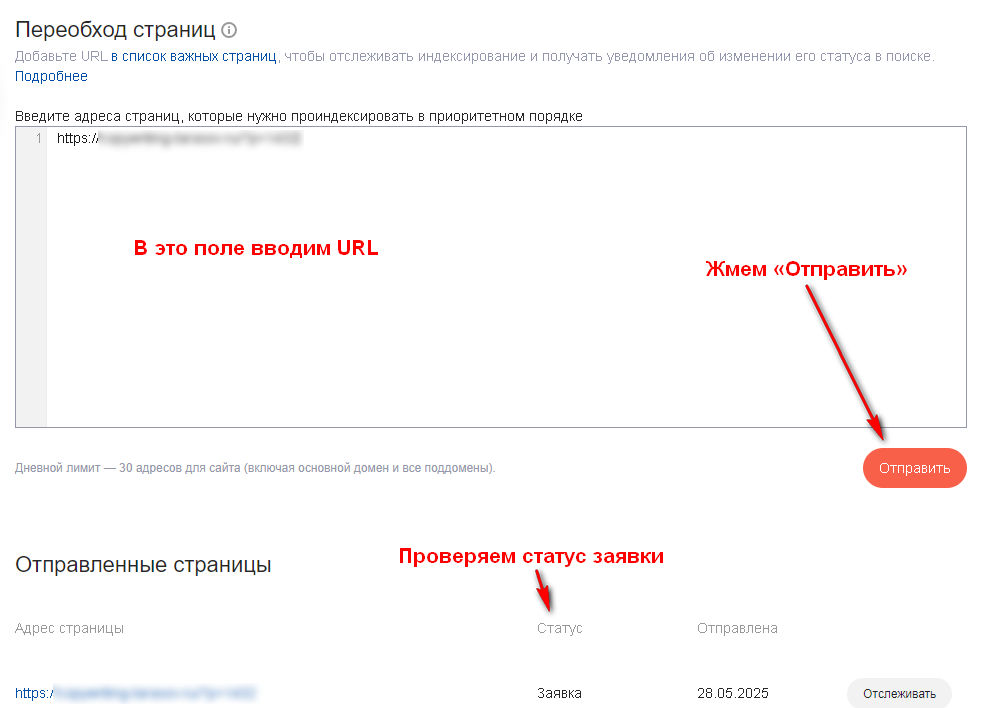
В Яндекс Вебмастере инструмент находится в разделе «Индексирование» — «Переобход страниц».
Вводим абсолютный адрес и отслеживаем статус в таблице ниже.
Подключение обхода по счетчику Метрики — спорное решение. Бот начнет сканировать корзины, страницы авторизации и сортировки, расходуя лимиты впустую.
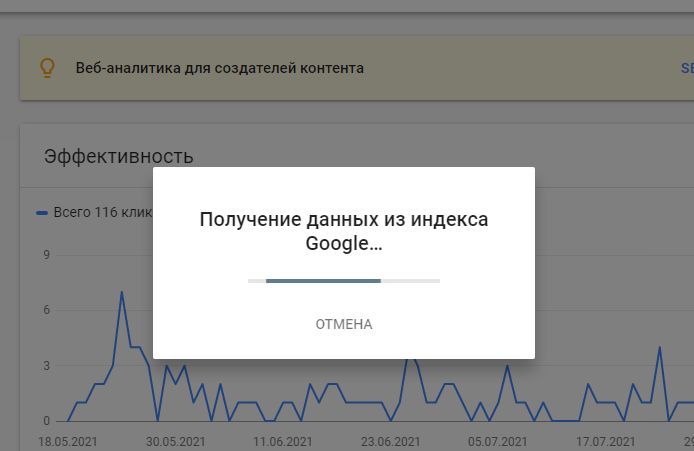
В Google Search Console процесс запускается через строку поиска в верхней части интерфейса.
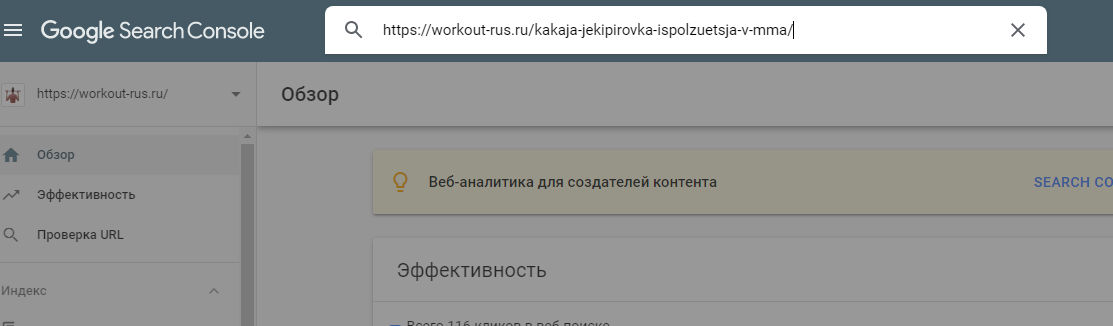
Система выполняет быструю проверку доступности.
После анализа формируется отчет о текущем статусе.
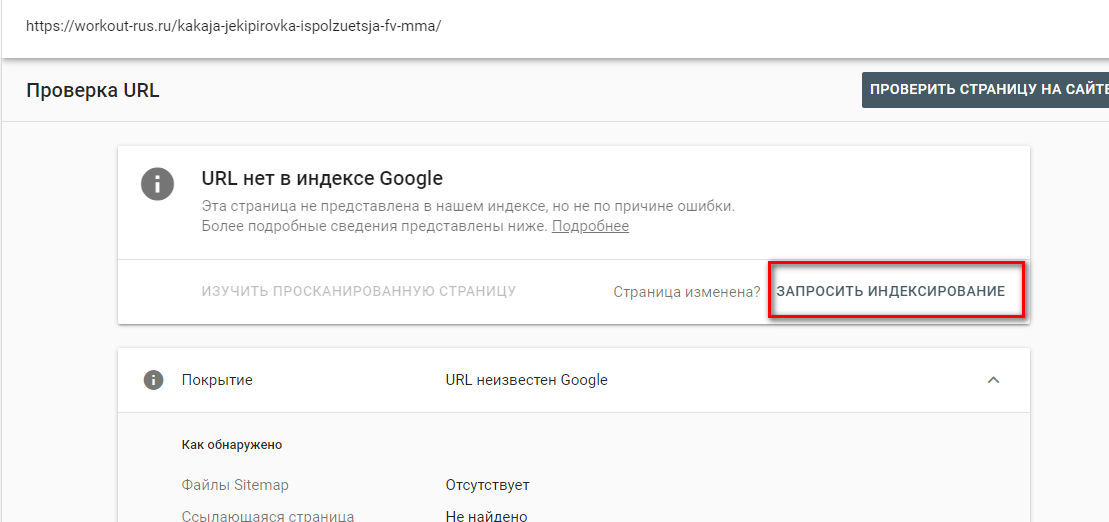
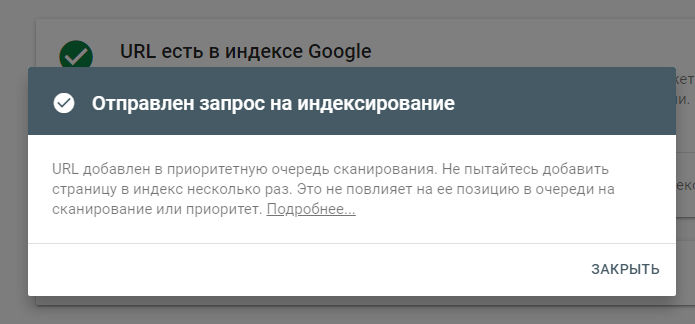
Нажимаем «Запросить индексирование».
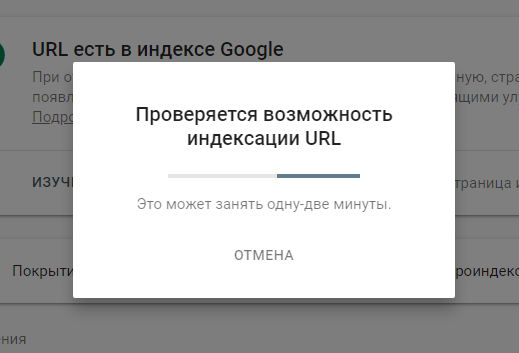
Успешная отправка подтверждается всплывающим окном.
Размещение ссылок в социальных сетях (X/Twitter) утратило былую эффективность. Основной драйвер — качественная внутренняя перелинковка и внешние трастовые бэклинки.
Теперь по пунктам.
Настройте сканирование. Правильная настройка файла robots.txt ускоряет процесс переобхода.
Настройте приоритезацию обхода нужных страниц. Это делается в файле индекса или в карте сайта sitemap.xml. Так вы покажете поисковым роботам какие страницы нужно обходить в первую очередь.
Отправить страницы на переобход. В «Яндекс Вебмастер» инструмент так и называется «Переобход страниц», в Google Search Console есть возможность отправить URL на переобход через форму вверху страницы сервиса. Если страниц много, то для Google можно воспользоваться инструментом Indexing API.
Даем сигналы что страница важная. Для этого на документ должны вести ссылки с главной страницы. Добавьте внешние ссылки, желательно с трастовых ресурсов.
Размер файлов. Если документ у вас тяжелый, то поисковые роботы в целях экономии ресурсов будут обходить их в последнюю очередь. Поэтому, для ускорения индексации необходимо ускорять загрузку страниц сайта.
Правильная перелинковка. Нужно делать ссылки внутри сайта так, чтобы поисковый робот находил их в первую очередь. Естественно внешние ссылки тоже ускоряют процесс индексации.
Как запретить индексирование
Исключение мусорных URL из базы — обязательная рутина SEO-специалиста. Закрывать необходимо:
- результаты внутреннего поиска по сайту (генерируют бесконечное число дублей).
- страницы пагинации глубоких уровней.
- тестовые поддомены и посадочные под контекстную рекламу.
- документы с конфиденциальными данными.
Точечное закрытие через мета-теги
Оптимальный метод для удаления конкретного URL. В блок <head> добавляется директива: <meta name="robots" content="noindex, follow" />. Бот перейдет по ссылкам, но сам документ в базу не добавит.

Работа с robots.txt
Критическое правило: никогда не комбинируйте Disallow в robots.txt с noindex в HTML. Если раздел заблокирован от сканирования, Google присваивает ему флаг isRoboted и перестает заходить на страницу. В результате краулер просто не увидит ваш тег noindex, и URL останется в выдаче с пометкой «Описание недоступно».
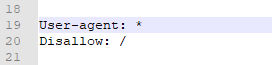
Для блокировки конкретного бота прописывается его точный User-agent.
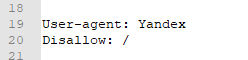
Удаление контента со статусом 404/410
Код 404 означает «Не найдено», 410 — «Удалено навсегда». Яндекс обрабатывает их одинаково: URL постепенно выпадает из базы при отсутствии внешних ссылок. Google реагирует на 410 статус мгновенным удалением из индекса, тогда как при 404 ошибке дает сутки на восстановление, прежде чем запустить процесс деиндексации.
Распространенные ошибки индексирования
Технические недочеты способны обрушить трафик до нуля. Проверьте проект по этому чек-листу:
- блокировка CSS/JS: запрет доступа к стилям и скриптам лишает Google возможности отрендерить макет и оценить Core Web Vitals.
- случайный Disallow: / : один лишний слеш блокирует весь домен.
- ошибки в Sitemap: наличие битых ссылок или редиректов внутри XML-карты снижает доверие краулера к файлу.
- цепочки редиректов: множественные перенаправления 301/302 обрывают сканирование (лимит бота — 5 прыжков).
- ошибки сервера (5xx): регулярные таймауты заставляют системы снижать частоту обхода.
- отсутствие каноникализации: генерация дублей без атрибута rel="canonical" размывает ссылочный вес.
- каннибализация URL: конкуренция нескольких страниц за один интент приводит к постоянной смене релевантного документа в выдаче.
Как проверить индексацию сайта
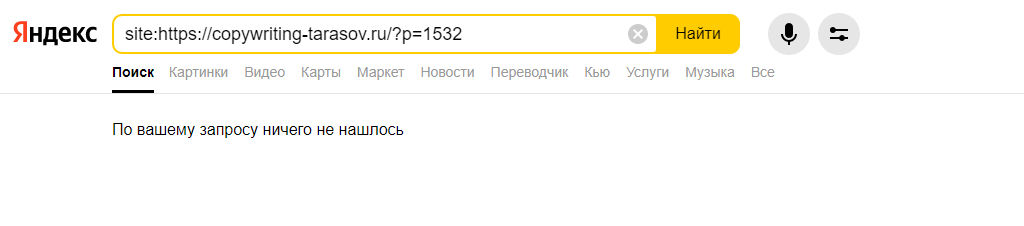
Базовая проверка выполняется через поисковый оператор site:example.com/url. Это дает примерное понимание картины.
| Инструмент | Что показывает | Массовая проверка | Диагностика причин |
|---|---|---|---|
| Поисковый оператор site: | Примерное наличие URL в индексе | Нет | Нет |
| Google Search Console (отчёт «Индексирование страниц») | Статусы: «в индексе», «исключено», «просканировано, но не проиндексировано» | Да | Да (причины, логи краулера Google) |
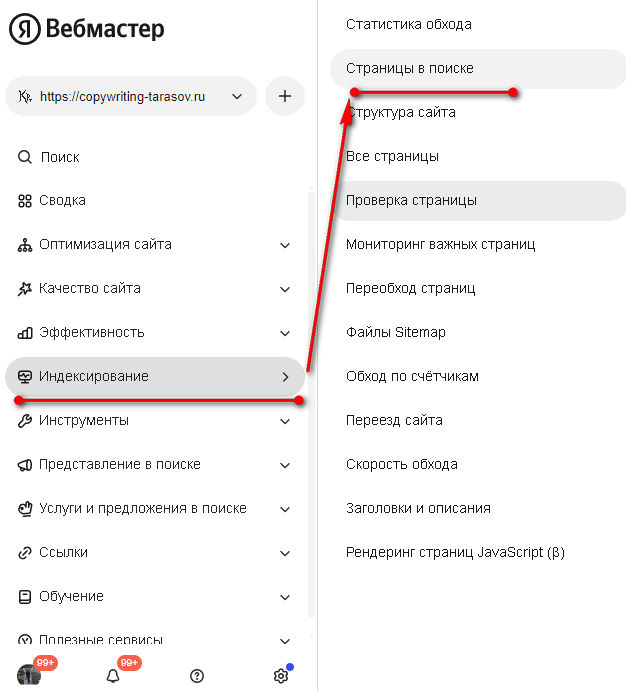
| «Яндекс Вебмастер» («Страницы в поиске») | Статусы и причины исключения | Да | Да |
| Логи веб-сервера | Факт визитов ботов по разделам/URL | Да (через парсинг логов) | Косвенно (по кодам ответов/таймаутам) |
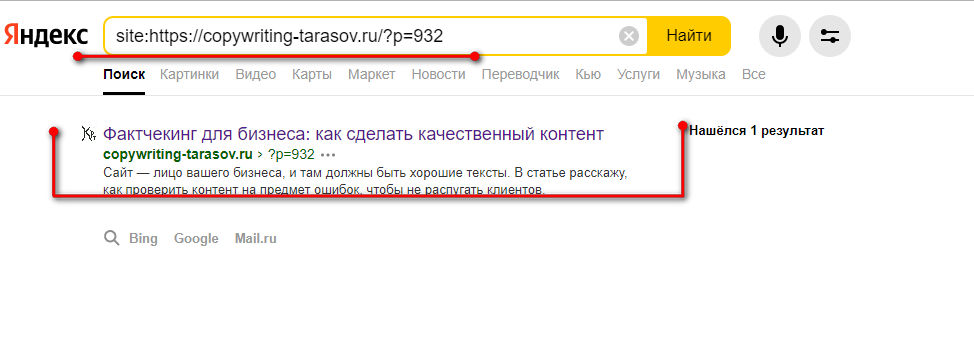
Если документа нет в базе, выдача будет пустой.
В Яндекс Вебмастере перейдите в раздел «Страницы в поиске».
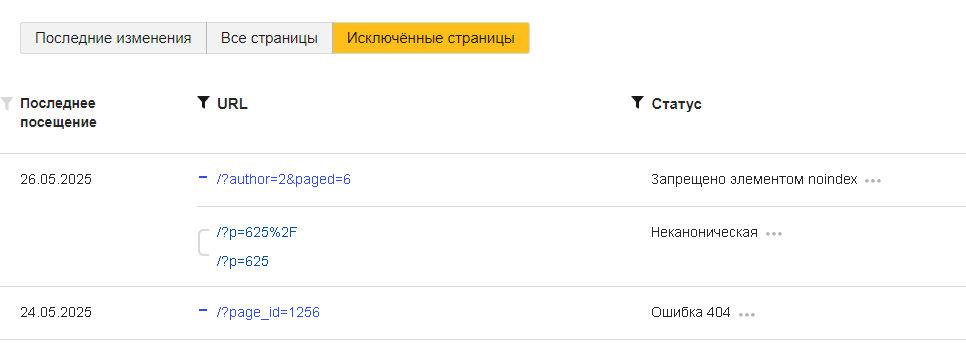
Вкладка «Все страницы» отображает дату последнего визита бота и текущий статус.
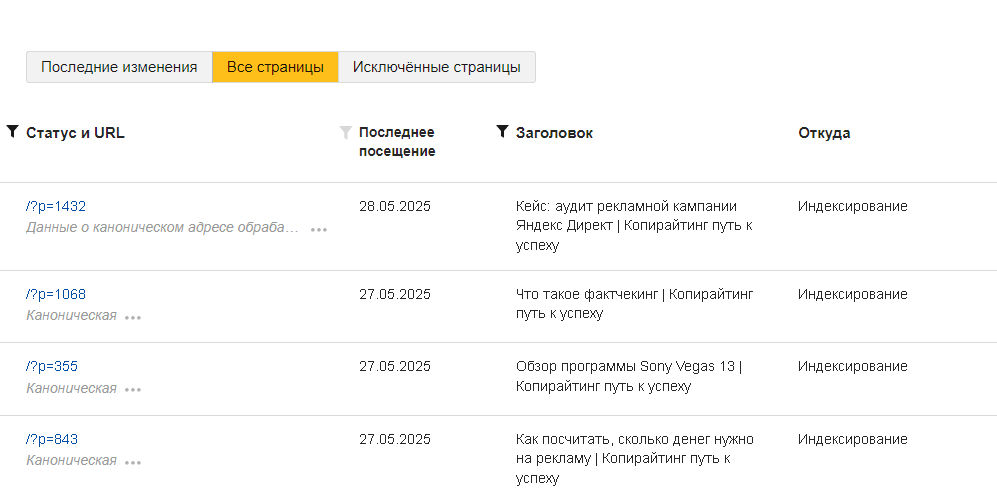
Особое внимание уделите вкладке «Исключенные страницы». Здесь фиксируются ошибки 404, дубли и документы, заблокированные в robots.txt.
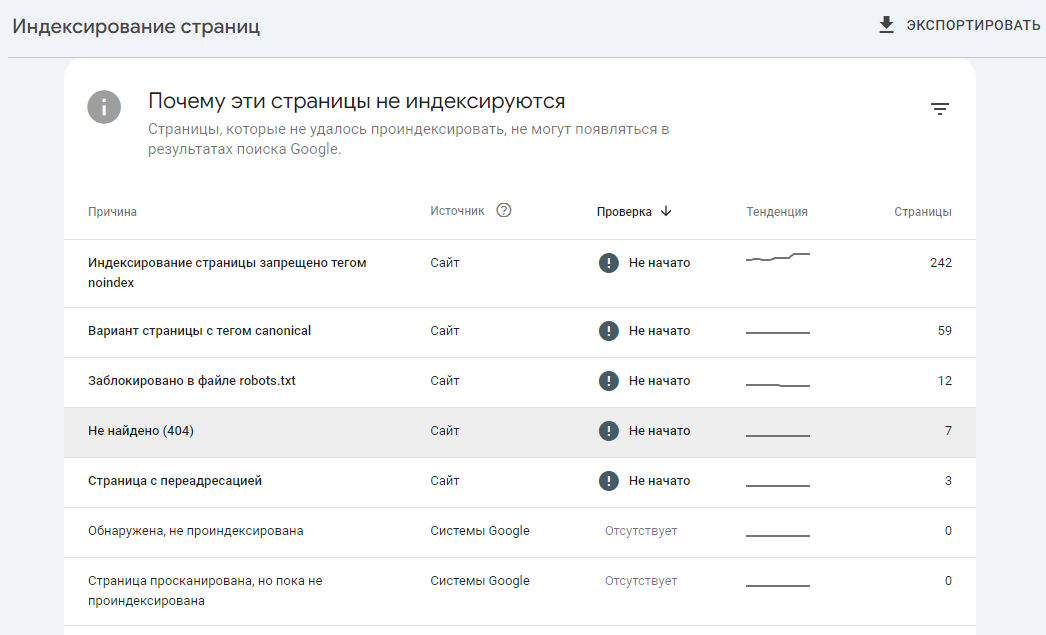
В GSC аналогичный функционал доступен в отчете «Индексирование страниц». Статус «Просканировано – в настоящее время не проиндексировано» означает, что бот нашел URL, но посчитал контент недостаточно ценным для добавления в базу.
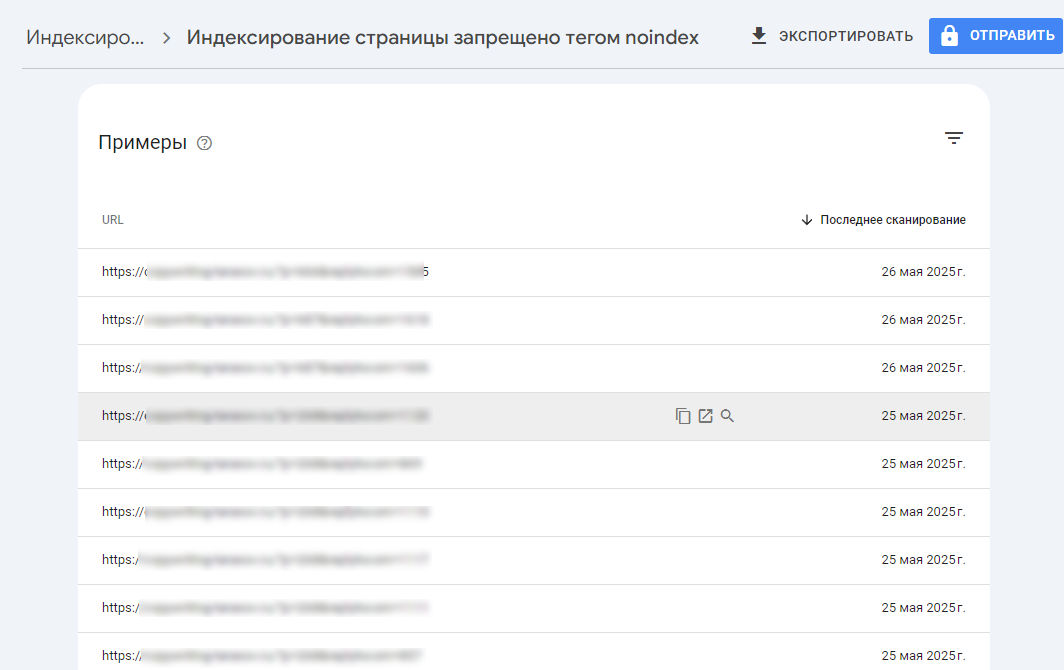
Клик по конкретной ошибке открывает детализацию с примерами проблемных адресов.
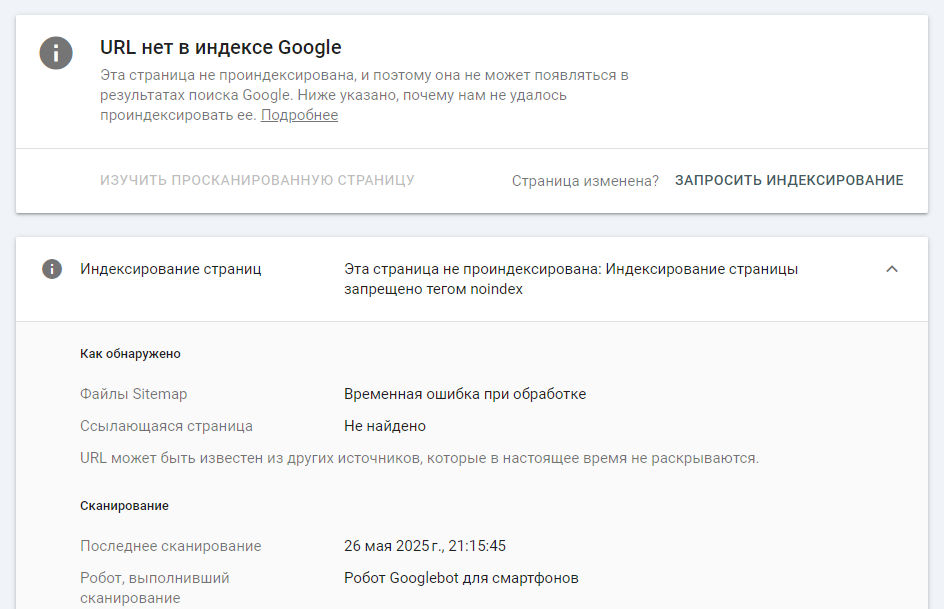
Инструмент позволяет запустить валидацию после исправления недочетов.
Ключевое отличие панелей от логов сервера: Вебмастер показывает взгляд поисковика на сайт, а логи (через ELK Stack или GoAccess) демонстрируют техническую реальность. Анализ логов выявляет аномалии, таймауты и реальную частоту визитов краулеров.
FAQ по индексации сайтов
Яндекс Вебмастер не может найти robots.txt. Что делать?
Проверьте права доступа на сервере. Часто файл блокируется на уровне .htaccess или Nginx. Изучите логи сервера на предмет кодов ответа при обращении к корню сайта.
В GSC появился запрет noindex, а в Яндексе все хорошо. Как быть?
Вероятно, в коде прописан целевой запрет именно для Googlebot. Проверьте исходный код на наличие конструкции <meta name="googlebot" content="noindex">.
Что делать, если дубли попадают в Sitemap.xml?
Настройте генерацию карты сайта так, чтобы в нее попадали только канонические URL со статусом 200. Наличие мусора в XML-карте расходует краулинговый бюджет впустую.
Коротко о главном
Техническая доступность ресурса определяет его коммерческий успех. Без попадания в базу поисковиков любые работы по контенту и ссылкам бессмысленны. Подведем итоги:
- скорость отклика сервера и отсутствие блокировок в robots.txt — базовые условия для сканирования.
- мобильная версия является приоритетной для Google; ошибки адаптивности пессимизируют весь домен.
- протокол IndexNow и Indexing API позволяют форсировать добавление новых URL.
- для полного удаления документа из выдачи используйте мета-тег noindex, а не директиву Disallow.
- регулярный мониторинг отчетов в GSC и Яндекс Вебмастере предотвращает массовое выпадение страниц.
.png)
.png)



Комментарии (8)
Оставить комментарий