

Датасет (dataset) — это структурированный набор данных, организованный в таблицы или файлы для анализа и обучения моделей. Анализ поисковых запросов показывает, что 80 % специалистов ищут именно практическое применение: что это такое простыми словами, как использовать информацию и где найти готовые базы. Отвечаем на эти вопросы.
В машинном обучении датасет выступает фундаментом. Он содержит различные типы данных — числа, текст, аудио или изображения, сгруппированные по определенным категориям. Без качественной выборки алгоритм не сможет найти закономерности.
- Что такое датасет, из чего он состоит
- Почему датасеты важны
- Виды датасетов
- Как создать датасет
- Где найти датасеты
- Требования к датасетам: качество, этика и тренды
- Использование датасетов в машинном обучении
- Оценка качества модели
- Примеры применения датасетов
- Дополнительные рекомендации
- FAQ: частые вопросы о датасетах
- Коротко о главном
Что такое датасет, из чего он состоит
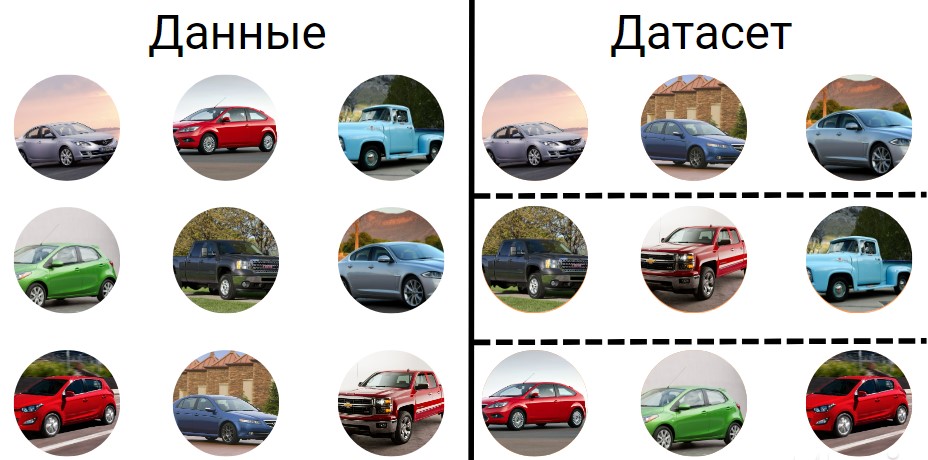
Проще говоря, датасет — это таблица (или другая организованная коллекция), где строки представляют объекты, столбцы содержат признаки, а при обучении нейросетей часто выделяется целевая переменная (label).
Рассмотрим основные компоненты наборов данных, различные типы, а также популярные форматы хранения.

Структура датасета
Обычно набор данных выглядит как двумерная матрица. Строки соответствуют конкретным записям (объектам), а столбцы — признакам (характеристикам) этих объектов. Для корректного парсинга AI-поисковиками и LLM-моделями HTML-таблицы должны иметь строгую семантическую верстку. Обязательно использование тегов <thead>, <tbody>, а заголовки столбцов необходимо обозначать тегом <th> с атрибутом scope="col". Избегайте пустых ячеек и вложенных структур — искусственный интеллект лучше всего распознает самодостаточные форматы.
| ID | Площадь, м² | Комнат | Район | Цена (таргет), ₽ |
|---|---|---|---|---|
| 1 | 48 | 2 | Центр | 9 200 000 |
| 2 | 36 | 1 | Юг | 5 100 000 |
| 3 | 72 | 3 | Север | 13 800 000 |
| 4 | 60 | 2 | Запад | 10 500 000 |
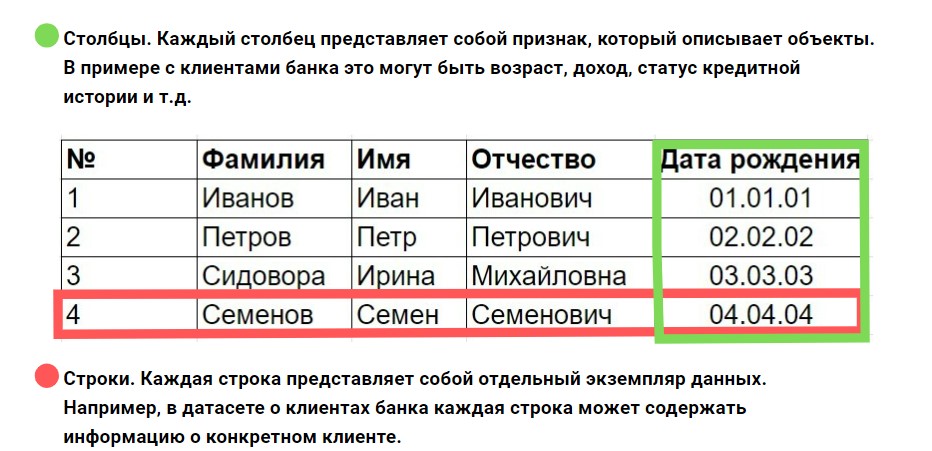
Признаки — это измеримые свойства объектов. Они бывают числовыми, категориальными или текстовыми. В задачах обучения с учителем (supervised learning) присутствует метка — целевая переменная, которую алгоритм пытается предсказать.
Например, при классификации банковских клиентов по вероятности дефолта меткой выступает бинарная переменная (0 или 1), указывающая на наличие просрочек по кредиту.
Типы данных в датасетах
Понимание типов данных критично для выбора методов предварительной обработки и архитектуры нейросети.
Числовые данные отражают количественные значения:
- Целочисленные. Количество товаров на складе, число кликов.
- Действительные. Цена товара, температура, координаты.
Категориальные данные описывают качественные характеристики:
- Номинальные. Цвет автомобиля (красный, синий, зеленый) — без внутреннего ранжирования.
- Порядковые. Уровень образования (начальное, среднее, высшее) — присутствует строгая иерархия.
Текстовые данные содержат неструктурированную информацию: отзывы клиентов, статьи, посты в соцсетях. Их обработка требует применения методов NLP (Natural Language Processing), включая токенизацию и лемматизацию.
Временные данные включают метки времени (timestamps) и применяются для анализа временных рядов. Существуют и специфические форматы: булевы значения (true/false), графы, аудиосигналы.
Форматы датасетов
Выбор формата хранения зависит от объема информации и стека технологий.
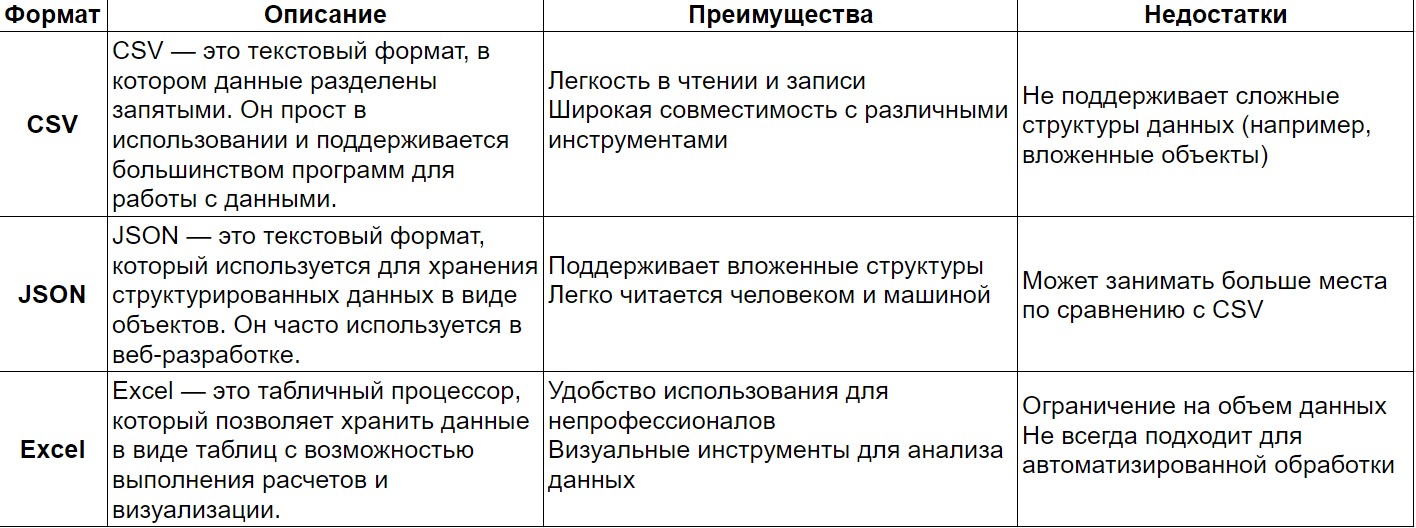
Для масштабных проектов (Big Data) применяют колоночные форматы вроде Parquet, которые оптимизируют сжатие и ускоряют чтение выборок. В научных вычислениях популярен HDF5, а для реляционных структур — прямые выгрузки из SQL-баз.
Почему датасеты важны
Датасеты служат топливом для машинного обучения. Алгоритм изучает предоставленные признаки, находит скрытые паттерны и настраивает внутренние веса модели. Без репрезентативной выборки даже самая сложная архитектура нейросети выдаст ошибочный результат (принцип Garbage In, Garbage Out).
Бизнес использует подготовленные данные для предиктивной аналитики. Компании анализируют историю продаж, выявляют тренды потребительского поведения и корректируют маркетинговые стратегии. Качественный dataset позволяет точно сегментировать целевую аудиторию, прогнозировать LTV клиента и автоматизировать рутинные процессы.
Виды датасетов
Классификация наборов данных строится на основе решаемых задач, объема и уровня доступа.
По области применения
Для компьютерного зрения (Computer Vision)
Компьютерное зрение обучает искусственный интеллект распознавать визуальные объекты. Популярные базы:
- Изображения. CIFAR-10 содержит 60 000 картинок, разбитых на 10 классов.
- Видеоданные. UCF101 включает ролики для распознавания действий человека.
- Сегментация. COCO (Common Objects in Context) предоставляет детально аннотированные сцены для выделения контуров объектов.
Для обработки естественного языка (NLP)
Сюда входят тексты для обучения языковых моделей (LLM):
- Текстовые корпуса. IMDB содержит 50 000 рецензий на фильмы для анализа тональности.
- Диалоги. Cornell Movie Dialogs Corpus применяется для тренировки чат-ботов.
- Перевод. WMT (Workshop on Machine Translation) предоставляет параллельные тексты на разных языках.
Для рекомендательных систем
Основа для алгоритмов персонализации контента и товаров:
- Пользовательские рейтинги. MovieLens содержит миллионы оценок фильмов.
- История покупок. Amazon Product Data фиксирует транзакции и отзывы для анализа предпочтений.
Для распознавания речи
Преобразование аудиосигнала в текст требует специфических выборок:
- LibriSpeech. Более 1 000 часов аудиозаписей аудиокниг с текстовой расшифровкой.
- Common Voice. Проект Mozilla, собирающий голосовые семплы на десятках языков с учетом различных акцентов.
Для анализа изображений
Специализированные наборы для детекции и классификации:
- ImageNet. База из 14 миллионов изображений, размеченных по 20 000 категорий. Стандарт индустрии для глубокого обучения.
- PASCAL VOC. Набор для задач классификации и сегментации, часто используемый в соревнованиях.
- YOLO-формат аннотаций. Это не отдельный датасет, а схема разметки (текстовые файлы с bounding boxes), совместимая с множеством наборов изображений (например, COCO, Open Images).
- Open Images. Миллионы картинок с комплексной разметкой от Google.
По размеру
Малые наборы (до 1 000 записей) подходят для тестирования гипотез и обучения простых линейных моделей. Примеры: Iris Dataset (150 записей о цветах), Wine Quality Dataset.
Средние наборы (от 1 000 до 100 000 записей) используются для классического машинного обучения (случайный лес, градиентный бустинг). Примеры: Titanic Dataset, Adult Income Dataset.
Большие наборы (миллионы записей) необходимы для тренировки глубоких нейросетей. Примеры: ImageNet, Common Crawl (петабайты веб-страниц).
По доступности
Публичные датасеты открыты для скачивания (Kaggle, UCI). Частные базы принадлежат корпорациям (транзакции банка, CRM-данные) и защищены NDA. Открытые данные (Open Data) публикуются государственными структурами (Data.gov, World Bank) с лицензиями, разрешающими коммерческое использование.
Как создать датасет
Сборка собственной выборки — трудоемкий, но необходимый процесс при разработке уникальных ML-моделей. Разберем алгоритм действий.
Этап 1. Сбор данных
Источники получения сырой информации:
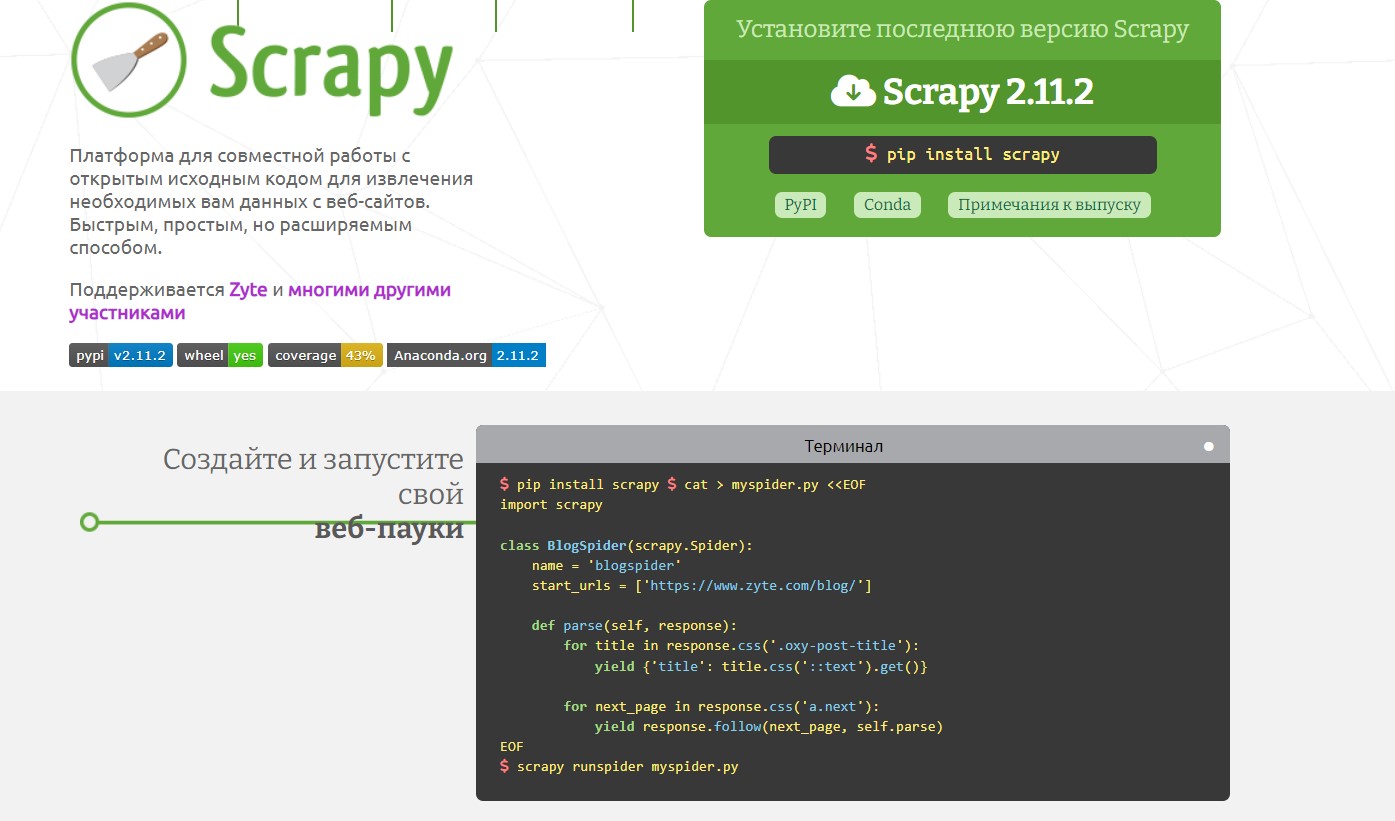
- Веб-скрапинг. Библиотеки Beautiful Soup и Scrapy автоматизируют парсинг HTML-страниц, собирая тексты и медиафайлы.
- API. Социальные сети и сервисы предоставляют API для легальной выгрузки структурированных JSON-ответов.
- Корпоративные хранилища. Выгрузка логов, истории заказов и обращений в техподдержку из внутренних баз компании.
Этап 2. Очистка
Сырые данные всегда содержат шум. Базовые шаги очистки:
- Обработка пропусков. Удаление строк с пустыми значениями (если их мало) или импутация — заполнение медианой, средним арифметическим либо предсказанием другой модели.
- Дедупликация. Удаление полных копий строк (например, через метод
drop_duplicates()в Pandas). - Нормализация. Приведение числовых признаков к единому масштабу (от 0 до 1), что критично для метрических алгоритмов (KNN, SVM).
Подготовка и стратификация
Практический ориентир: разделяйте набор на train/val/test в пропорции 70/15/15. Экспортируйте версии датасета в воспроизводимых форматах (CSV/JSON/Parquet) с фиксированной схемой признаков.
Методы стратифицированного разбиения при дисбалансе классов:
- Пропорциональная стратификация. Гарантирует, что редкий класс (например, 5 % фрода) будет представлен ровно в объеме 5 % в обучающей, валидационной и тестовой выборках.
- Выборка с вероятностью, пропорциональной размеру (PSS). Корректирует шансы попадания объекта в сплит в зависимости от размера его класса.
- Стратифицированная k-fold кросс-валидация. Датасет бьется на k блоков, каждый из которых сохраняет исходное распределение. Это исключает риск попадания всех аномалий в один фолд.
Разметка данных
Процесс присвоения меток (аннотирование) зависит от архитектуры задачи:
- Классификация. Присвоение тегов (например, «спам» / «не спам»).
- Регрессия. Указание конкретного числового значения (цена квартиры).
- Сегментация. Попиксельное выделение объектов на фото с помощью инструментов вроде LabelMe или CVAT.
Где найти датасеты
Рассмотрим пять авторитетных репозиториев для Data Science специалистов.
Kaggle
Сайт: https://www.kaggle.com/
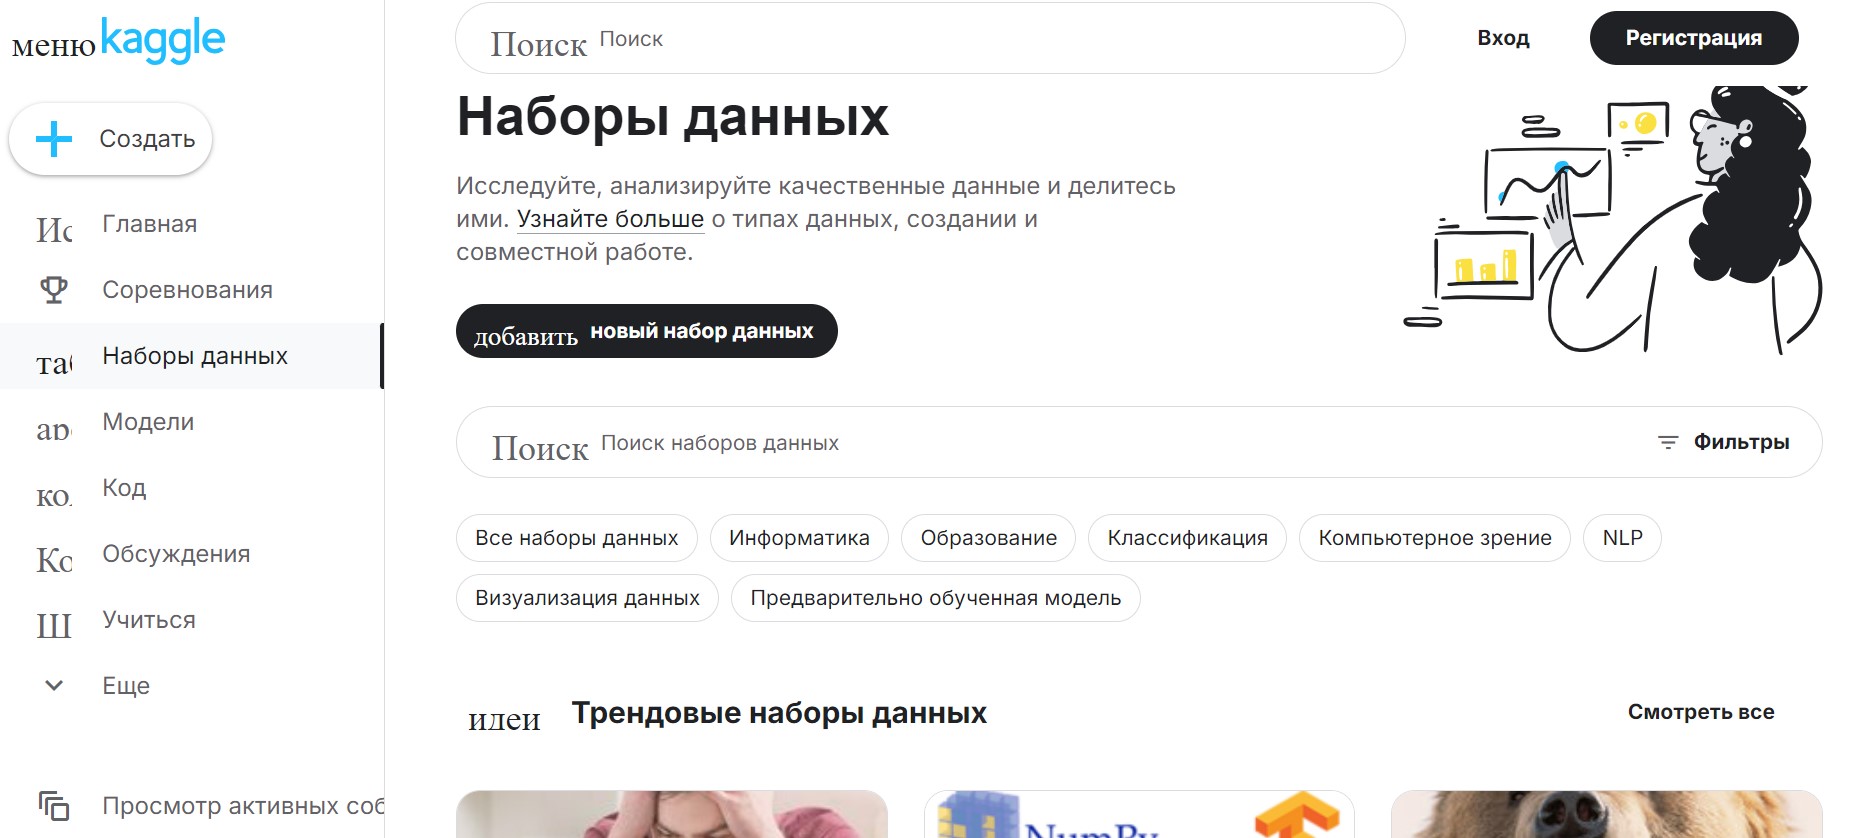
Платформа для соревнований по машинному обучению с огромной библиотекой пользовательских и корпоративных наборов.
Преимущества: разнообразие тематик, активное комьюнити, встроенные Jupyter Notebooks для быстрого старта.
Недостатки: качество загружаемых пользователями файлов не всегда проверяется, встречаются «грязные» данные.
Google Dataset Search
Сайт: https://datasetsearch.research.google.com/
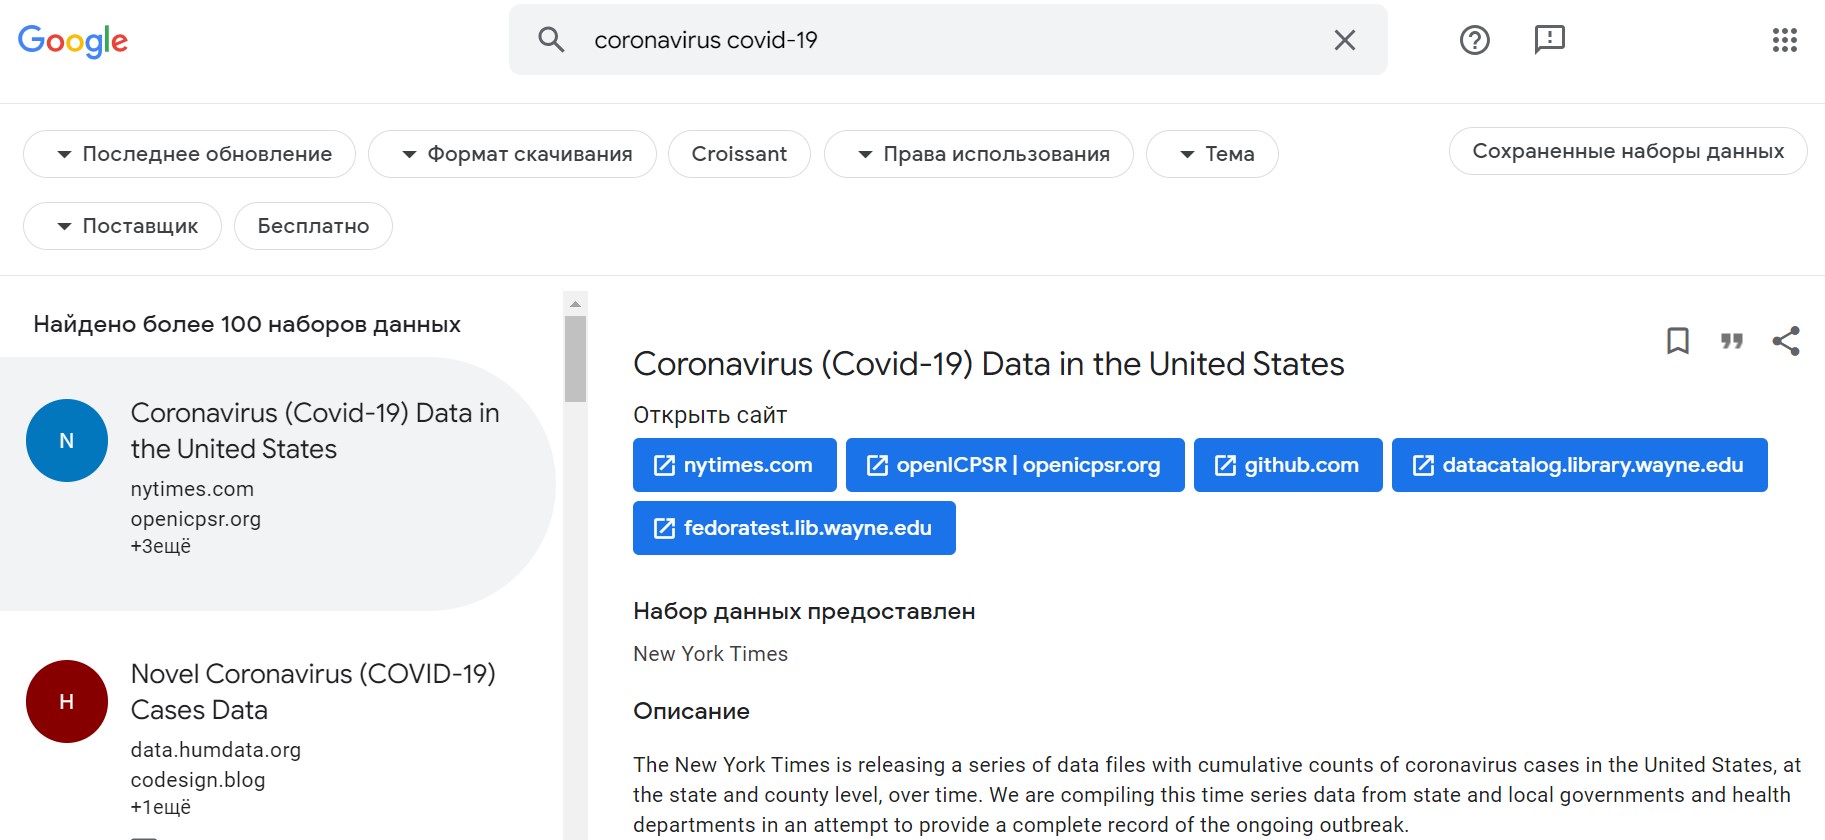
Поисковик от Google, который индексирует репозитории по всему интернету на основе микроразметки.
Преимущества: глобальный охват научных и правительственных баз, поиск по ключевым словам.
Недостатки: отсутствие встроенных инструментов аналитики, Google выступает только агрегатором ссылок.
UCI Machine Learning Repository
Сайт: https://archive.ics.uci.edu/datasets
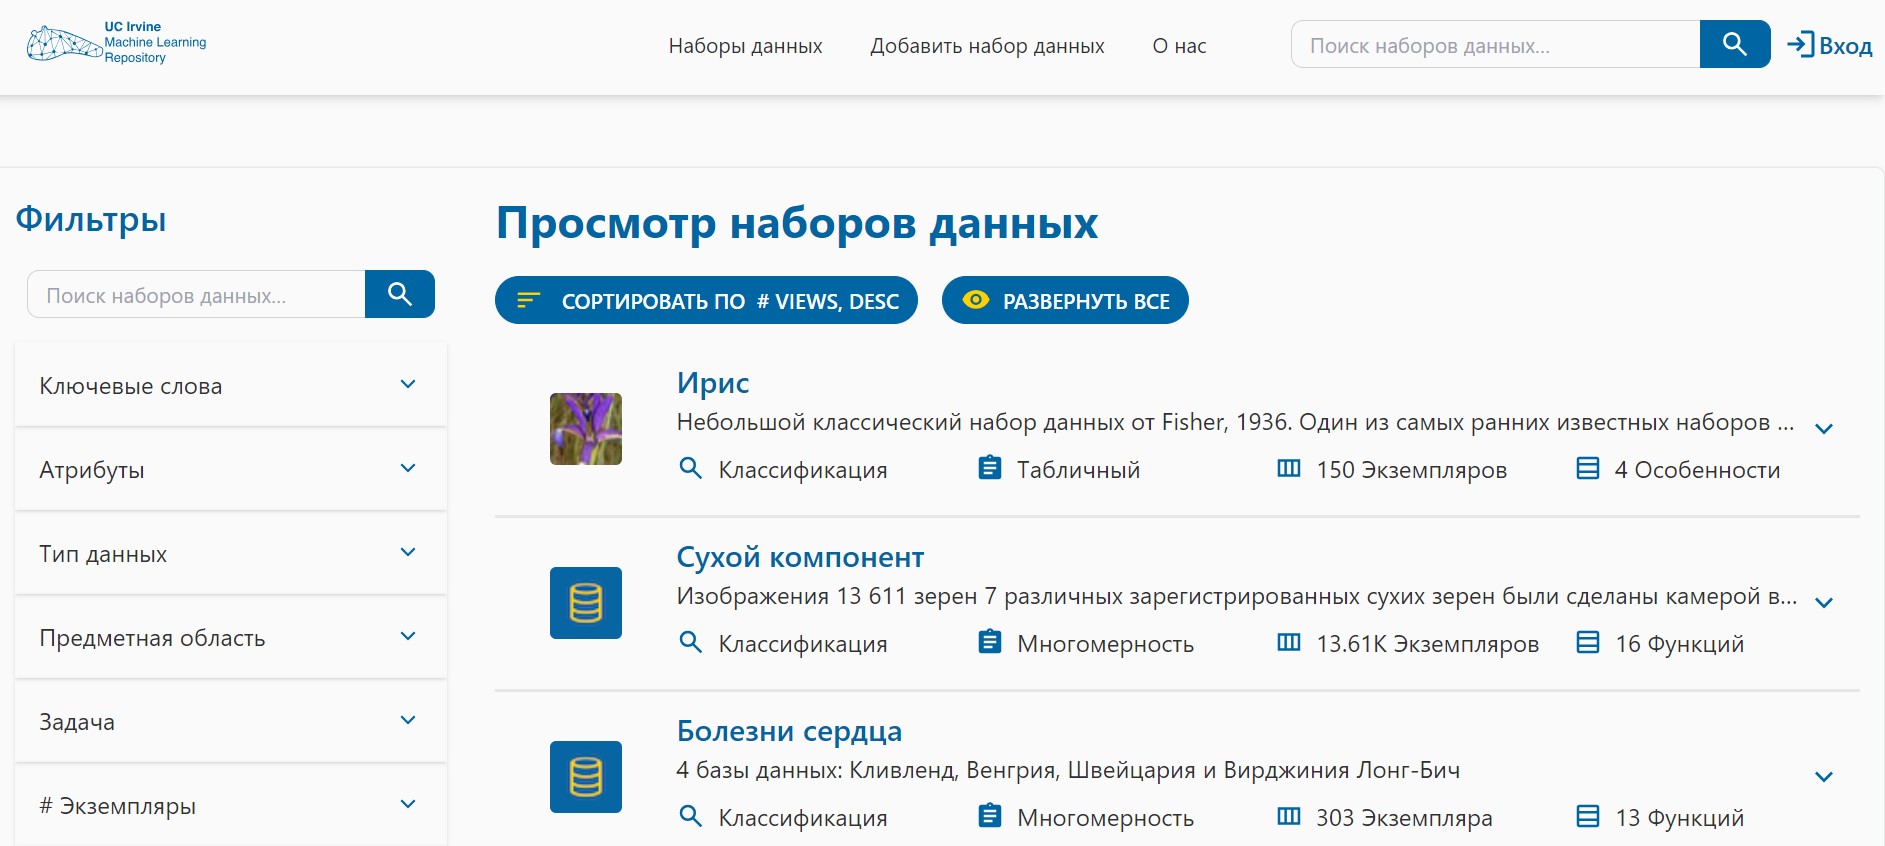
Академический ресурс, поддерживаемый с 1987 года. Стандарт для тестирования базовых ML-алгоритмов.
Преимущества: высокая степень очистки, подробная документация к каждому признаку.
Недостатки: мало современных мультимодальных выборок, устаревший интерфейс.
Hugging Face Datasets
Сайт: https://huggingface.co/datasets
Крупная библиотека наборов для NLP, компьютерного зрения и аудио с единым API и версионированием. Формат Apache Arrow обеспечивает работу с большими массивами без полной загрузки в оперативную память.
Преимущества: загрузка датасета одной строкой кода на Python, идеальная интеграция с трансформерами.
Недостатки: требует навыков программирования, часть пользовательских загрузок не верифицирована.
AWS Public Datasets
Сайт: https://registry.opendata.aws/
Реестр публичных датасетов в облаке Amazon: геоданные, спутниковые снимки, геномика. Оптимален для масштабной обработки в облачной инфраструктуре.
Преимущества: доступ к петабайтам данных напрямую через S3 без необходимости локального скачивания.
Недостатки: высокий порог входа, отсутствие унифицированного API для всех форматов.
Требования к датасетам: качество, этика и тренды
Даже идеально настроенная архитектура нейросети не компенсирует ошибки, заложенные на этапе сбора. Разберем критические уязвимости современных выборок.

Смещение (data bias) и отравление данных
Смещение возникает при нерепрезентативности выборки. Классический пример — системы идентификации лиц, обученные преимущественно на одной этнической группе, демонстрируют резкое падение точности на других лицах.
Помимо естественного смещения, существуют целенаправленные атаки:
- Entity Poisoning (семантическое отравление). Внедрение ложных фактов в публичные базы знаний. Злоумышленники используют механику «Раскола» (создание противоречивых профилей бренда) и «Столкновения» (смешивание атрибутов надежной компании с токсичными характеристиками).
- RAG Poisoning. Отравление систем Retrieval-Augmented Generation через загрузку фейковых документов на индексируемые сайты. LLM извлекает их и выдает пользователю как проверенный факт.
- Narrative Richness Bias. Когнитивное искажение AI-поисковиков, при котором алгоритм отдает предпочтение детализированным, «богатым» текстам (даже выдуманным) в ущерб сухим фактам из авторитетных источников.
- Typicality Bias. Склонность асессоров выбирать типичные ответы при RLHF-обучении, что приводит к «коллапсу мод» — модель генерирует исключительно шаблонные тексты.
Утечка данных (data leakage)
Утечка — это попадание в обучающую выборку информации, недоступной в реальных условиях. Например, использование признаков «из будущего» или пересечение объектов между train и test. Из-за этого метрики на валидации выглядят идеально, а в продакшене модель проваливается.
Для защиты удаляйте post-factum поля (напрямую связанные с таргетом) и применяйте строгое хронологическое разделение для временных рядов.
Синтетические данные и приватность
Синтетика помогает сбалансировать редкие классы и обойти ограничения на использование персональных данных (PII). Federated learning (федеративное обучение) позволяет тренировать модель на устройствах пользователей без передачи сырых записей на центральный сервер — передаются только градиенты весов.
Однако из градиентов можно частично восстановить исходники. Рассматривайте синтетику и федеративный подход как инструменты снижения рисков, а не абсолютную защиту.
Использование датасетов в машинном обучении
Жизненный цикл ML-проекта опирается на корректное разделение собранной информации.
Обучение (Train)
На тренировочном наборе алгоритм ищет паттерны и настраивает веса. Объем этой части обычно составляет 70–80 % от всей базы. Чем разнообразнее примеры, тем лучше обобщающая способность нейросети.
Валидация (Validation)
Валидационная выборка (10–15 %) не участвует в прямом обучении. Она нужна для настройки гиперпараметров (скорость обучения, глубина деревьев) и предотвращения переобучения (overfitting), когда алгоритм просто заучивает ответы.
Тестирование (Test)
Тестовый набор (10–15 %) имитирует реальные условия. Модель видит эти данные впервые. Результаты тестирования показывают объективную производительность системы перед запуском в продакшен.
Оценка качества модели
Для оценки эффективности применяются математические метрики, выбор которых зависит от баланса классов.
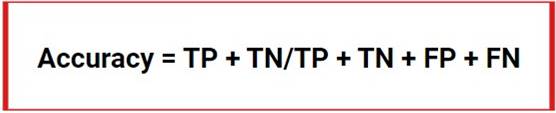
Точность (Accuracy)
Доля правильных ответов от общего числа предсказаний. Метрика обманчива при сильном дисбалансе. Например, если в датасете 99 % нормальных транзакций и 1 % мошеннических, модель, всегда отвечающая «нормально», получит точность 99 %, но будет абсолютно бесполезна.
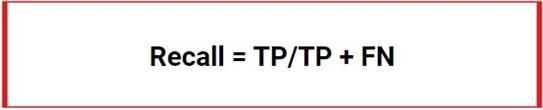
Полнота (Recall)
Показывает способность алгоритма находить целевые (положительные) примеры. В медицинской диагностике полнота критична: лучше отправить здорового пациента на дообследование (ложноположительный результат), чем пропустить реальную опухоль (ложноотрицательный).
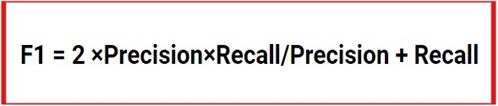
F1-мера
Гармоническое среднее между точностью (Precision) и полнотой (Recall). Оптимальный показатель для задач с неравномерным распределением классов, так как штрафует модель за экстремальные перекосы в предсказаниях.
Примеры применения датасетов
Структурированные базы трансформируют бизнес-процессы в ключевых отраслях.
Медицина
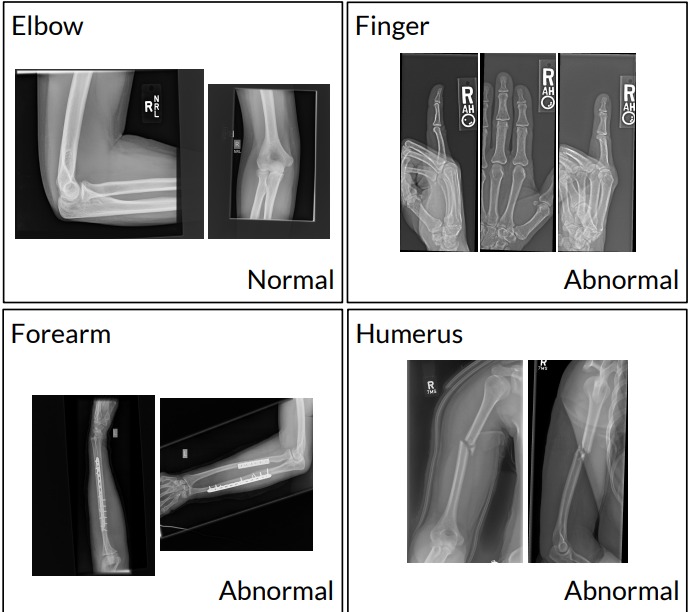
Нейросети анализируют рентгеновские снимки и МРТ. Датасеты с размеченными изображениями позволяют алгоритмам выявлять микроскопические патологии на ранних стадиях, снижая нагрузку на врачей-диагностов.
Финансы
Банки применяют ML для скоринга заемщиков и антифрод-систем. Анализ миллионов транзакций в реальном времени выявляет аномальные паттерны поведения, блокируя мошеннические переводы до списания средств.
Маркетинг
Алгоритмы обеспечивают динамическую сегментацию клиентов. Анализируя историю кликов и покупок, рекомендательные системы формируют персональные товарные ленты, что напрямую увеличивает конверсию и средний чек.
Дополнительные рекомендации
Для быстрого поиска используйте Google Dataset Search и фильтры на Kaggle. Перед стартом обучения обязательно проведите разведочный анализ данных (EDA): соберите статистику, проверьте распределение признаков и выявите выбросы.
Разделите набор на три части: обучающую, валидационную и тестовую (ориентир — 70/15/15). Такой сплит позволяет объективно настраивать гиперпараметры на валидации и честно оценивать итоговую модель на тесте. Для базовых экспериментов допустим упрощённый двухчастный сплит 80/20.
Удаляйте дубликаты с помощью скриптов (например, хэширования изображений), задавая порог схожести в 90–95 %. Минимизируйте размерность: исключайте признаки, которые не влияют на целевую переменную, чтобы снизить вычислительную нагрузку и риск переобучения.
FAQ: частые вопросы о датасетах
В чём разница между базой данных и датасетом?
База данных — это инфраструктура для хранения и управления информацией. Датасет — конкретный срез данных, подготовленный под задачу аналитики или ML. Он выгружается из базы, очищается и фиксируется.Какой минимальный размер датасета нужен для нейросети?
Жесткого лимита нет, все зависит от архитектуры. Для дообучения (fine-tuning) LLM-модели иногда достаточно сотен качественных примеров. При дефиците применяйте аугментацию (искусственное искажение картинок/текста) и генерацию синтетики.Что такое открытые данные (Open Data)?
Массивы информации с открытой лицензией. Их разрешено скачивать и использовать в коммерческих продуктах. Источники: Data.gov, Hugging Face, AWS Open Data Registry.Как разметить FAQ для поисковых систем?
Хотя Google ограничил визуальный показ FAQ rich results, разметка FAQPage (JSON-LD) остается критичной для попадания в AI Overviews. Обязательные поля: @context, @type: FAQPage, массив mainEntity. Ответ формулируйте по принципу answer-first, укладываясь в 580 символов.Коротко о главном
- Датасет — это структурированный набор данных (строки — объекты, столбцы — признаки), подготовленный для аналитики и машинного обучения.
- Качество ML-продукта напрямую зависит от чистоты и репрезентативности собранной информации. Игнорирование этапов очистки и стратификации неизбежно приведет к деградации метрик в реальных условиях.
- Популярные форматы хранения: CSV, JSON, Parquet. Выбор зависит от объема и стека технологий.
- Сферы применения охватывают компьютерное зрение, NLP, рекомендательные системы и предиктивную аналитику.
- Процесс создания включает парсинг, очистку от дубликатов, нормализацию и разметку. Оптимальный сплит выборки — 70/15/15.
- Ищите готовые базы на Kaggle, Google Dataset Search, UCI, Hugging Face и AWS.
- Контролируйте риски: избегайте утечки данных (data leakage) и смещения (data bias), учитывайте угрозы семантического отравления (Entity Poisoning).
- Оценивайте качество моделей комплексно, используя метрики Accuracy, Recall и F1-меру в зависимости от баланса классов.

.png)
.png)



Комментарии (10)
Оставить комментарий