

Данные называют новой нефтью, поскольку грамотно обработанная информация приносит компаниям реальную прибыль. Проводник между сырыми массивами и готовыми бизнес-решениями — Data Scientist. Это специалист, который извлекает инсайты и строит точные прогнозы на основе цифр.
- Что такое Data Science
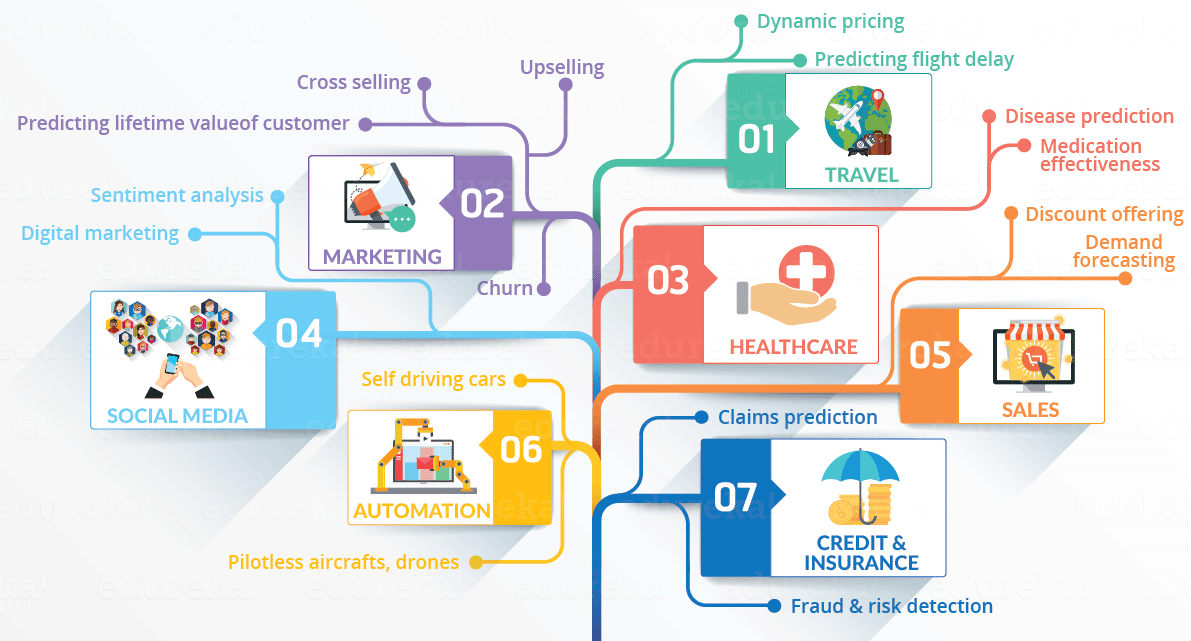
- Зачем и какому бизнесу нужна Data Science
- Кто такой специалист Data Science
- Чем занимается специалист по Data Science
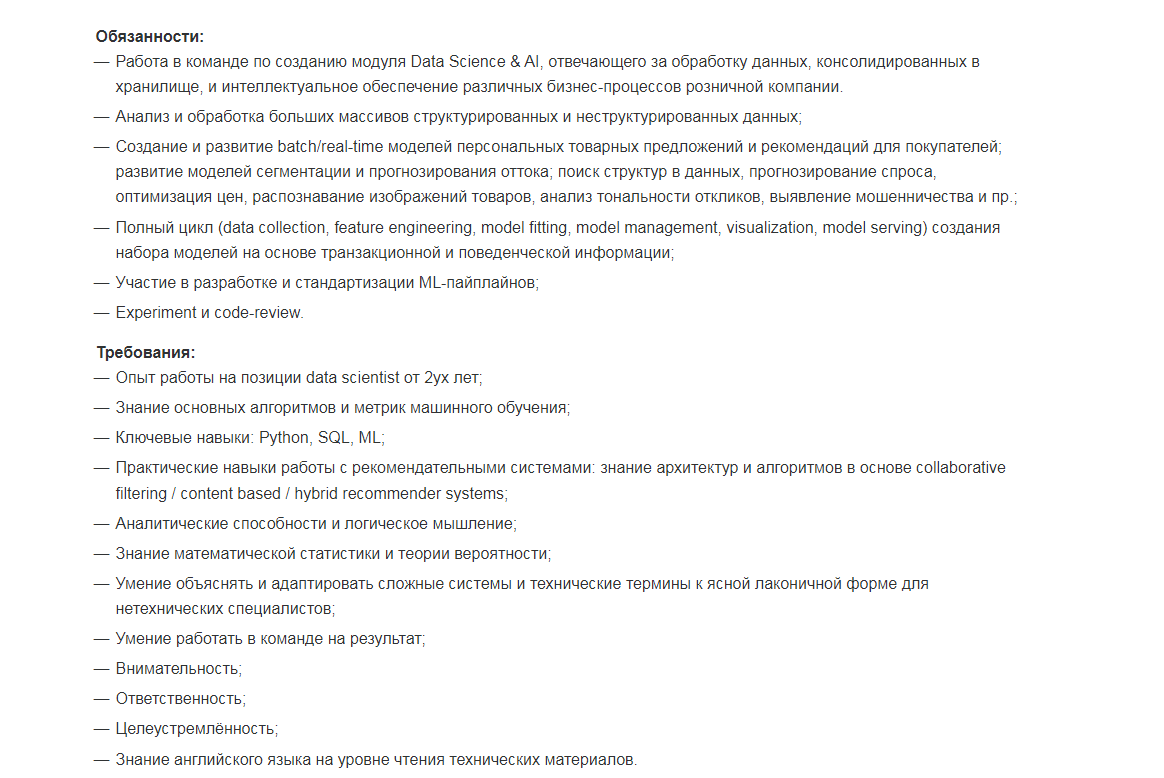
- Должностные обязанности специалиста по Data Science
- Карьерный путь в Data science: от Junior до Senior
- Где искать заказы специалисту Data Science
- Инструменты Data Science
- Что нужно знать специалисту Data Science дополнительно
- Data Scientist, Data Analyst, ML Engineer: а в чем разница?
- Сколько зарабатывает Data Scientist
- Востребованность профессии дата-сайентиста
- Тренды Data Science
- Как стать Data Scientist
- FAQ про Data Science
- Коротко о главном
Что такое Data Science
Data Science (дата сайнс) — междисциплинарная область, которая превращает данные в решения для бизнеса с помощью статистики, машинного обучения и программирования. Проще говоря, data science — это наука о данных: извлечение инсайтов и построение прогнозов на основе реальных датасетов.
Дисциплина базируется на системном анализе и высшей математике. Главный вопрос — как сделать зеттабайты информации полезными для экономики, от медицины до IT. Процесс включает очистку, парсинг и поиск скрытых закономерностей в огромных объемах зашумленных логов.
Специалисты профильного направления чаще всего полагаются на алгоритмы искусственного интеллекта.


Ключевые направления работы:
- Статистика. Изучение распределений и проверка продуктовых гипотез.
- Анализ данных. Препроцессинг raw-массивов для подтверждения или опровержения теорий.
- ИИ (искусственный интеллект). Тренировка нейросетей на исторических выборках.
Как Data Science преобразует наше восприятие реальности?
В чем разница: Data Science, AI, ML и Big Data
- AI (искусственный интеллект) — широкая концепция систем, имитирующих человеческий интеллект.
- ML (машинное обучение) — раздел AI: модели обучаются на данных для прогнозов и классификации.
- Big Data — технологии хранения и обработки очень больших и/или быстро меняющихся данных.
- Data Science — методология и практика применения статистики, ML и доменной экспертизы к данным под бизнес-цели.
Зачем и какому бизнесу нужна Data Science
Типичный кандидат на внедрение предиктивной аналитики — крупный бизнес, у которого:
- Накопились терабайты «сырой» информации. Беспорядочные логи не приносят пользы, требуются структурированные датасеты для стимулирования инноваций и оптимизации продуктов.
- Выделен бюджет на эксперименты. Мало подготовить инфраструктуру, необходимо перестроить внутренние процессы на основе новых алгоритмов.
- Компания работает в ecommerce, финансах, логистике, промышленности или телекоме. Для этих сфер экономики уже существуют готовые ML-решения.
| Бизнес-задача | Решение Data Science | Результат (ROI/метрики) |
|---|---|---|
| Снижение оттока клиентов | Скоринг оттока (классификация) и удерживающие кампании | Churn Rate, Retention, uplift vs A/B-контроль, LTV |
| Гиперперсонализация и рекомендации | Рекомендательные модели/ранжирование (Recsys) | CTR/CR, AOV, GMV, Precision@K/NDCG |
| Прогноз спроса и ценообразование | Прогноз временных рядов/регрессия, динамическая цена | MAPE/RMSE, out-of-stock, оборачиваемость, маржа |
Автоматизация бизнес-процессов на базе LLM
Компании активно встраивают большие языковые модели (LLM) во внутренние процессы: генерируют управленческую отчетность, авторазмечают тикеты, создают ассистентов для аналитиков (черновики SQL-запросов). Важно соблюдать принципы приватности. Используйте деперсонализацию (Data Sanitization) — маскируйте PII перед отправкой промпта в API. Для корпоративного сектора эффективны локальные LLM и строгое разграничение прав доступа с логированием операций.
Кто такой специалист Data Science
Наука о данных включает в себя несколько дисциплин для максимально точного изучения любых необработанных типов информации.
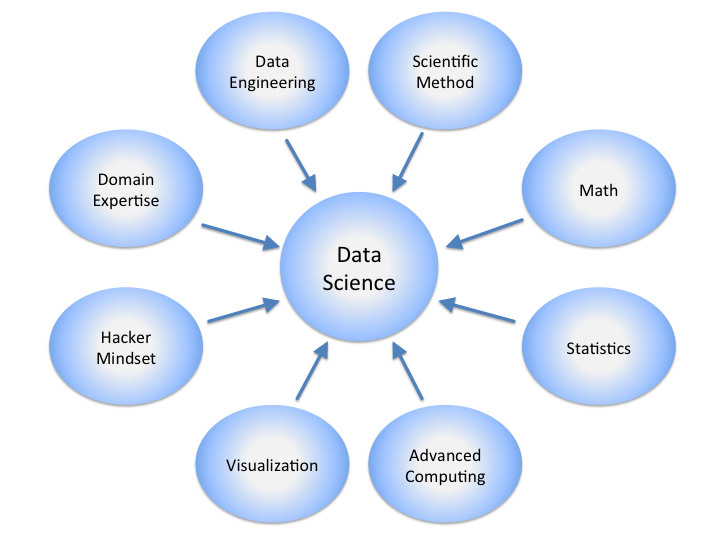
Дата-сайентист — разработчик, который собирает, организует и анализирует датасеты, устанавливает закономерности и проверяет гипотезы. Data Scientist (дата сайентист) — это специалист по науке о данных; если коротко, data scientist что за профессия — это про превращение сырых логов в проверяемые выводы и прототипы моделей под бизнес-цели. Одни фокусируются на узких нишах, другие работают как Full-stack инженеры, охватывая математику, передовые вычисления и визуализацию.

Задача сотрудника — корректно проанализировать цифры исходя из главной цели бизнеса. Типичный эксперт обладает сильной математической базой и опытом применения нескольких языков программирования. К джентльменскому набору относятся SQL, R и Python.
Не путайте дата-сайентиста с бизнес-аналитиком. Последний работает преимущественно с коммерческими показателями: оценивает успешность продвижения в каналах, анализирует воронку продаж или проверяет метрики окупаемости.
Также есть разница с дата-инженером. Инженер занимается физической добычей, настраивает выгрузку и объединяет источники. Сайентист — проверяет гипотезы и создает алгоритмы.
Чем занимается специалист по Data Science
Рассмотрим жизненный цикл разработки ML-решений:
- Сбор данных и цели: источники, качество, согласование KPI и гипотез с бизнесом.
- EDA и подготовка: очистка, обработка пропусков и аномалий, фичи, честные разбиения (по времени или группам).
- Проектирование и обучение: выбор алгоритмов (включая AutoML), валидация, метрики под бизнес-цель.
- Внедрение и мониторинг: API/батч-доставки, CI/CD, контроль качества и дрейфа данных, алерты и цикл обратной связи.
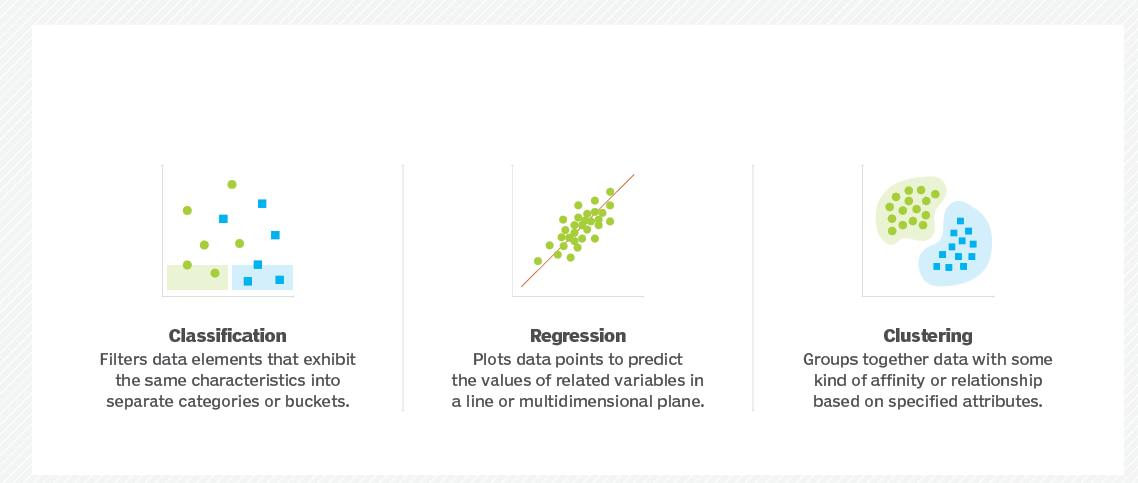
Сотрудник ищет скрытые паттерны и формирует прогнозные алгоритмы на основе пользовательского поведения. Находя связи, он тестирует и внедряет ML-модели в продакшен.
Должностные обязанности специалиста по Data Science
Стек задач зависит от компании. В банке упор делается на кредитный скоринг, в ритейле — на рекомендательные системы. Однако базовый пул обязанностей стандартизирован.
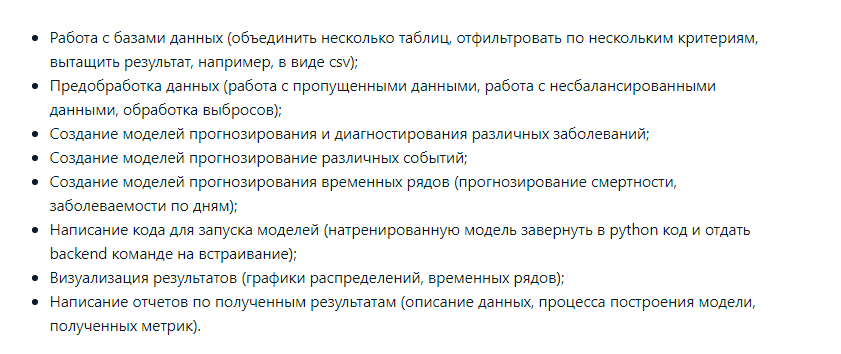
Основные задачи:
- Тщательный анализ ТЗ от заказчика.
- Проектирование и тестирование базовой функциональности алгоритма.
- Сопровождение и мониторинг запущенной модели.
- Поэтапный деплой в рабочие процессы.
- Разметка и препроцессинг полученных от дата-инженера массивов.
- Оценка экономического эффекта (ROI) от внедрения.
- Формирование KPI для оценки точности прогнозов.
Перед стартом необходимо оценить рентабельность: машинное обучение решает далеко не все проблемы.
Не нужно начинать работу, если проблема заведомо проигрышная или не окупает затрат на инфраструктуру.
Карьерный путь в Data science: от Junior до Senior
Разделим каждый грейд по типичным задачам и нужным скиллам.
Junior data scientist
- Типичные задачи. Сбор и очистка, разведочный анализ (EDA), базовые алгоритмы, помощь в постановке A/B-тестов.
- Hard-скиллы. Python, SQL, pandas, NumPy, scikit-learn, основы статистики, Git.
- Soft-скиллы. Дисциплина, быстрая обучаемость, умение формулировать выводы.
Middle data scientist
- Типичные задачи. Дизайн экспериментов, настройка гиперпараметров, продвинутая валидация, взаимодействие с ML-инженерами над пайплайнами.
- Hard-скиллы. XGBoost, LightGBM, PyTorch (прототипы), DVC, MLflow, основы MLOps.
- Soft-скиллы. Приоритизация, работа с неопределенностью, перевод целей в метрики.
Senior data scientist
- Типичные задачи. Постановка задач с заказчиком, архитектура решения, управление рисками, менторство, контроль качества и сроков.
- Hard-скиллы. Архитектура высоконагруженных систем, фреймворки продакшена, мониторинг дрейфа данных, безопасность.
- Soft-скиллы. Лидерство, защита решений на языке денег.
Где искать заказы специалисту Data Science
Обычно эксперты работают в штате (in-house), решая задачи по строгому техническому заданию. Внештатные форматы существуют, но корпорации предпочитают инхаус-команды из-за NDA и сложности инфраструктуры.
Биржи фриланса
Искать разовые проекты можно на этих площадках:
- Workzilla.
- Upwork.
- Weblancer.
- AngelList.
- Indeed.
- Freelancehunt.
- Freelancer.
- Freelance.ru.
- Kaggle.
- Peopleperhour.
Доски объявлений
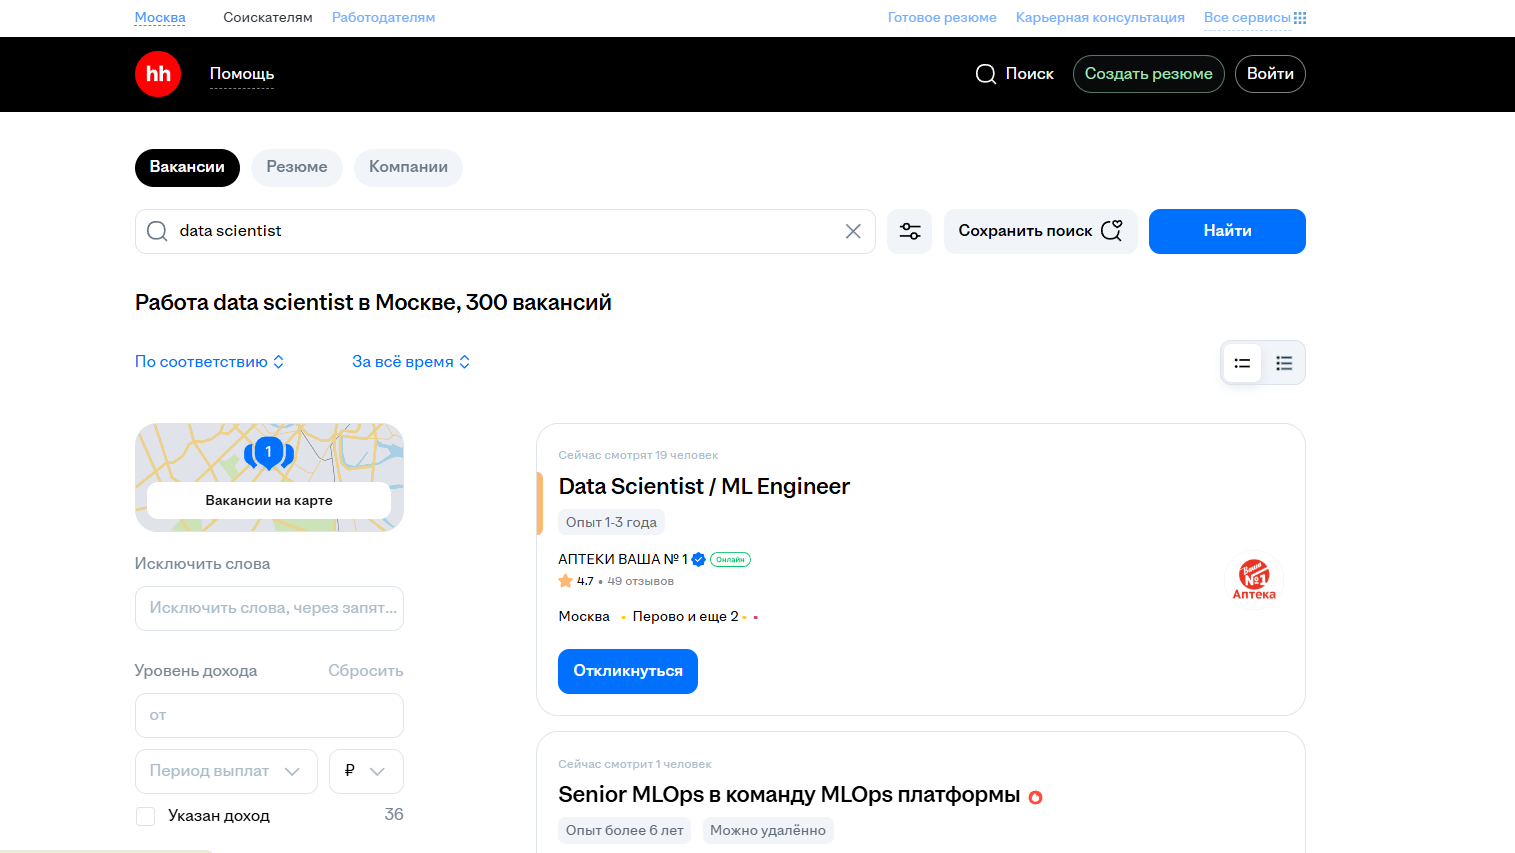
Традиционные агрегаторы — hh.ru, rabota.ru, superjob.ru. Крупные российские компании хантят специалистов именно здесь.
Сайты profi.ru и YouDo
Зарегистрируйте профиль и укажите специализацию. На profi.ru сейчас зарегистрировано более 4 000 программистов, готовых брать точечные задачи.
Telegram-каналы
Найти работу можно в профильных сообществах:
- Analyst_job
- Datasciencejobs
- Foranalysts
- Progjob
- Alenavladimirskaya
- Careerspace
- Solvery
- Myjobit
- Budujobs
- Jobforjunior
- ITlenta
- Jobskolkovo
- Remoteit
- Djinni_jobs_bot
- Forfrontend
- Seohr
- Theyseeku
- Distantsiya
- Antirabstvoru
- Remotejobss
- Yojob
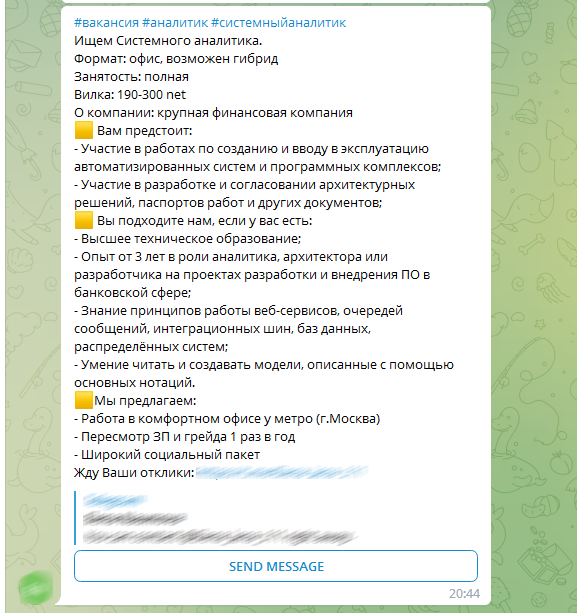
Если ищете вакансию в российской компании, мониторьте «Хабр Карьеру». Там регулярно публикуют предложения для Middle+.
Инструменты Data Science
Основным инструментом остается Python. На нем выполняется большинство этапов: парсинг, тестирование, написание скриптов, обучение нейросетей. Запросы к базам оформляются на SQL. Инженерам машинного обучения дополнительно требуется знание C++.
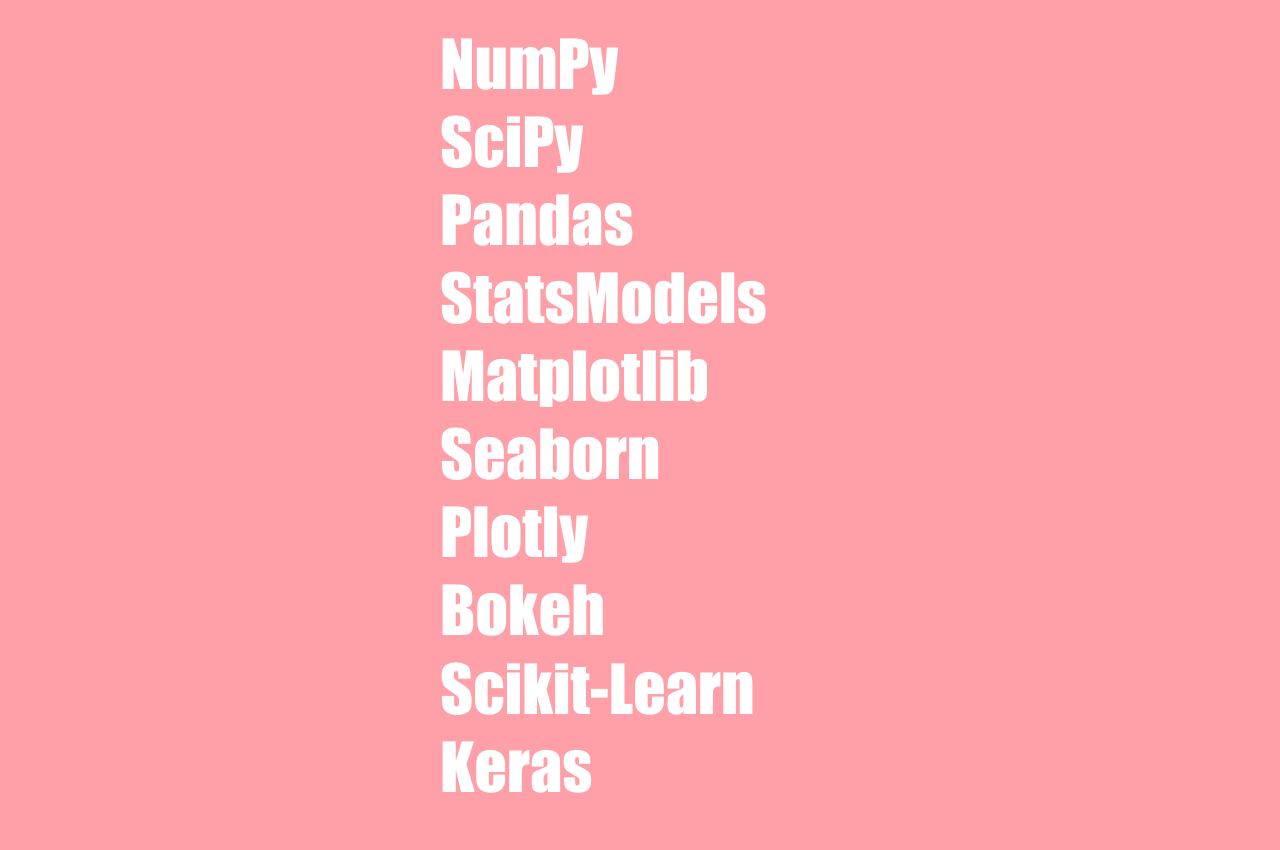
Язык R ценится за качественную визуализацию, но Python обладает более простым синтаксисом и мощными библиотеками. Рассмотрим актуальный стек технологий.
Контейнеризаторы приложений
Для продуктивизации ML и создания платформ необходимо владеть Docker и Kubernetes.

Sandbox
Интерактивный блокнот Jupyter Notebook незаменим для отладки скриптов, аналитических сводок, разведочного анализа (EDA) и визуализации распределений.
Работа с pipeline и его настройка
Пайплайн (конвейерная обработка) разбивает процесс на параллельные подоперации. Отраслевой стандарт — Apache Airflow. Альтернатива — фреймворк Luigi.
Machine Learning и создание ML-моделей
Библиотеки подбираются под конкретную задачу разработчика:
- ИНС: Keras, TensorFlow.
- Одиночные алгоритмы: scikit-learn.
- NLP (текст): NLTK.
- Классификация/регрессия: LightGBM, XGBoost.
- Интерпретация: DiCE, SHAP.
Среда разработки
Оптимальный выбор — PyCharm. Среда поддерживает Django, графический отладчик и юнит-тесты. Позволяет контролировать чистоту синтаксиса, проводить рефакторинг и интегрируется с Git.
Базы данных
Минимальный набор: PostgreSQL, Oracle, MySQL. Для аналитики потребуется ClickHouse или Vertica. Плюсом станет опыт работы с Greenplum и экосистемой Hadoop (HDFS).
Облачные инструменты
Необходимы навыки работы с Google Cloud Platform, AWS (S3, Redshift). Облачные вычисления — стандарт для тренировки тяжелых нейросетей.
EDA и визуализация данных
Для отрисовки графиков в песочнице применяются Plotly, Matplotlib и Seaborn.
Что нужно знать специалисту Data Science дополнительно
- Английский язык. Чтение документации и профильных статей (arXiv).
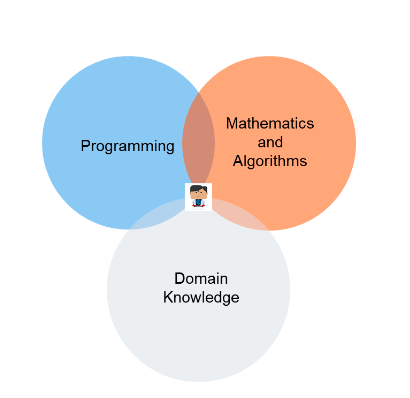
- Высшая математика. Линейная алгебра, теория вероятностей, математическая статистика.
- Предметная область (Domain knowledge). Оценка рисков в страховании кардинально отличается от логистики. Требуется погружение в специфику бизнеса.
- Дополнительные языки. Java или C++ для высоконагруженных систем.
Data Scientist, Data Analyst, ML Engineer: а в чем разница?
- Data Scientist — строит и проверяет предиктивные модели под бизнес-цель.
- Data Analyst — отвечает за продуктовую аналитику, дашборды и эксперименты, фокус на SQL и BI-инструментах.
- ML Engineer — превращает прототипы в стабильные высоконагруженные сервисы.
Сводная таблица компетенций:
|
Роль |
Основная задача |
Инструменты |
Результат работы |
Требуемые навыки |
|
Data Scientist |
Прогнозы и рекомендации под KPI бизнеса |
Python, scikit-learn, XGBoost, SQL, PyTorch |
Рост метрик продукта, точности моделей |
Статистика, фичеинжиниринг, честная валидация, дизайн экспериментов |
|
Data Analyst |
Аналитика продукта, отчетность |
SQL, Excel, Power BI или Looker Studio |
Дашборды, инсайты для решений |
Продуктовая аналитика, визуализация, A/B-эксперименты |
|
ML Engineer |
Продакшен моделей |
Python, Docker, Kubernetes, Airflow, MLflow |
Надежный сервис, постоянный мониторинг качества |
MLOps, масштабирование, оптимизация затрат и задержек |
Сколько зарабатывает Data Scientist
Приведу актуальную статистику по рынку труда на основе Хабр Карьеры, hh.ru и Geeklink.
По данным Хабр Карьеры, медианная зарплата Data Scientist по России составляет 240 000 ₽. Средний доход распределяется так: Junior (до 1,5 лет) получает около 136 000 ₽, Middle (2–4 года) — 248 000 ₽, а Senior (от 4 лет) — 391 000 ₽.
Агрегатор Geeklink показывает схожую динамику: средняя зарплата по РФ держится на уровне 252 000 ₽ с небольшим годовым приростом.
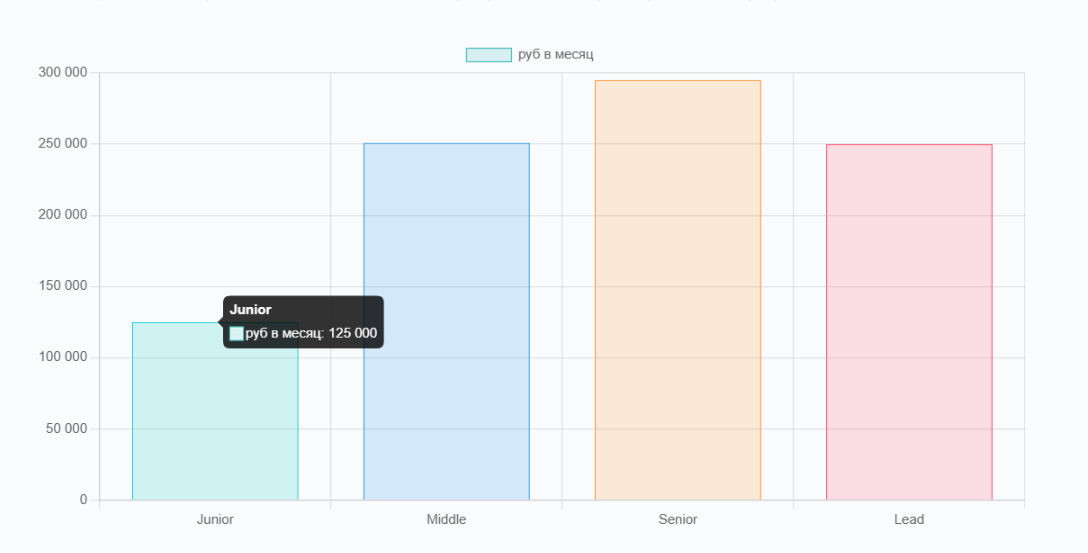
На HeadHunter в Москве и Санкт-Петербурге Middle-специалисты могут рассчитывать на вилку 230–330 тысяч ₽. Позиции Senior с опытом 3–6 лет в топ-отраслях (финтех, e-commerce) доходят до 400 тысяч ₽ и выше.
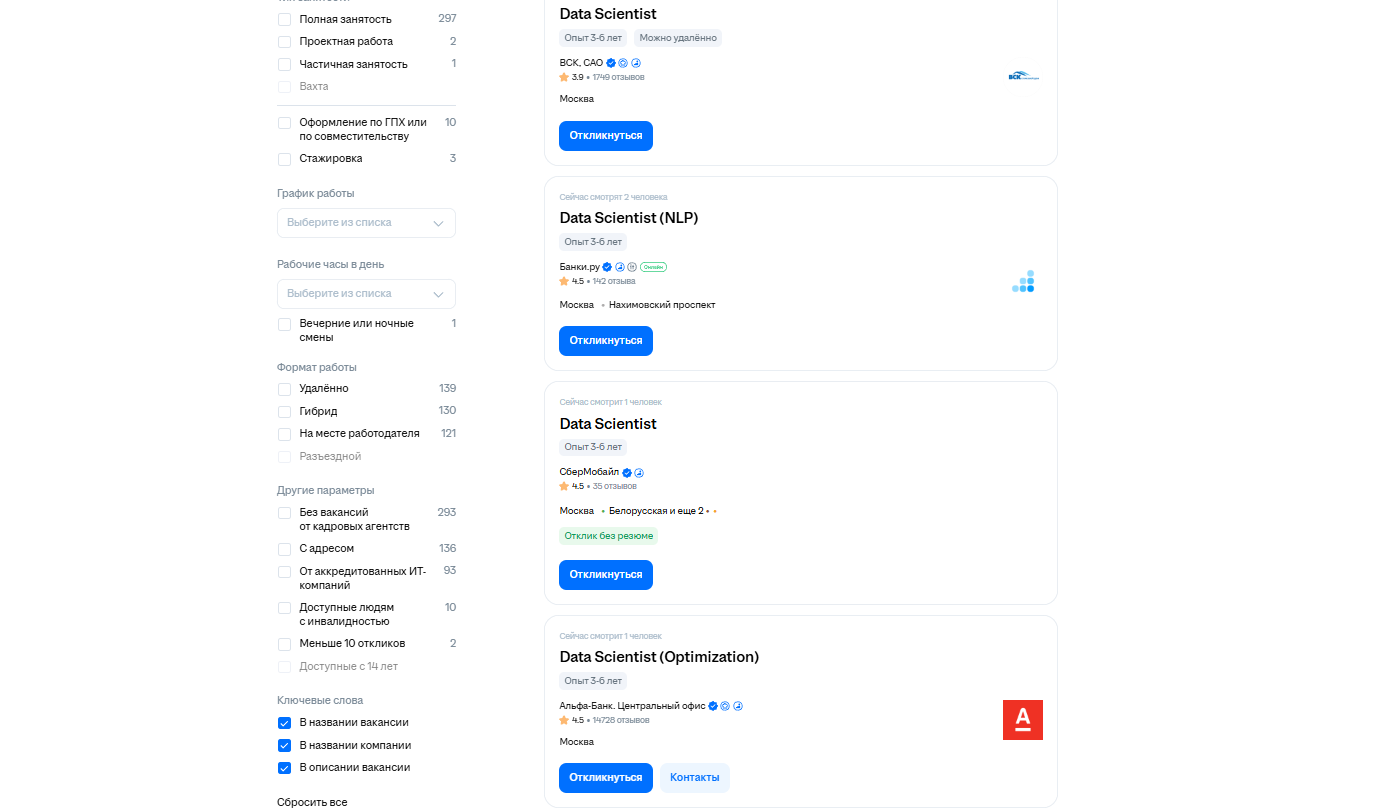
Итоговая вилка по рынку РФ:
- Junior: 120–180 тысяч ₽ (часто старт через стажировки).
- Middle: 230–330 тысяч ₽.
- Senior: 350–600 тысяч ₽ (максимум в финтехе и AI-продуктах).
Востребованность профессии дата-сайентиста
В мире циркулирует более 175 зеттабайт информации. Маршруты навигаторов, поисковые запросы, транзакции во «ВКонтакте» — все это анализируется корпорациями для оптимизации продуктов.
Абсолютно любой цифровой след тщательно отслеживается сотнями компаний для формирования персонализированных предложений.
Факты о востребованности:
- Профессия стабильно входит в топы рейтингов ВЭФ.
- Сотни открытых вакансий на профильных HR-порталах (hh.ru, rabota.ru).
- Острый дефицит кадров уровня Middle+.
Тренды Data Science
Аналитика позволяет создавать прорывные продукты и минимизировать риски. Рассмотрим ключевые направления развития отрасли.
Проверка гипотез и установление самых эффективных вариантов — область, где наука о данных показывает себя наилучшим образом.
1. Бум облачной миграции
Бизнес переносит локальные приложения в контейнеры из-за необходимости масштабирования. Хранилища, ETL-процессы и аналитика мигрируют в гибридные облака.
2. Рост прогнозной аналитики
Предиктивные алгоритмы предсказывают тенденции на основе исторических логов. Это фундамент для принятия взвешенных управленческих решений.
3. Авто-ML
AutoML автоматизирует рутинные этапы: очистку, подбор гиперпараметров, построение базовых нейросетей, экономя часы рабочего времени.
4. TinyML
Сжатие сетей глубокого обучения для работы на маломощном оборудовании (IoT). Решает проблему нехватки вычислительных мощностей на конечных устройствах.
5. Лучшее регулирование данных
С проникновением ИИ в медицину и финтех ужесточаются требования к конфиденциальности. Анонимизация и шифрование становятся обязательным этапом пайплайна.
6. ИИ как услуга (AIaaS)
Облачные провайдеры предоставляют готовые API для распознавания текста, речи и компьютерного зрения, снижая порог входа для малого бизнеса.
7. Сложность обучающих данных
Огромные массивы остаются «темными» — хранятся без пользы. Трансферное обучение и генеративно-состязательные сети (GAN) помогают синтезировать недостающие выборки для тренировки.
8. LLM в аналитике и MLOps
Большие языковые модели ускоряют EDA, генерацию кода и подготовку отчетов. В продакшене растет роль мониторинга качества LLM-ответов, приватности данных и контроля источников (audit-трейлы).
Математика для Data Science — обширная тема. Мне близка мысль, что «Data Science — это математика для бизнеса».
Юрий Кашницкий — Staff GenAI Solutions Architect в Google Cloud
Как стать Data Scientist
Подготовил пошаговый план без лишней теории. Примеры будут из маркетинга: конверсия, удержание, выручка.

Шаг 0. Подготовка среды
- Установите Python и Jupyter Notebook (дистрибутив Anaconda).
- Установите VS Code.
- Создайте папку DS_учеба и файл план_обучения.md.
- Зарегистрируйтесь на GitHub.
Шаг 1. Основы математики и статистики
Неделя 1. Базовая статистика
Изучите среднее, медиану, квартили, выбросы. Загрузите таблицу заказов в Google Sheets, посчитайте средний чек и разброс.
Неделя 2. Теория вероятностей
Разберитесь с шансом события и риском ошибки. Прикиньте вероятность повторной покупки для разных сегментов клиентов.
Неделя 3. Гипотезы и A/B-тесты
Освойте p-value, ошибки первого и второго рода. Смоделируйте тест «новая кнопка увеличит конверсию».
Неделя 4. Линейная алгебра
Поймите векторы и матрицы. В Jupyter Notebook с NumPy измените масштаб числовых столбцов.
Шаг 2. Программирование: Python и SQL
Неделя 1. Основы Python
Переменные, списки, словари, циклы. Посчитайте выручку по неделям на сырых данных в CSV.
Неделя 2. Библиотеки для данных
Pandas, NumPy, Matplotlib. Почистите пропуски, постройте график распределения среднего чека.
Неделя 3. SQL-запросы
SELECT, WHERE, GROUP BY, JOIN. Выполните запросы к локальной БД (топ категорий, средний чек по каналам).
Неделя 4. Отчет маркетинга
Соберите данные, визуализируйте, напишите рекомендации для менеджера.
Шаг 3. Постигаем машинное обучение
Неделя 1. Первая ML-модель
Разделение на train/test. Соберите логистическую регрессию для прогноза оттока.
Неделя 2. Градиентный бустинг
Обучите XGBoost или LightGBM, сравните метрики с базовой моделью.
Неделя 3. Работа с текстом (NLP)
TF-IDF. Обучите классификатор тональности отзывов.
Неделя 4. Оценка качества
Кросс-валидация, Accuracy, ROC-AUC, RMSE. Объясните метрику бизнесу.
Шаг 4. Работаем на практику. Портфолио
- Соберите три проекта с бизнес-ценой (прогноз спроса для платного трафика, рекомендации).
- Опишите проблему, шаги, метрики и экономию.
- Оформите один проект как мини-сервис (Streamlit).
- Участвуйте в Kaggle.
- Ищите стажировку или волонтерский кейс.
- Соберите портфолио на GitHub с описанием кейсов.
Сколько времени займет обучение
При занятиях 1–1,5 часа в день до первой стажировки проходит от 3 до 6 месяцев.
Чек-лист готовности к первому собеседованию
- Умею ставить гипотезу, проверять ее A/B-тестом, объяснять p-value.
- Свободно читаю таблицы в pandas, пишу базовые SQL-запросы.
- Обучил две модели на реальной задаче, объяснил результат менеджеру.
- Есть три оформленных проекта на GitHub.
Pet-проекты — благо. Запереться и пройти всю Coursera — недальновидный план: вам не будет не хватать командной работы.
Юрий Кашницкий — Staff GenAI Solutions Architect в Google Cloud
FAQ про Data Science
Можно ли стать дата-сайентистом без высшего образования?
Да. Важно портфолио, математика на прикладном уровне, Python в связке с SQL. Диплом помогает, но не обязателен.
Сколько времени занимает обучение?
При интенсивной траектории — 6-12 месяцев до Junior. До уровня Middle — еще 1-2 года практики.
Нужно ли «много высшей математики»?
Глубокая математика нужна не всегда, но базис (линейная алгебра, вероятность, статпроверки) — обязателен для понимания моделей.
Kaggle обязателен?
Нет, но это быстрый способ прокачать валидацию и эксперименты.
Чем отличается работа в стартапе и энтерпрайзе?
В стартапе шире зона ответственности, в корпорации — глубже специализация и строгие MLOps-процессы.
Что такое обработка персональных данных в DS и как соблюдать закон?
Это любые операции с данными, позволяющими идентифицировать человека. Минимизируйте сбор полей, используйте анонимизацию и псевдонимизацию, храните и передавайте персональные данные по защищенным каналам, ведите учет согласий и доступов. Для РФ ориентируйтесь на ФЗ-152 и внутренние регламенты безопасности.
Коротко о главном
- Data Scientist помогает бизнесу принимать решения на основе цифр: прогнозирует спрос, настраивает рекомендации и снижает отток.
- Фундамент профессии — математика, статистика, Python и SQL.
- Грамотная валидация и A/B-тесты важнее сложных нейросетей.
- Реальные проекты на GitHub ценятся работодателями выше сертификатов.
- Главный навык — умение переводить технические метрики в финансовые показатели.
.png)
.png)



Комментарии (5)
Оставить комментарий